免责声明。 本文完全基于 Revolut 的公开沟通 — 他们的工程博客、会议演讲、招聘信息、年报和外部案例研究。这不是一份 Revolut 官方架构文档。我们建模公开已知的内容,以说明一个复杂技术栈如何能用 C4 模型变得清晰易读。当某些细节是推断而非 Revolut 明确陈述时,我们会注明。
Transfer 的解剖学:用 Archyl 以 C4 建模 Revolut
巴黎,某个周五晚上 19:47。Léa 打开 Revolut,输入 450 英镑,从联系人里选中她的伦敦房东,点下 Send。她的欧元以银行间汇率换成英镑,通过欺诈和制裁筛查,写入一个不可变的 ledger,然后推上英国的 Faster Payments 支付网络。在 Léa 把手机放回口袋之前,房东的商业银行已经把钱入账了。
这段三秒钟的旅程穿越了一个移动 app、一个 API 边缘层、一个转账编排器、一个 FX 引擎、一条预算低于 50 毫秒的金融犯罪流水线、一个事件存储,以及一个外部的国家级支付网络 — 全部由一家十一年前还不存在的公司运营。
数字里的 Revolut
| 客户 | 7000 万+(2026 年 5 月),高于 2024 年 11 月的 5000 万 |
| 2025 年营收 | 60 亿美元(同比 +46%),税前利润 23 亿美元 |
| 交易量 | 2025 年 1.3 万亿英镑(同比 +65%) |
| 估值 | 750 亿美元 |
| 覆盖范围 | 40 多个国家 — 英国 1300 万客户、西班牙 600 万、法国 500 万 |
| 欺诈损失 | 每处理 100 美元约 1 美分,而行业平均为 7–8 美分 |
| 核心技术栈 | Java 17/21 与 Kotlin、PostgreSQL、GCP、Kubernetes — 以及众所周知的 没有 Kafka |
如何理解一个每年流转 1.3 万亿英镑的技术栈?和我们在本系列中对待 Stripe、Netflix 和 Uber 的方式一样:你不能 — 不能一次理解。你跟随 一个用户动作 穿越四个 C4 层级,撰写解释一路上遇到的决策的 ADR,并以一张标明每个盒子归谁所有的地图作为结尾。
Léa 的 450 英镑就是我们的线索。
层级 1 — System Context:一家银行、一个券商、一个交易所,和一个应用商店
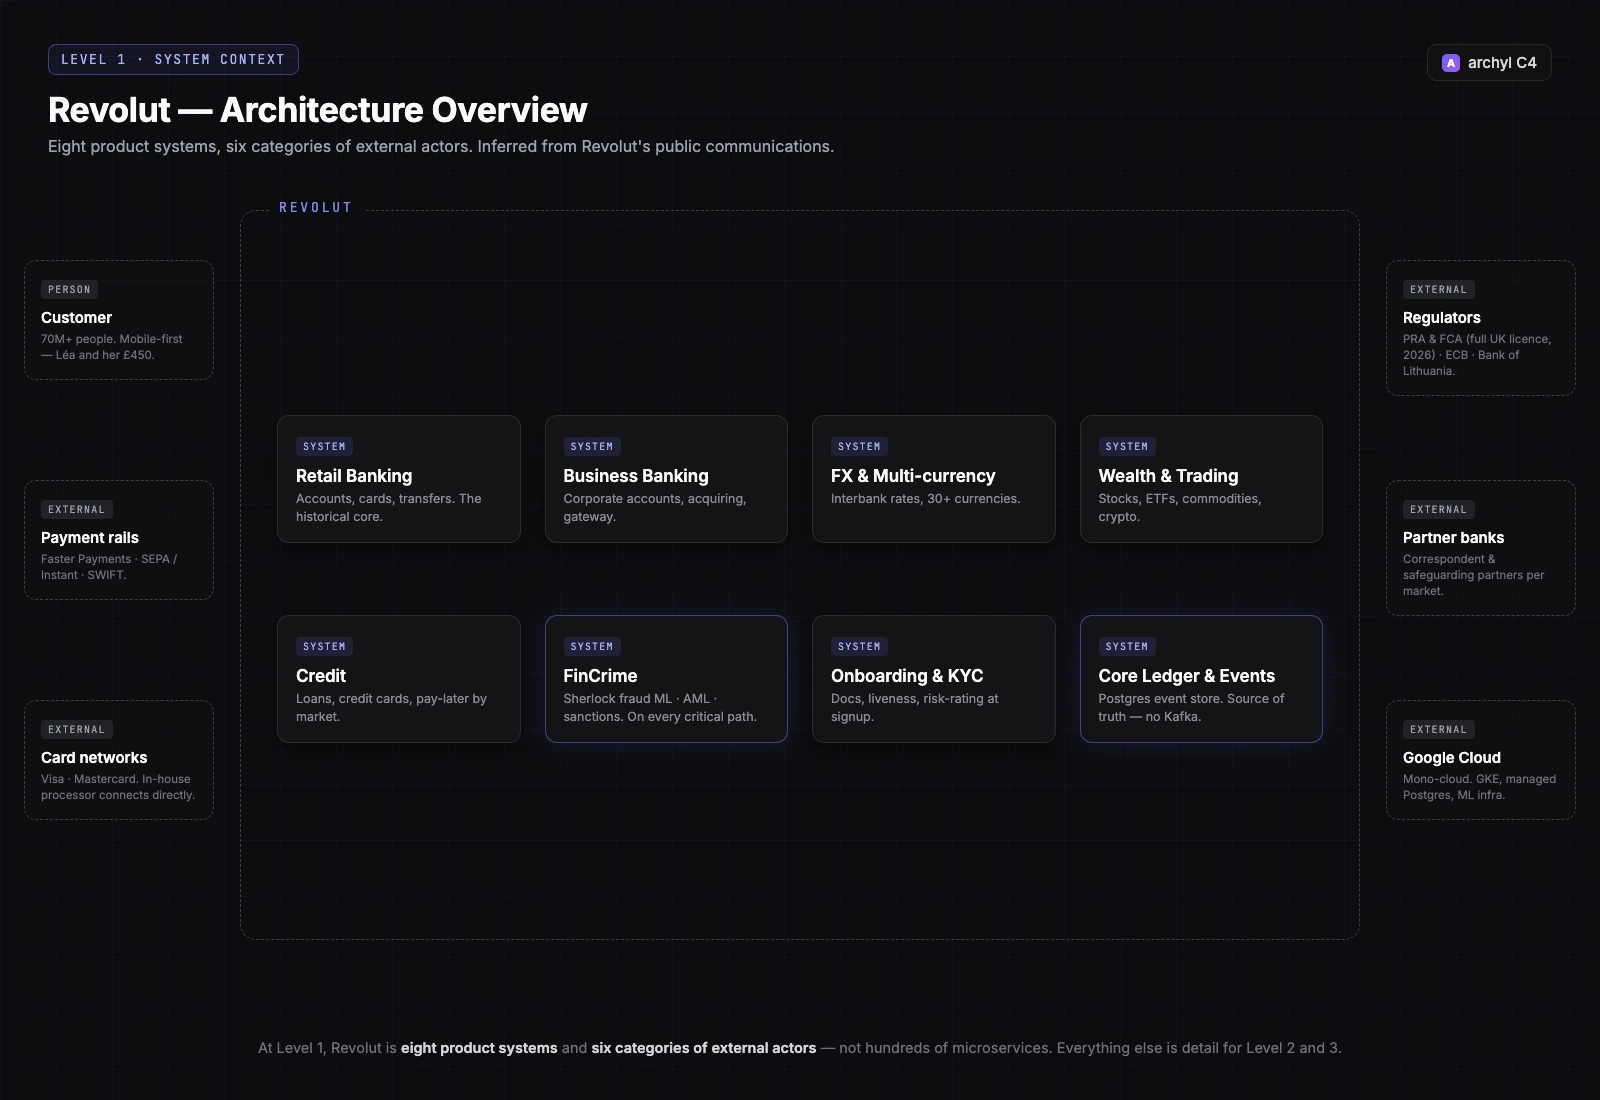
在 System Context 层级,Revolut 不是"一个银行 app"。公开沟通描述了至少八个共享同一基础的产品系统:
- Retail Banking — 多币种账户、卡、转账:历史核心
- Business Banking — 账户、企业卡,以及拥有自己支付网关的商户收单业务
- FX & Multi-currency — 让 Revolut 成名的兑换引擎,覆盖 30 多种货币的银行间汇率
- Wealth & Trading — 股票、ETF、大宗商品、加密货币
- Credit — 按市场提供的个人贷款、信用卡、先买后付产品
- FinCrime — 欺诈评分(Sherlock)、AML、制裁筛查、诈骗检测
- Onboarding & KYC — 证件验证、活体检测、注册时的风险评级
- Core Ledger & Event Backbone — 每个产品都写入的 source of truth
围绕它们:卡组织(Visa、Mastercard)、支付网络(英国 Faster Payments、SEPA 和 SEPA Instant、覆盖长尾的 SWIFT)、合作银行与代理行、监管机构(英国的 PRA 和 FCA — Revolut 在 2024 年 7 月的受限牌照之后,于 2026 年 3 月获得完整的英国银行牌照;欧盟的 ECB 和立陶宛央行)、为 Wealth 服务的行情数据和经纪合作伙伴,以及作为底层基础设施的 Google Cloud。
八个系统、六类外部参与者。其余都是细节。
注意层级 1 已经告诉你一件任何组织架构图都不会告诉你的事:FinCrime 是一个 系统,不是一个功能。它坐在每个产品的关键路径上 — 零售转账、卡支付、加密货币提现、企业付款。当一家公司画出它的 context 图,而其中一个盒子被来自四面八方的箭头指向时,那个盒子要么是皇冠上的明珠,要么是瓶颈。在 Revolut,它两者都是,他们也据此配置了人员。
ADR-001 · 事件驱动骨干 — 但没有 Kafka
状态 · Accepted(约 2017 年,2026 年依然活跃)
背景 · Revolut 的后端是数百个通过交换事件来协调的独立微服务。2017 年(可以说直到今天)行业的默认答案是 Apache Kafka。但 Kafka 带来沉重的运维面:broker、partition、rebalancing、retention 调优 — 一个全职的平台级关注点。Revolut 的工程文化偏好小团队拥有简单、可查询的原语。
决策 · 不采用 Kafka。把事件持久化到一个 建立在 PostgreSQL 上的事件存储,并在内部自建 streaming 和消息层 — 用 Kotlin 基于 JetBrains Ktor 编写,使用 coroutines 实现高并发事件投递。Risk、PnL 和欺诈检测等消费者从存储中读取,由只读副本吸收查询负载。
后果 · 事件骨干可由一个小团队维护,而且 — 关键地 — 可以用 SQL 查询。调试一笔支付不是在分区日志里探险;它是一条 SELECT。代价是真实的:Revolut 自己承担了 Kafka 本可以开箱提供的可用性、排序和投递语义。这是一个只有在拥有该平台的团队持续保持卓越时才正确的决策。
在 Archyl 中,这条 ADR 连接到 Core Ledger & Event Backbone 系统以及每个向其发布事件的 container。谁问"为什么这张图里没有 Kafka?" — 而每个资深新人都会问 — 一次点击就能得到答案。
那三秒钟,放到时间线上
在深入层级 2 之前,先把 Léa 的转账放到时间线上。(延迟数字是量级示意,不是 Revolut 发布的数据。)
| t | 发生了什么 | 在哪里 |
|---|---|---|
| 0 ms | Léa 点下 Send | 移动 app |
| ~10 ms | 会话校验,请求认证并解析 | API 边缘层 |
| ~30 ms | 余额检查与资金预留,事务性完成 | 转账编排器 + Ledger(PostgreSQL) |
| ~50 ms | EUR→GBP 以银行间汇率报价 | FX 引擎 |
| ~100 ms | 制裁筛查 + 欺诈/诈骗评分 — 那个低于 50 ms 的预算 | FinCrime 流水线 |
| ~150 ms | TransferInitiated 追加到事件存储;Risk、PnL、通知和分析消费它 |
事件骨干 |
| ~200 ms | 支付提交到 Faster Payments | FPS 网络连接器 |
| ~2–3 s | 接收行确认;ledger 最终确定;推送通知发出 | 支付网络 + Ledger + 通知 |
八跳,其中三跳是不可逆的副作用(预留资金、提交到支付网络、最终确定 ledger)。记住这个结构 — 这正是 Container 层级需要呈现出来的东西。
层级 2 — Container:深入转账路径
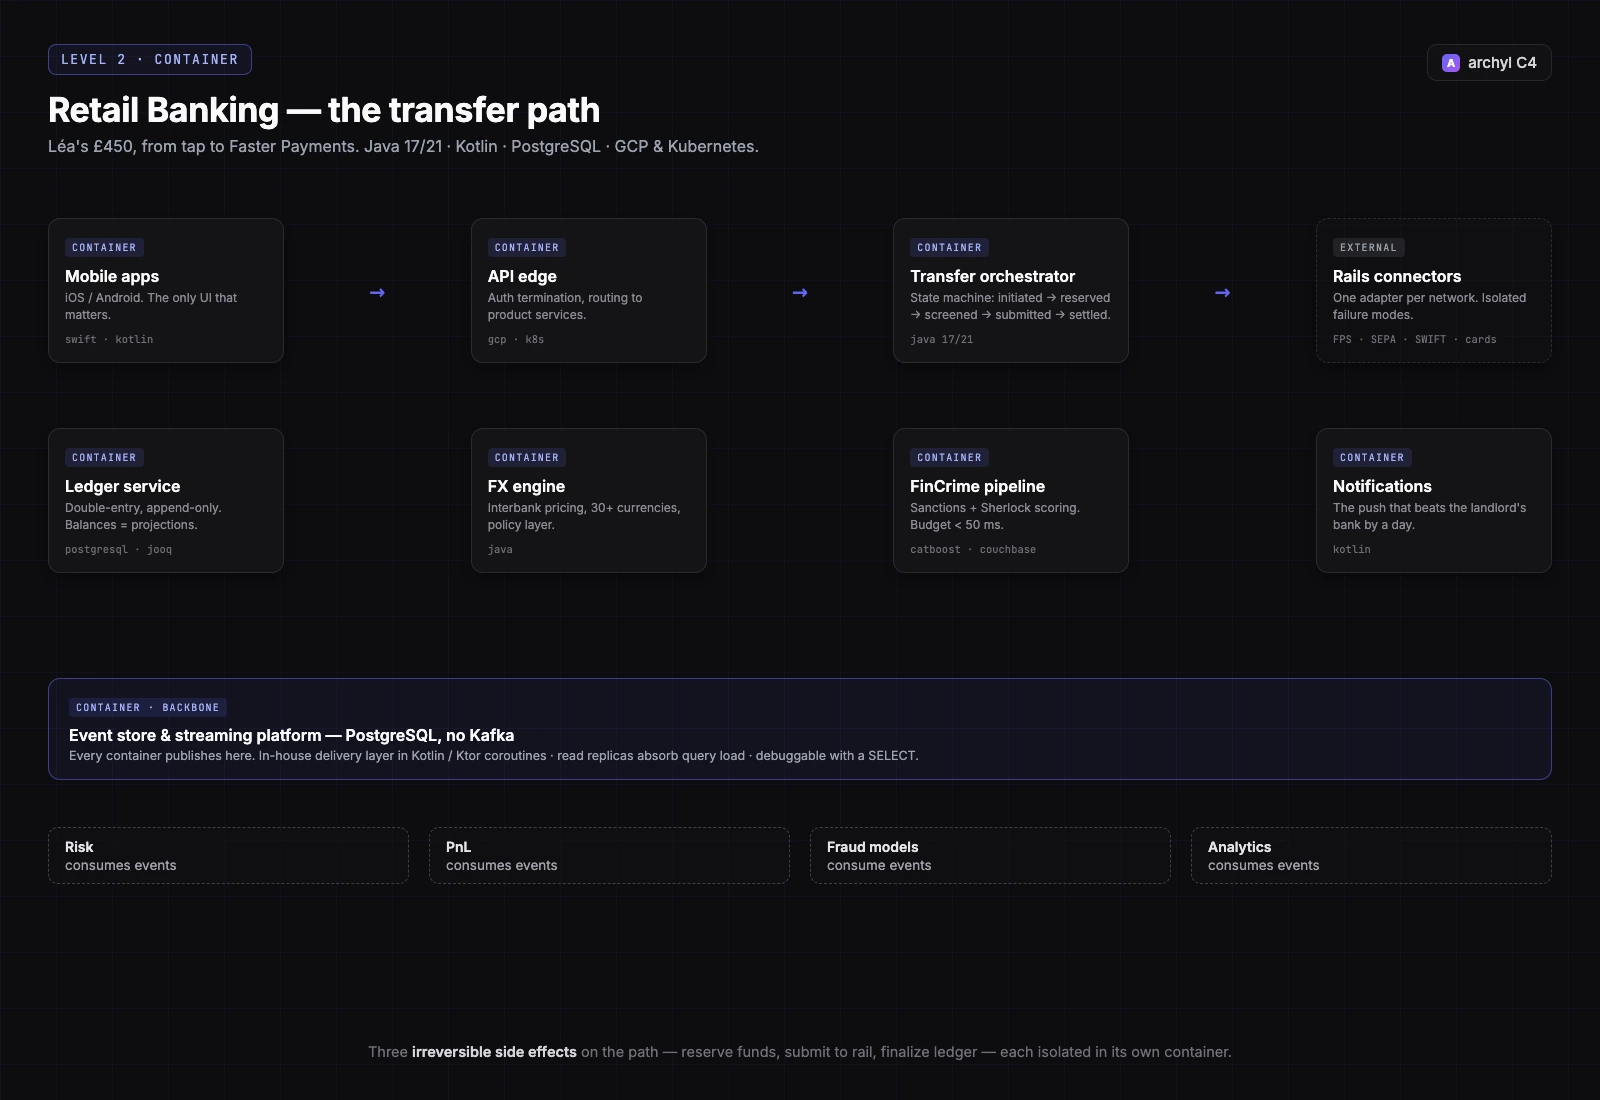
打开 Retail Banking 这个盒子,跟着那 450 英镑走。公开来源 — 工程博文、演讲和十年来的职位描述 — 让我们能叫出路径上这些 container 的名字:
- 移动 apps — iOS 和 Android,唯一重要的用户界面;不存在有意义的网页银行入口
- API 边缘层 — GCP 上的前门,终结认证并路由到各产品服务
- 转账编排器 — 一个拥有转账状态机的 Java 服务:
initiated→reserved→screened→submitted→settled(或每一步的补偿路径) - Ledger 服务 — 复式记账、append-only,基于 PostgreSQL。余额是事件历史的投影,不是可变的行
- FX 引擎 — 覆盖 30 多种货币的实时定价,银行间汇率加策略(周末加价、按套餐的额度)
- FinCrime 流水线 — 制裁筛查加 ML 评分;Sherlock 负责卡欺诈,专门的诈骗检测模型负责主动付款(我们在层级 3 深入)
- 支付网络连接器 — 每个网络一个适配器:Faster Payments、SEPA / SEPA Instant、SWIFT,以及卡处理器。每个都讲自己网络的协议,并隔离其故障模式
- 事件存储与 streaming 平台 — ADR-001 中那个基于 Postgres 的骨干,加上 Kotlin/Ktor 投递层
- 通知服务 — 那条比房东的银行 app 早整整一天到达的推送消息
这一层级的技术栈,直接来自 Revolut 自己的招聘信息:Java 17/21 作为主导后端语言、Kotlin 用于 streaming 平台、PostgreSQL 用在所有关键之处、Redis 做缓存、jOOQ 做类型化 SQL、Flyway 做迁移、Spock 做测试,全部跑在 GCP 和 Kubernetes 上,通过 Grafana、Prometheus 和 New Relic 观测。
注意这张图让什么变得显而易见:支付网络连接器是 唯一 一类 Revolut 无法通过工程手段消除其故障的 container — Faster Payments 挂掉不是 Revolut 的事故,但它是 Revolut 的支持工单。把外部依赖建模为一等公民的 container 并画出显式关系,就是在事故复盘替你揭示这个风险之前,先让它可见的方式。
ADR-002 · 把卡处理收归自建
状态 · Accepted(约 2019 年,此后已全面部署)
背景 · 和同代几乎所有 fintech 一样,Revolut 起步时使用第三方卡处理器。该处理器坐在每笔卡交易的关键路径上:它的宕机就是 Revolut 的宕机(还上了头条),它的按笔收费随 Revolut 的增长而膨胀,它的路线图卡住了 Revolut 的卡功能。
决策 · 自建支付处理器,并把卡流量迁移过去。直接拥有与卡组织的连接。
后果 · Revolut 报告称在自建系统上每周处理数百万笔支付,uptime 接近完美。单位经济恰好在交易量爆发的时刻得到改善,卡功能按 Revolut 的日历发布,而不是供应商的。代价:Revolut 现在运营着大多数公司理应外包的 PCI 范围基础设施,并承担随之而来的监管和审计负担。这条 ADR 只有超过某个交易量之后才说得通 — 这正是 ADR 的 context 部分存在的意义。抄了决策却不看背景,那就是一场灾难。
层级 3 — Component:Sherlock 内部,那个 50 毫秒的裁判
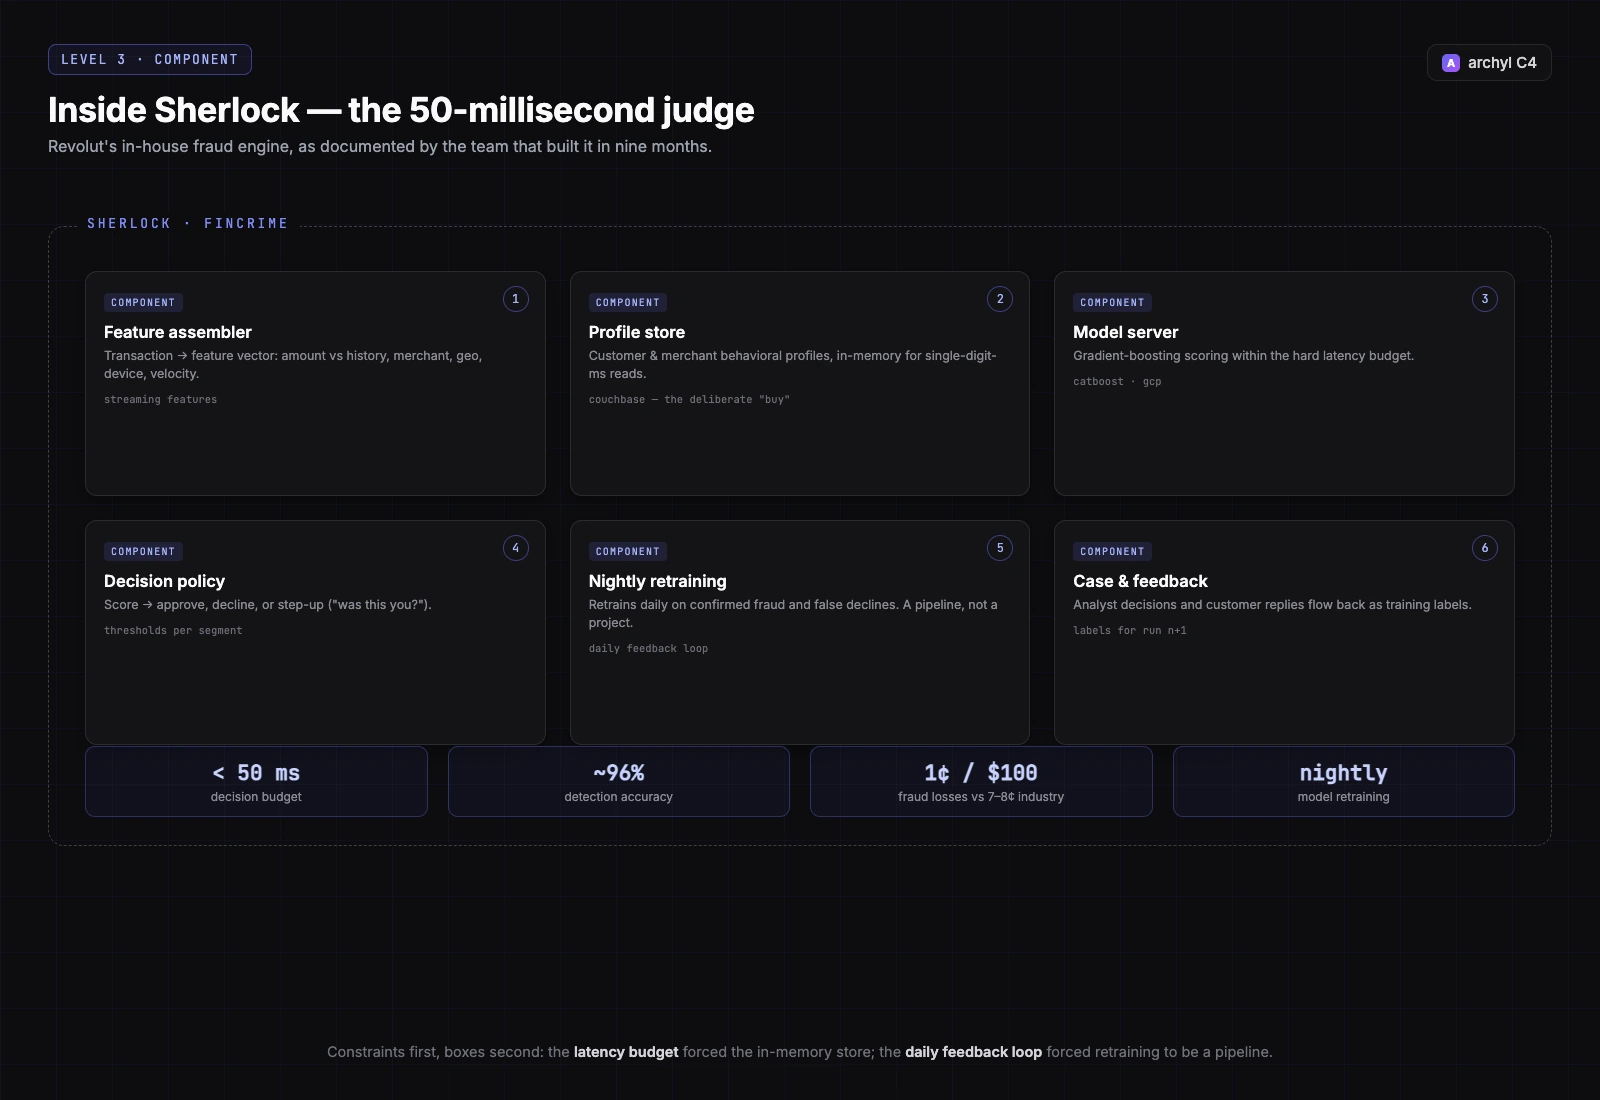
在 Revolut 技术栈的所有部分中,欺诈引擎是公开记录最多的 — 团队发表了他们如何在九个月内构建它,供应商案例研究补全了数据层。这使它成为 Component 层级放大的最佳候选,正如 上一篇 中 Stripe 的 idempotency layer 一样。
当一笔卡交易(或者,通过相邻的诈骗模型,一笔像 Léa 这样的主动付款)需要一个裁决时,它流经这些组件:
- Feature assembler — 把原始交易变成一个特征向量:金额对比历史、商户类别、地理位置、设备信号、频率计数器
- Profile store — 客户和商户的行为画像存放在 Couchbase 中,一个内存级 NoSQL 层,让查询保持在个位数毫秒
- Model server — 一个 CatBoost 梯度提升模型给交易打分;整个决策的预算是 低于 50 毫秒
- Decision policy — 阈值把分数变成动作:批准、拒绝,或升级验证(推送通知问 Léa "这是你本人吗?")
- 每夜重训练流水线 — 每天晚上,模型在当天已确认的欺诈和误拒上重新训练,把反馈闭环缩短到每天而不是每季度
- Case & feedback 服务 — 分析师的判定和客户的回应作为标签流回下一轮训练
公开报告的结果:约 96% 的检测准确率,欺诈损失约为每处理 100 美元 1 美分,而行业平均为 7 到 8 美分 — 仅第一年这个差距就价值约 300 万美元量级。
架构上的教训不是"用 CatBoost"。而是这个 形状:一个硬性延迟预算迫使出现一个专用的内存级 profile store;一个每日反馈闭环迫使重训练成为一条流水线,而不是一个项目。约束在先,盒子在后。
ADR-003 · 买下 profile store,其余全部自建
状态 · Accepted(约 2018 年,依然活跃)
背景 · Revolut 的文化是显眼的 build-first:自建处理器(ADR-002)、自建事件 streaming(ADR-001)、自建银行核心。Sherlock 需要在数百万个行为画像上实现低于 10 ms 的读取,同时写入持续流入 — 这在数据库市场是个已解决的问题,而且在这个全公司预算最紧的组件上"自己造轮子"只会增加延迟风险。
决策 · 买:在 Sherlock 内部使用 Couchbase 作为内存级 profile store,把团队的建设力花在真正差异化的部分 — 特征、模型、decision policy 和重训练闭环。
后果 · 欺诈团队交付的是模型,不是存储引擎。这个架构骨子里带着一个有用的教训:即使是欧洲 fintech 中最热衷自建的工程文化,在组件无差异化且故障后果不可原谅时也会选择购买。一条写着 "我们买了这个,原因如下,什么情况会让我们重新审视" 的 ADR,抵得上十页供应商评估的 wiki。
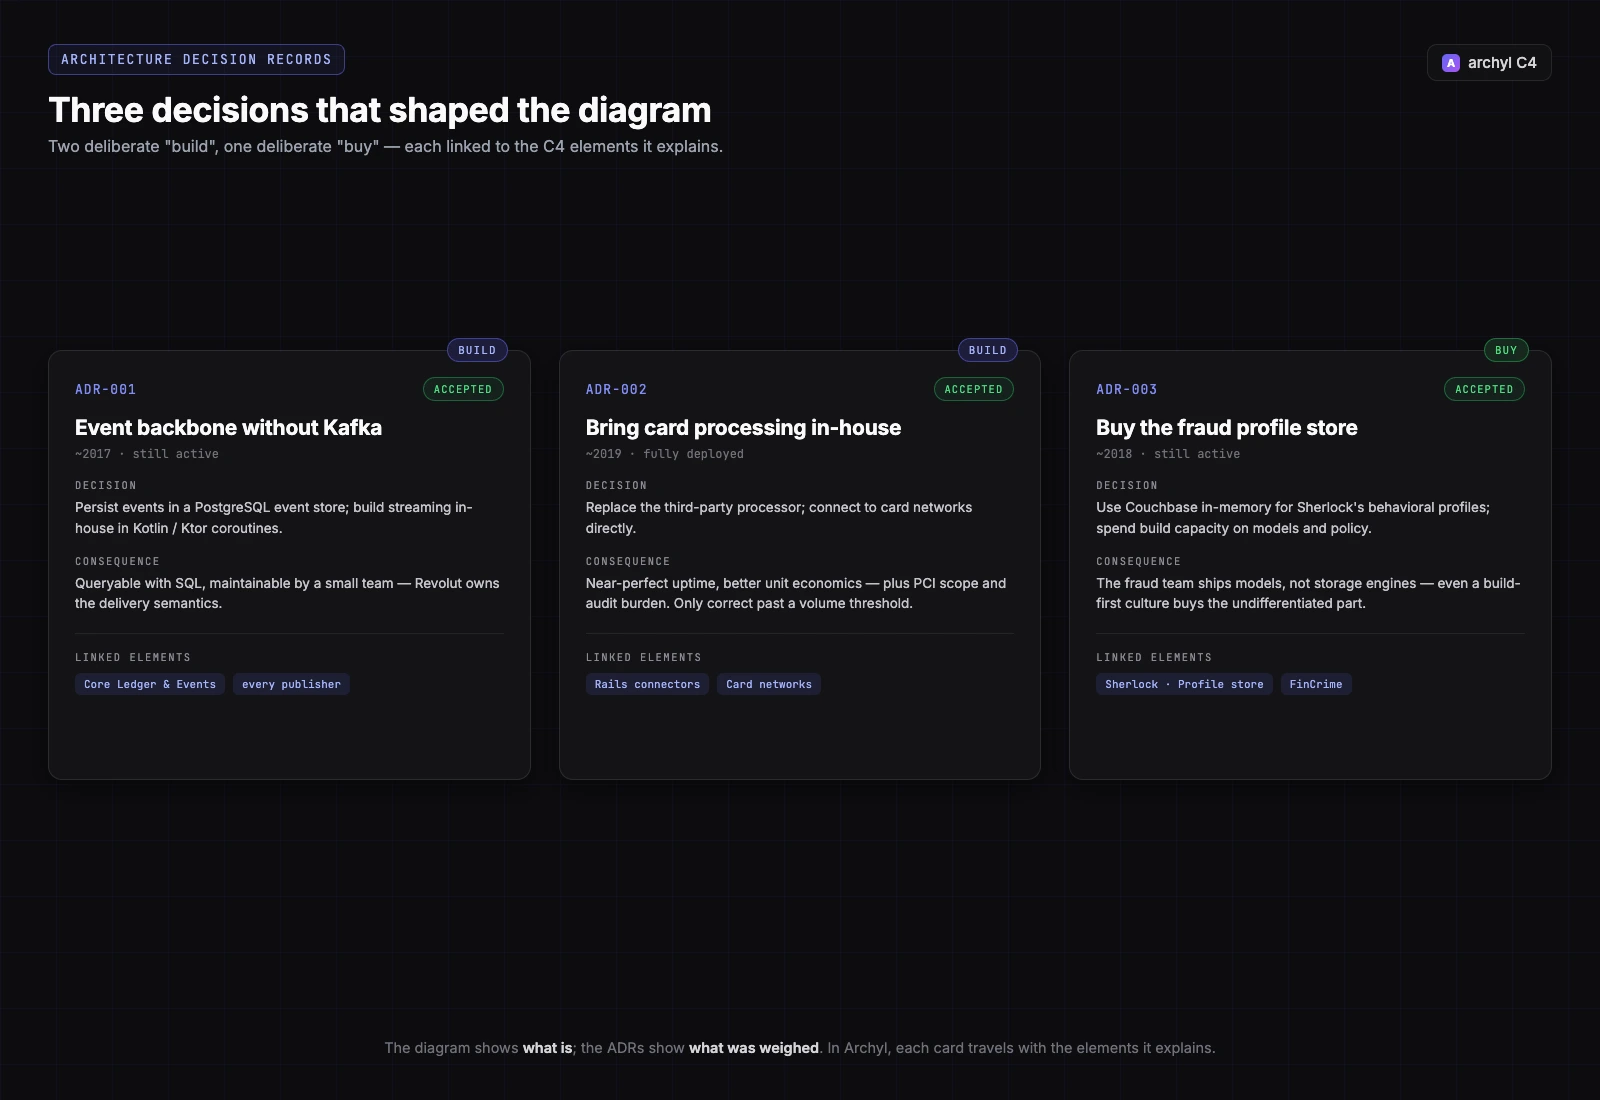
三个决策,Archyl 中的三张卡片,每张都连接到它塑造的 C4 元素 — 事件骨干连到每个发布事件的 container、自建处理连到支付网络连接器、buy-vs-build 的抉择连到 Sherlock 的 profile store。两个"build"决策和一个刻意的"buy":图展示的是现状;ADR 展示的是当时权衡了什么。
Ownership:一家公司里的一百家公司
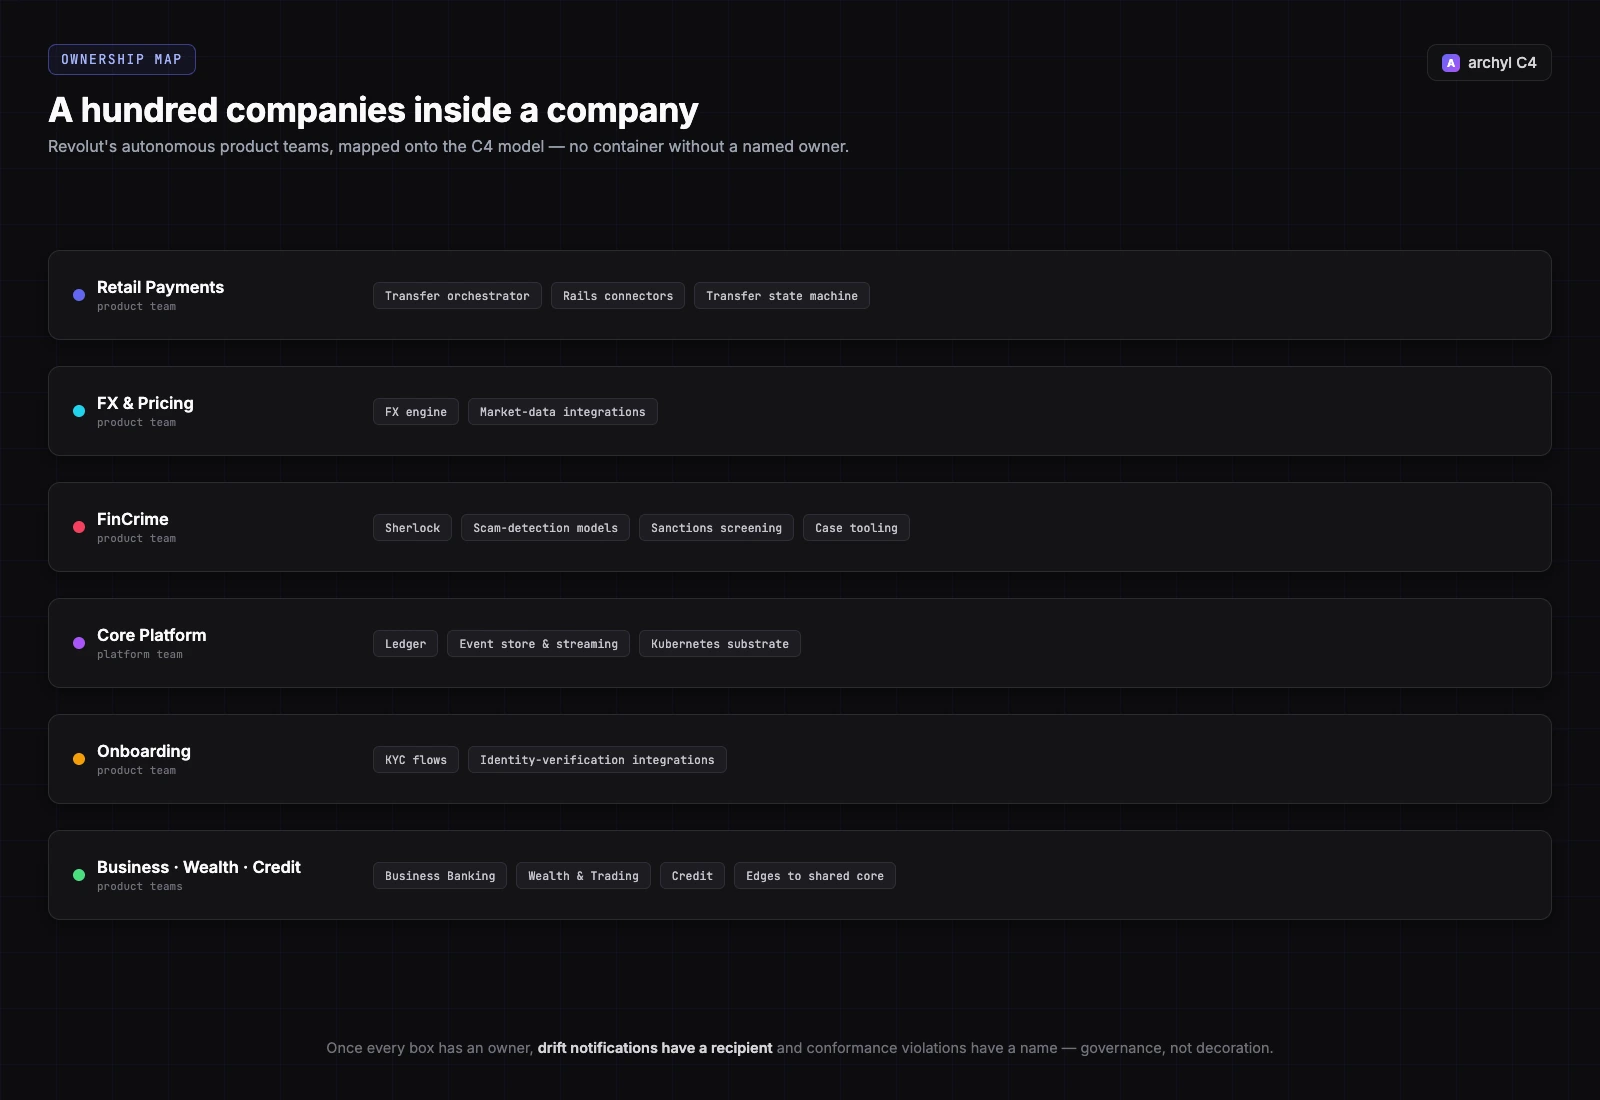
Revolut 以自治产品团队的组织方式著称 — 领导层把公司说成"一百家创业公司",每家都有一个对产品的指标、路线图和服务端到端负责的 owner。这可以直接映射到 C4 模型上:
- Retail Payments 拥有转账编排器、支付网络连接器和转账状态机
- FX & Pricing 拥有 FX 引擎及其行情数据整合
- FinCrime 拥有 Sherlock、诈骗检测模型、制裁筛查和案件处理工具
- Core Platform 拥有 ledger、事件存储与 streaming 平台,以及 Kubernetes 底座
- Onboarding 拥有 KYC 流程和身份验证整合
- Business、Wealth、Credit 各自拥有自己的产品系统及其与共享核心的边界
一旦每个 container 都有了 owner,模型就不再只是文档,而开始成为治理。代码库里出现了一个不在图上的新服务?某个具体团队会收到 drift 通知。某个 container 试图直接读 ledger 而不是消费事件?那是一条有名有姓的合规规则违规 — 而在一家自 2026 年 3 月起接受 PRA 监管的公司里,"这个盒子归谁" 也是监管机构会问的问题。
在 Archyl 中,Ownership Map 加 drift 检测 加 每周团队摘要,把 Revolut 的组织设计变成架构的一项可执行属性:Retail Payments 的周一摘要覆盖编排器和支付网络;FinCrime 的覆盖 Sherlock 和筛查流水线。相同的表面,scope 到每个团队自己的边界内。
学这些,别学那些
建模别人架构的意义,是让你在自己的架构里做出更好的决策。我们的看法:
学:
- 把事件日志作为 source of truth,建在 PostgreSQL 上。 你几乎肯定不需要第一天就上 Kafka。一张 append-only 表加上有纪律的消费者,就给了你可重放性、审计和 SQL 可调试性 — 而且它能扩展到比会议演讲共识所承认的远得多的规模。
- 给最高风险的决策一个硬性延迟预算。 "欺诈评分 50 ms 内给出答案,否则带标记批准"是一条能替你设计半个系统的架构约束。
- 每个盒子一个负责的 owner。 Revolut 的"一百家创业公司"模式很极端,但它的 C4 翻译版 — 没有一个 container 没有具名团队 — 成本为零,却彻底改变事故响应和 drift。
别学(除非你有 Revolut 的背景条件):
- 自建事件 streaming 平台。 那条 ADR 的前提是拥有世界级的平台团队和数百个服务。在十个服务的规模,托管消息服务或者朴素的 Postgres 队列更胜一筹。
- 自建卡处理。 这个决策在每周数百万笔交易时才回本。在那之下,它只是 PCI 范围和审计负担而没有收益 — ADR-002 的 context 部分正在承担关键作用。
你不需要 7000 万客户
这种纪律可以向下扩展。把 Context 与 Container 与 Component 分开;撰写解释 path-dependent 决策的 ADR(我们跳过了 Kafka、我们把处理收归自建、我们买下了 profile store);给每个盒子附上一个 owner — 这就是让一个三十个服务的技术栈在变成三百个服务的过程中保持清晰易读的东西。
C4 + ADR + Ownership + Drift + 合规就是 Archyl 开箱即用提供的。Revolut 只是这种纪律在 fintech 速度下复利十年之后的样子 — 靠 Java、Postgres 和异常清晰的 ownership,从零到一家 750 亿美元的银行。
打开你自己的架构。画出系统(八个,或者三个)。跟随你的产品中 Léa 的 450 英镑的等价物穿过 container。写下资深新人在第一周会问到的三条 ADR。给每个盒子映射一个团队。
你将走在大多数工程组织一年才能到达的位置之前。
FAQ
Revolut 用 Kafka 吗? 不用 — 这是刻意的选择。Revolut 把事件持久化在一个基于 PostgreSQL 的事件存储中,并用 Kotlin(JetBrains Ktor、coroutines)自建了 streaming 和消息平台,他们发现这比一套 Kafka 部署更容易维护、定制和查询。
Revolut 用什么数据库? PostgreSQL 是骨干 — 包括作为 source of truth 的事件存储 — 辅以 Redis 做缓存,以及 Sherlock 欺诈引擎内部作为内存级 profile store 的 Couchbase。
Revolut 是用什么编程语言写的? 后端以 Java(17/21)为主,事件 streaming 平台用 Kotlin,类型化 SQL 访问用 jOOQ。它运行在 Google Cloud 和 Kubernetes 上。
Revolut 是一家真正的银行吗? 是。Revolut 持有欧盟银行牌照(经由立陶宛央行)运营,并在 2024 年 7 月获得受限牌照之后,于 2026 年 3 月从 PRA 获得完整的英国银行牌照。
Revolut 如何检测欺诈? 用 Sherlock,一个自建的机器学习系统:CatBoost 模型在 50 毫秒内对每笔卡交易打分,对照存储在 Couchbase 中的行为画像,并每夜重训练。Revolut 报告的欺诈损失约为每处理 100 美元 1 美分,而行业平均为 7–8 美分。
想用 C4 建模你自己的架构?从 Archyl 开始。这是 Anatomy 系列的第四篇 — 也可以读 Stripe: Anatomy of a Charge、Netflix: Anatomy of a Play 和 Uber: Anatomy of a Ride,或深入 为什么 ADR 和 C4 一起更好用。