Aviso. Este artigo é baseado inteiramente em comunicações públicas do Revolut — seu engineering blog, palestras de conferências, vagas de emprego, relatórios anuais e estudos de caso externos. Não é um documento de arquitetura oficial do Revolut. Modelamos o que sabemos publicamente para ilustrar como um stack complexo pode ser tornado legível com o modelo C4. Quando os detalhes são inferidos em vez de afirmados pelo Revolut, dizemos.
Anatomia de uma Transferência: modelando o Revolut em C4 com Archyl
São 19h47 de uma sexta-feira em Paris. Léa abre o Revolut, digita £450, escolhe seu locador de Londres nos contatos, e toca em Enviar. Seus euros são convertidos em libras à taxa interbancária, filtrados por fraude e sanções, escritos em um ledger imutável, e empurrados para o Faster Payments, o rail de pagamentos do Reino Unido. O banco tradicional do locador credita o dinheiro antes de Léa colocar o telefone de volta no bolso.
Essa jornada de três segundos atravessa um app mobile, uma borda API, um orquestrador de transferências, um motor de FX, uma pipeline de financial crime com um budget de menos de 50 milissegundos, um event store, e uma rede de pagamento nacional externa — tudo operado por uma empresa que não existia onze anos atrás.
Revolut em números
| Clientes | 70+ milhões (maio de 2026), contra 50M em nov 2024 |
| Receita 2025 | US$ 6 bilhões (+46% YoY), US$ 2,3B de lucro antes de impostos |
| Volume de transações | £1,3 trilhão em 2025 (+65% YoY) |
| Valuation | US$ 75 bilhões |
| Presença | 40+ países — 13M de clientes no Reino Unido, 6M na Espanha, 5M na França |
| Perdas por fraude | ~1¢ por US$ 100 processados, contra uma média da indústria de 7–8¢ |
| Stack central | Java 17/21 & Kotlin, PostgreSQL, GCP, Kubernetes — e, notoriamente, nenhum Kafka |
Como você entende um stack que move £1,3 trilhão por ano? Da mesma forma que abordamos a Stripe, a Netflix e a Uber nesta série: você não entende — não de uma vez. Você segue uma única ação de usuário através dos quatro níveis C4, escreve os ADRs que explicam as decisões que encontra pelo caminho, e termina com um mapa de quem possui cada caixa.
As £450 de Léa são o nosso fio condutor.
Nível 1 — System Context: um banco, uma corretora, uma casa de câmbio, e uma app store
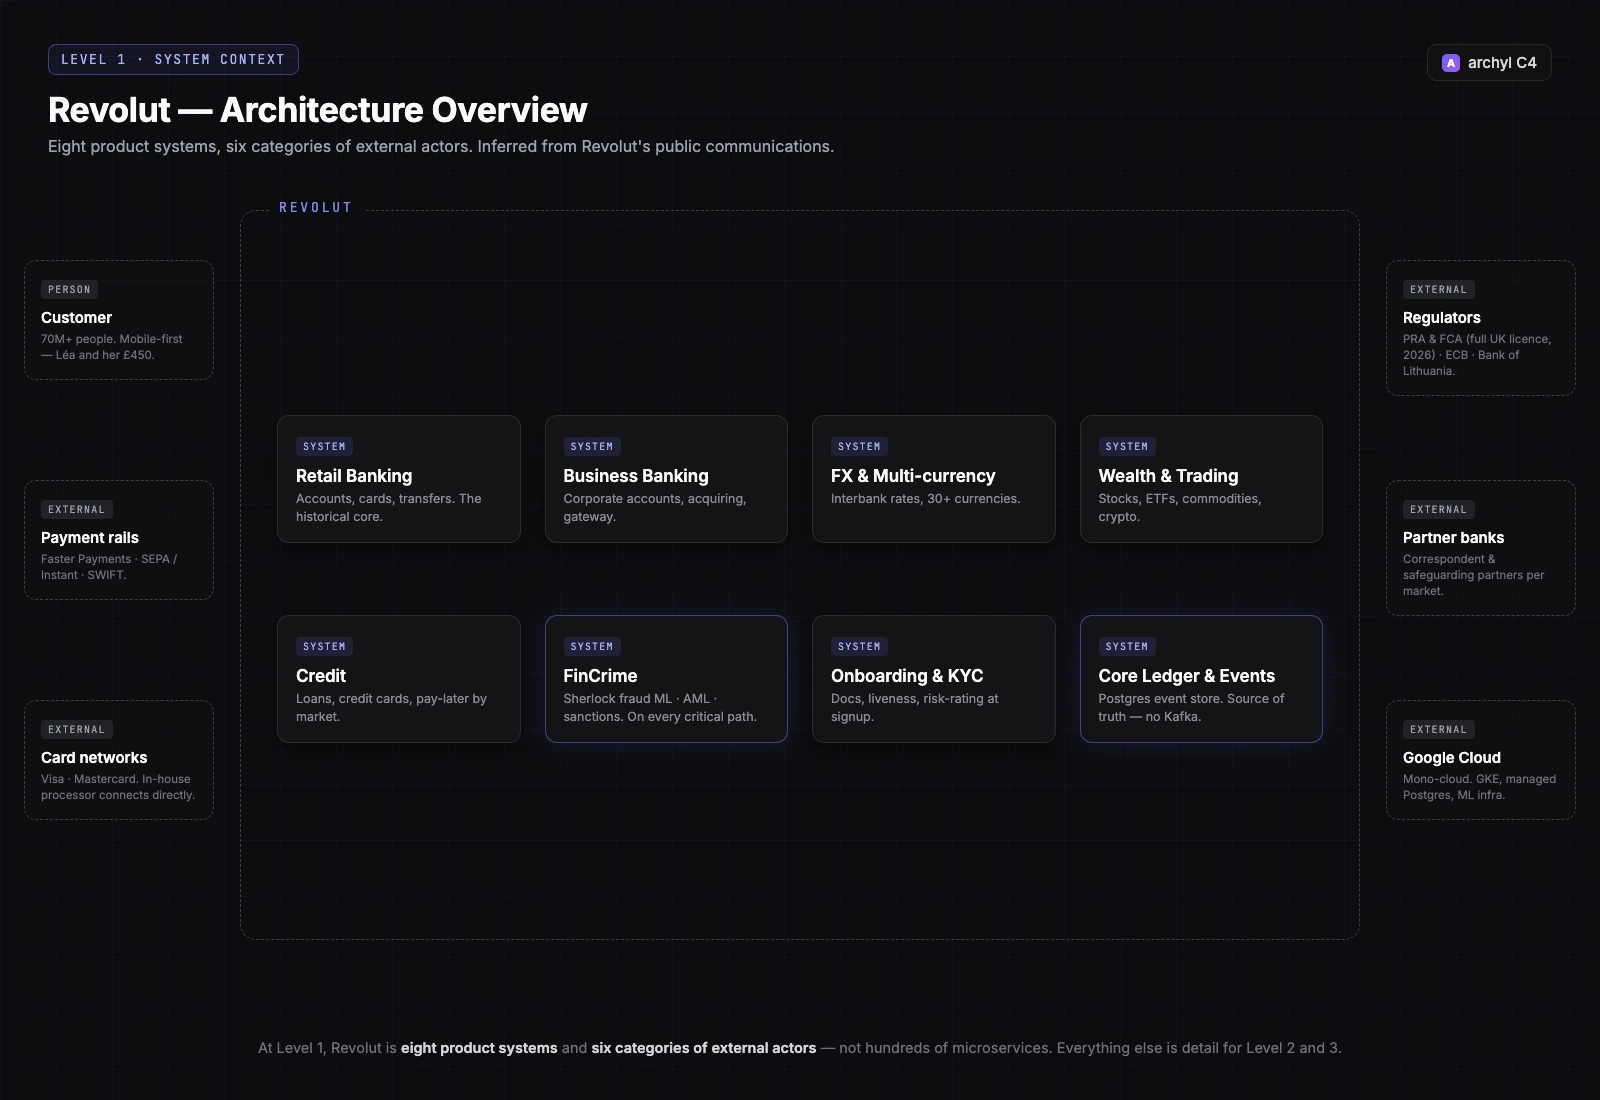
No nível System Context, o Revolut não é "um app bancário". As comunicações públicas descrevem pelo menos oito sistemas-produto compartilhando uma fundação:
- Retail Banking — contas multi-moeda, cartões, transferências: o núcleo histórico
- Business Banking — contas, cartões corporativos, e um braço de merchant acquiring com seu próprio payment gateway
- FX & Multi-currency — o motor de câmbio que tornou o Revolut famoso, taxas interbancárias em 30+ moedas
- Wealth & Trading — ações, ETFs, commodities, crypto
- Credit — empréstimos pessoais, cartões de crédito, produtos pay-later por mercado
- FinCrime — scoring de fraude (Sherlock), AML, screening de sanções, detecção de golpes
- Onboarding & KYC — verificação de documentos, checagens de liveness, avaliação de risco no cadastro
- Core Ledger & Event Backbone — a source of truth em que todo produto escreve
Em torno deles: redes de cartões (Visa, Mastercard), rails de pagamento (UK Faster Payments, SEPA e SEPA Instant, SWIFT para a cauda longa), bancos parceiros e correspondentes, reguladores (o PRA e a FCA no Reino Unido — o Revolut recebeu sua licença bancária britânica completa em março de 2026, após a licença restrita de julho de 2024; o BCE e o Banco da Lituânia na UE), parceiros de market data e brokerage para Wealth, e o Google Cloud como infraestrutura subjacente.
Oito sistemas, seis categorias de atores externos. Tudo o resto é detalhe.
Note o que o Nível 1 já te conta e nenhum organograma conta: FinCrime é um sistema, não uma feature. Ele fica no caminho crítico de todo produto — transferências retail, pagamentos por cartão, saques de crypto, payouts business. Quando uma empresa desenha seu context diagram e uma caixa tem setas vindo de todo lado, essa caixa é ou a joia da coroa ou o gargalo. No Revolut é as duas coisas, e o staffing foi dimensionado de acordo.
ADR-001 · Um backbone event-driven — sem Kafka
Status · Accepted (~2017, ainda ativo em 2026)
Contexto · O backend do Revolut são centenas de microsserviços independentes que se coordenam trocando eventos. A resposta default da indústria em 2017 (e, pode-se argumentar, ainda hoje) era Apache Kafka. Mas Kafka traz uma superfície operacional pesada: brokers, partições, rebalancing, tuning de retenção — uma preocupação de plataforma em tempo integral. A cultura de engenharia do Revolut favorece times pequenos que possuem primitivas simples e consultáveis.
Decisão · Não adotar Kafka. Persistir eventos em um único event store construído sobre PostgreSQL, e construir a camada de streaming e messaging in-house — escrita em Kotlin sobre JetBrains Ktor, usando coroutines para entrega de eventos com alta concorrência. Consumidores como Risk, PnL e detecção de fraude leem do store, com read replicas absorvendo a carga de queries.
Consequências · O event backbone é mantível por um time pequeno, e — crucialmente — consultável com SQL. Debugar um pagamento não é espeleologia em logs particionados; é um SELECT. O trade-off é real: o Revolut é dono das semânticas de availability, ordering e delivery que Kafka teria dado de prateleira. É uma decisão que só continua correta enquanto o time dono da plataforma continua excelente.
No Archyl, este ADR se linka ao sistema Core Ledger & Event Backbone e a cada container que publica nele. Quem perguntar "por que não tem Kafka neste diagrama?" — e todo senior hire pergunta — recebe a resposta em um clique.
Os três segundos, em uma timeline
Antes de dar zoom no Nível 2, aqui está a transferência de Léa como uma timeline. (Os números de latência são ordens de magnitude ilustrativas, não números publicados pelo Revolut.)
| t | O que acontece | Onde |
|---|---|---|
| 0 ms | Léa toca em Enviar | App mobile |
| ~10 ms | Sessão validada, request autenticada e parseada | Borda API |
| ~30 ms | Checagem de saldo e reserva de fundos, transacionalmente | Orquestrador de transferências + Ledger (PostgreSQL) |
| ~50 ms | EUR→GBP cotado à taxa interbancária | Motor de FX |
| ~100 ms | Screening de sanções + scoring de fraude/golpe — o budget de menos de 50 ms | Pipeline FinCrime |
| ~150 ms | TransferInitiated anexado ao event store; Risk, PnL, notificações e analytics o consomem |
Event backbone |
| ~200 ms | Pagamento submetido ao Faster Payments | Connector do rail FPS |
| ~2–3 s | Banco receptor confirma; ledger finaliza; push notification dispara | Rails + Ledger + Notificações |
Oito saltos, três deles side effects irreversíveis (reservar fundos, submeter ao rail, finalizar o ledger). Mantenha essa estrutura em mente — é exatamente o que o nível Container precisa tornar visível.
Nível 2 — Container: zoom no caminho da transferência
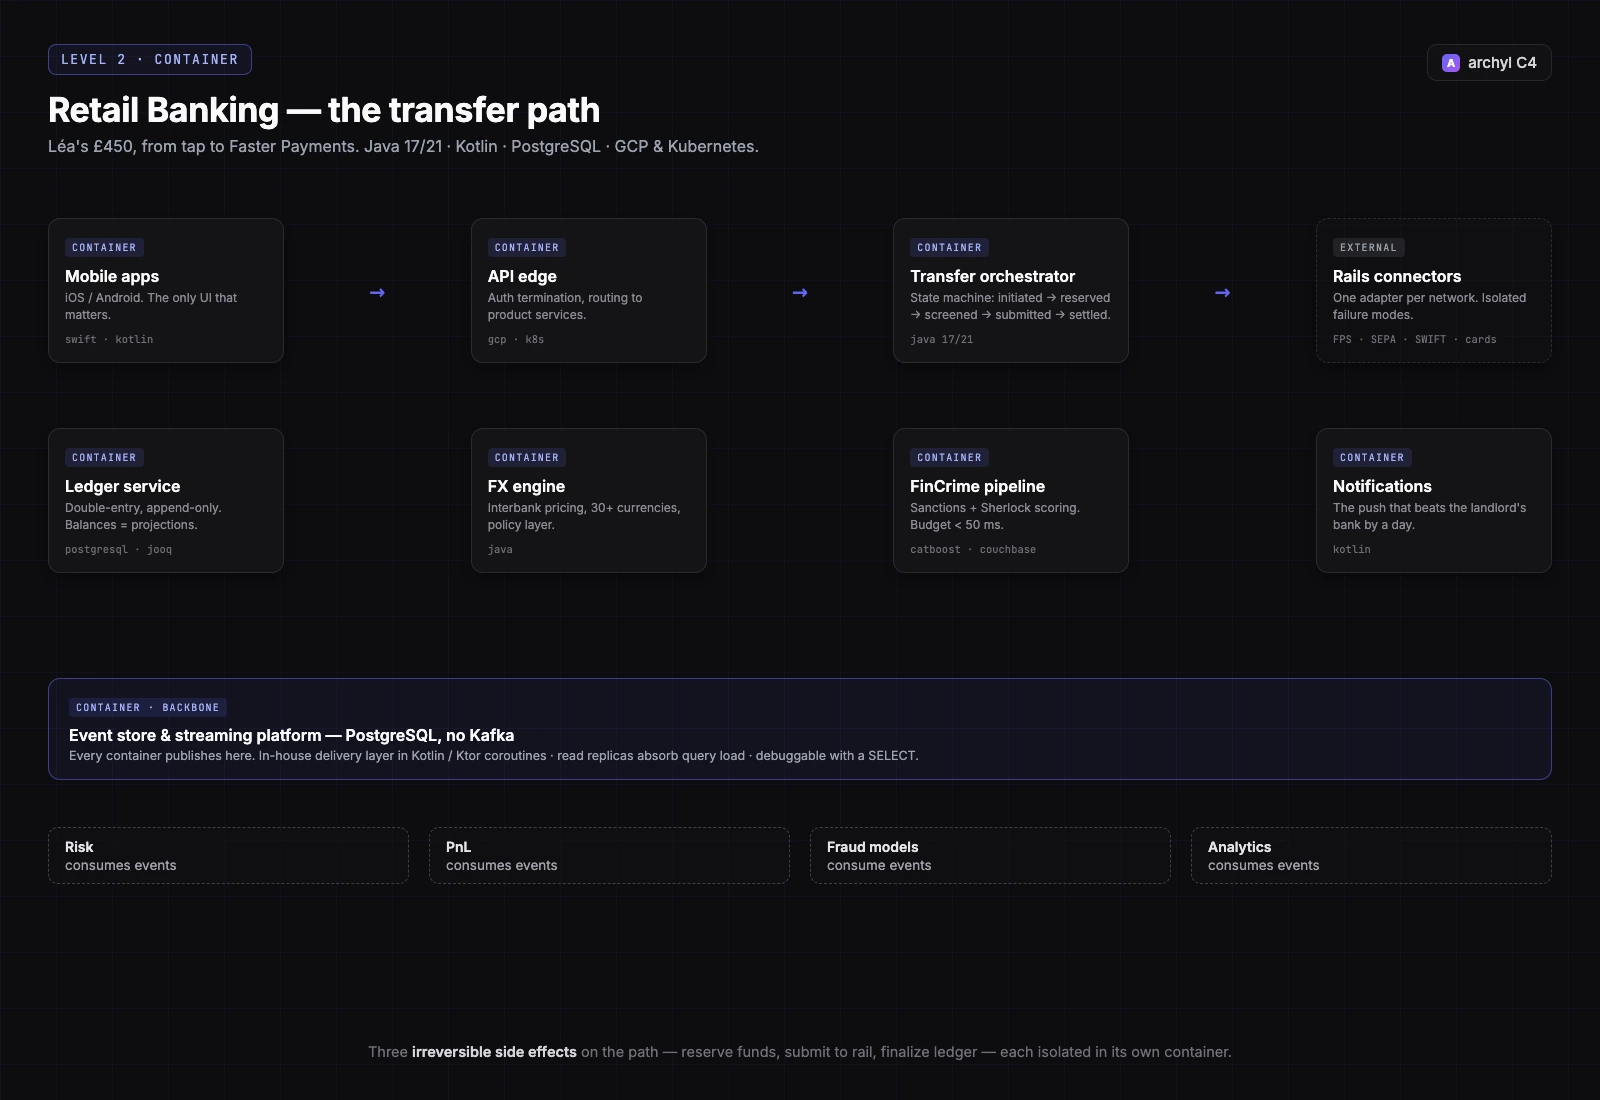
Abra a caixa Retail Banking e siga as £450. Fontes públicas — posts de engenharia, palestras, e uma década de descrições de vagas — nos deixam nomear os containers no caminho:
- Apps mobile — iOS e Android, a única interface de usuário que importa; não existe superfície de web banking relevante
- Borda API — a porta de entrada no GCP, terminando auth e roteando para os serviços de produto
- Orquestrador de transferências — um serviço Java dono da state machine de transferência:
initiated→reserved→screened→submitted→settled(ou o caminho de compensação a cada passo) - Serviço de Ledger — partida dobrada, append-only, sobre PostgreSQL. Saldos são projeções do histórico de eventos, não linhas mutáveis
- Motor de FX — pricing em tempo real em 30+ moedas, taxa interbancária mais política (markups de fim de semana, franquias por plano)
- Pipeline FinCrime — screening de sanções mais scoring ML; Sherlock para fraude de cartão, modelos dedicados de detecção de golpes para push payments (damos zoom no Nível 3)
- Connectors de rails — um adapter por rede: Faster Payments, SEPA / SEPA Instant, SWIFT, e o processador de cartões. Cada um fala o protocolo da sua rede e isola seus modos de falha
- Event store & plataforma de streaming — o backbone sobre Postgres do ADR-001, com a camada de entrega Kotlin/Ktor
- Serviço de notificações — a mensagem push que chega um dia inteiro antes do app do banco do locador
O stack tecnológico neste nível, direto das próprias vagas do Revolut: Java 17/21 como linguagem backend dominante, Kotlin para a plataforma de streaming, PostgreSQL em todo lugar que importa, Redis para caching, jOOQ para SQL tipado, Flyway para migrações, Spock para testes, tudo sobre GCP e Kubernetes, observado via Grafana, Prometheus e New Relic.
Note o que o diagrama torna óbvio: os connectors de rails são os únicos containers cuja falha o Revolut não consegue engenheirar para longe — o Faster Payments estar fora do ar não é um incidente do Revolut, mas é um ticket de suporte do Revolut. Modelar dependências externas como containers first-class com relacionamentos explícitos é como você torna esse risco visível antes que o incident review o torne visível por você.
ADR-002 · Trazer o processamento de cartões para dentro de casa
Status · Accepted (~2019, totalmente implantado desde então)
Contexto · Como quase toda fintech da sua geração, o Revolut lançou sobre um processador de cartões terceirizado. O processador ficava no caminho crítico de toda transação com cartão: suas quedas eram quedas do Revolut (e viravam manchete), suas taxas por transação escalavam com o crescimento do Revolut, e seu roadmap travava as features de cartão do Revolut.
Decisão · Construir um payment processor in-house e migrar o tráfego de cartões para ele. Ser dono da conexão direta com as redes de cartões.
Consequências · O Revolut reporta processar milhões de pagamentos por semana em sistemas próprios com uptime quase perfeito. A economia unitária melhorou exatamente no momento em que o volume explodiu, e as features de cartão passaram a shippar no calendário do Revolut, não no de um vendor. O preço: o Revolut agora opera infraestrutura de escopo PCI que a maioria das empresas acertadamente terceiriza, e carrega o fardo regulatório e de auditoria que vem junto. Este ADR só faz sentido acima de um certo volume de transações — que é precisamente para isso que serve a seção de contexto de um ADR. Copie a decisão sem o contexto e é uma catástrofe.
Nível 3 — Component: dentro do Sherlock, o juiz de 50 milissegundos
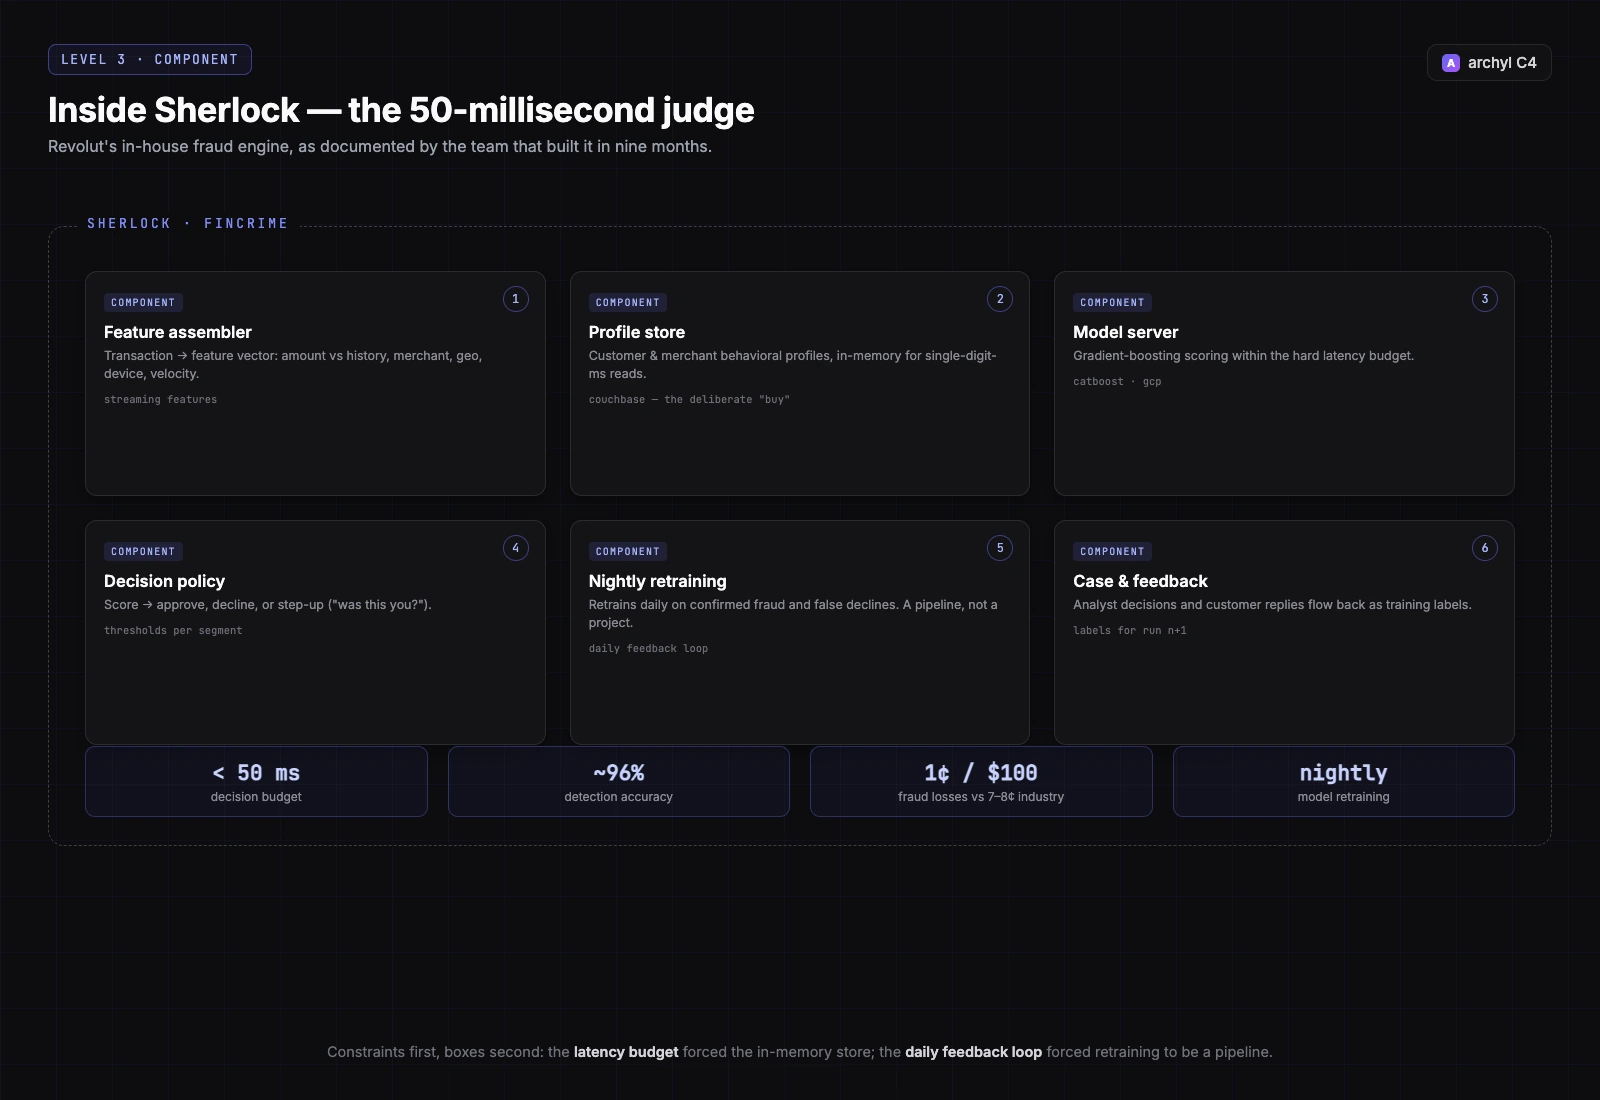
De tudo no stack do Revolut, o motor de fraude é o mais publicamente documentado — o time publicou como o construiu em nove meses, e o estudo de caso do vendor preenche a camada de dados. Isso o torna nosso melhor candidato para um zoom no nível Component, exatamente como a idempotency layer da Stripe no post anterior.
Quando uma transação com cartão (ou, através dos modelos adjacentes de golpe, um push payment como o de Léa) precisa de um veredito, ela flui por estes componentes:
- Feature assembler — transforma a transação bruta em um feature vector: valor vs. histórico, categoria do merchant, geografia, sinais do device, contadores de velocity
- Profile store — perfis comportamentais de clientes e merchants mantidos em Couchbase, uma camada NoSQL in-memory, para que os lookups fiquem em milissegundos de um dígito
- Model server — um modelo de gradient boosting CatBoost pontua a transação; a decisão inteira tem um budget de menos de 50 milissegundos
- Decision policy — thresholds transformam um score em uma ação: aprovar, recusar, ou step-up (push notification perguntando a Léa "foi você?")
- Pipeline de retraining noturno — toda noite, os modelos retreinam sobre a fraude confirmada e as recusas falsas do dia, fechando o feedback loop diariamente em vez de trimestralmente
- Case & feedback service — decisões de analistas e respostas de clientes voltam como labels para a próxima rodada de treino
Os resultados reportados: cerca de 96% de acurácia de detecção e perdas por fraude em torno de um centavo por US$ 100 processados, contra uma média da indústria de sete a oito centavos — um gap que vale da ordem de US$ 3M só no primeiro ano.
A lição arquitetural não é "use CatBoost". É a forma: um budget de latência rígido forçou um profile store in-memory dedicado; um feedback loop diário forçou o retraining a ser uma pipeline, não um projeto. Constraints primeiro, caixas depois.
ADR-003 · Comprar o profile store, construir todo o resto
Status · Accepted (~2018, ainda ativo)
Contexto · A cultura do Revolut é conspicuamente build-first: processador in-house (ADR-002), event streaming in-house (ADR-001), core bancário in-house. O Sherlock precisava de leituras sub-10 ms sobre milhões de perfis comportamentais, com writes chegando em stream contínuo — um problema resolvido no mercado de bancos de dados, e um em que "fazer o seu" adiciona risco de latência ao único componente com o budget mais apertado da empresa.
Decisão · Comprar: usar Couchbase como o profile store in-memory dentro do Sherlock, e gastar a capacidade de build do time nas partes que diferenciam — features, modelos, decision policy, e o loop de retraining.
Consequências · O time de fraude shippa modelos, não storage engines. E a arquitetura carrega uma lição útil nos ossos: até a cultura de engenharia mais build-happy da fintech europeia compra quando o componente é indiferenciado e o modo de falha é impiedoso. Um ADR que diz "compramos isso, eis o porquê, eis o que nos faria revisitar" vale dez páginas de wiki de avaliação de vendors.
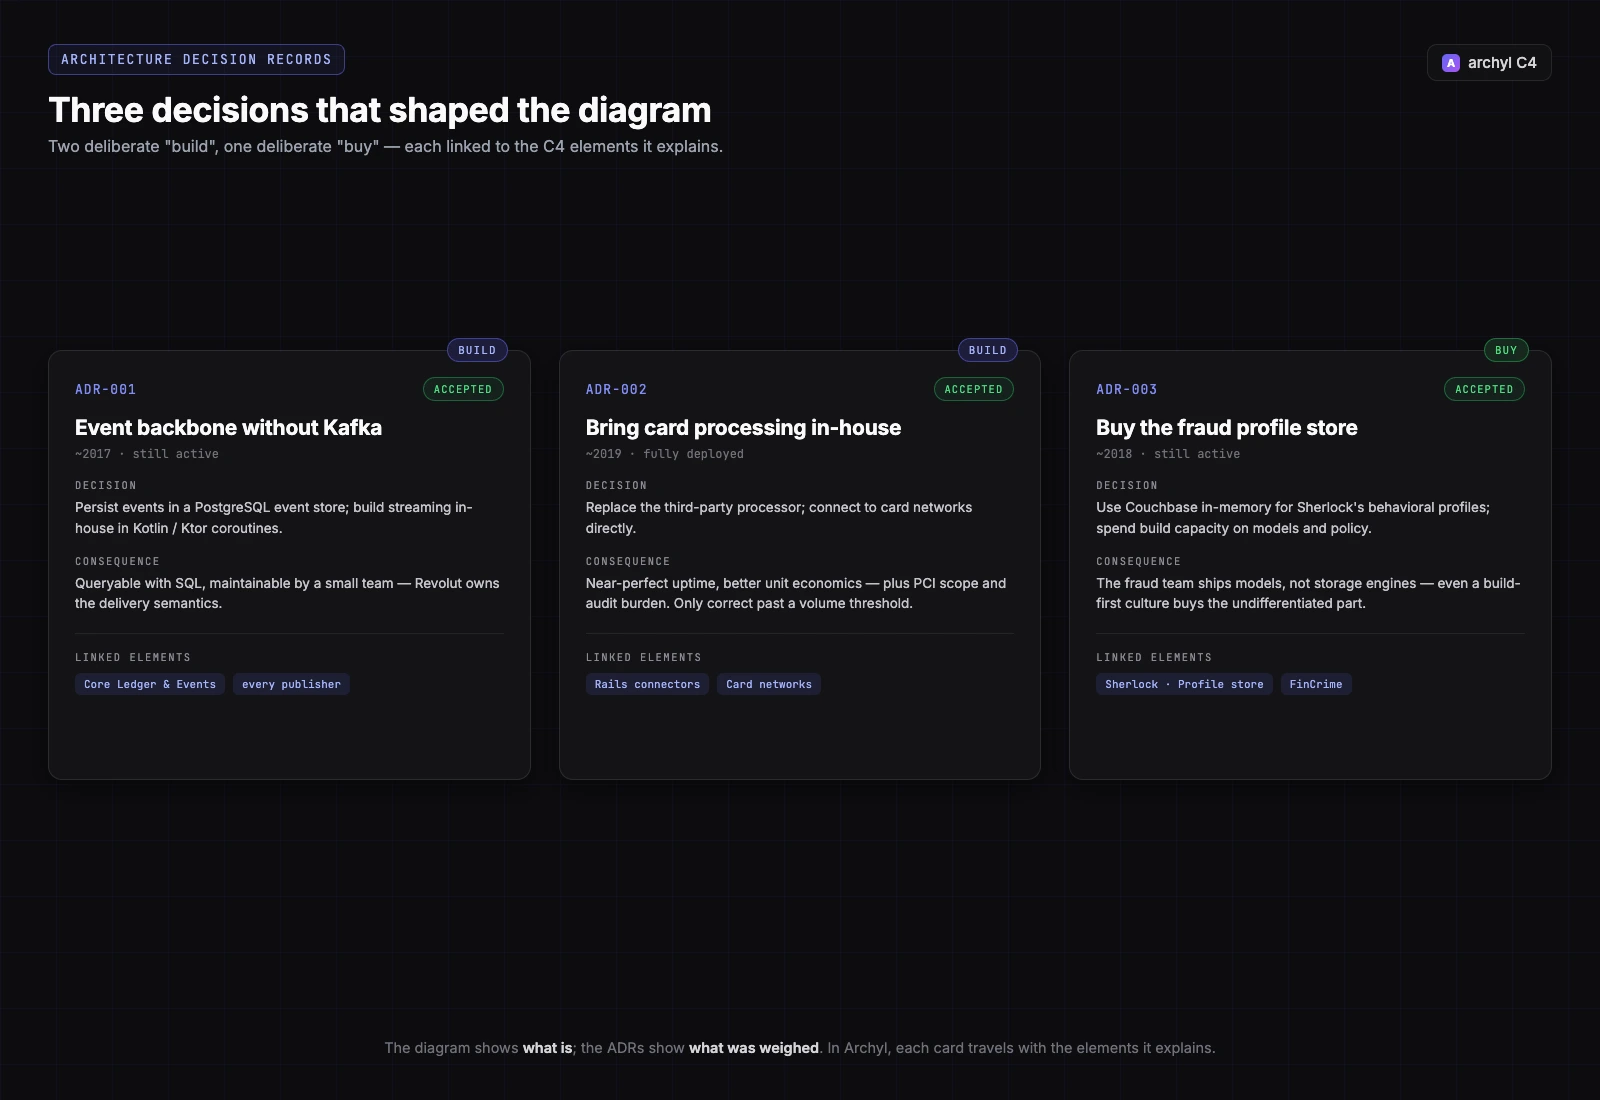
Três decisões, três cards no Archyl, cada uma linkada aos elementos C4 que ela molda — o event backbone a cada container que publica, o processamento in-house aos connectors de rails, a decisão buy-vs-build ao profile store do Sherlock. Duas decisões "build" e um "buy" deliberado: o diagrama mostra o que é; os ADRs mostram o que foi pesado.
Ownership: cem empresas dentro de uma empresa
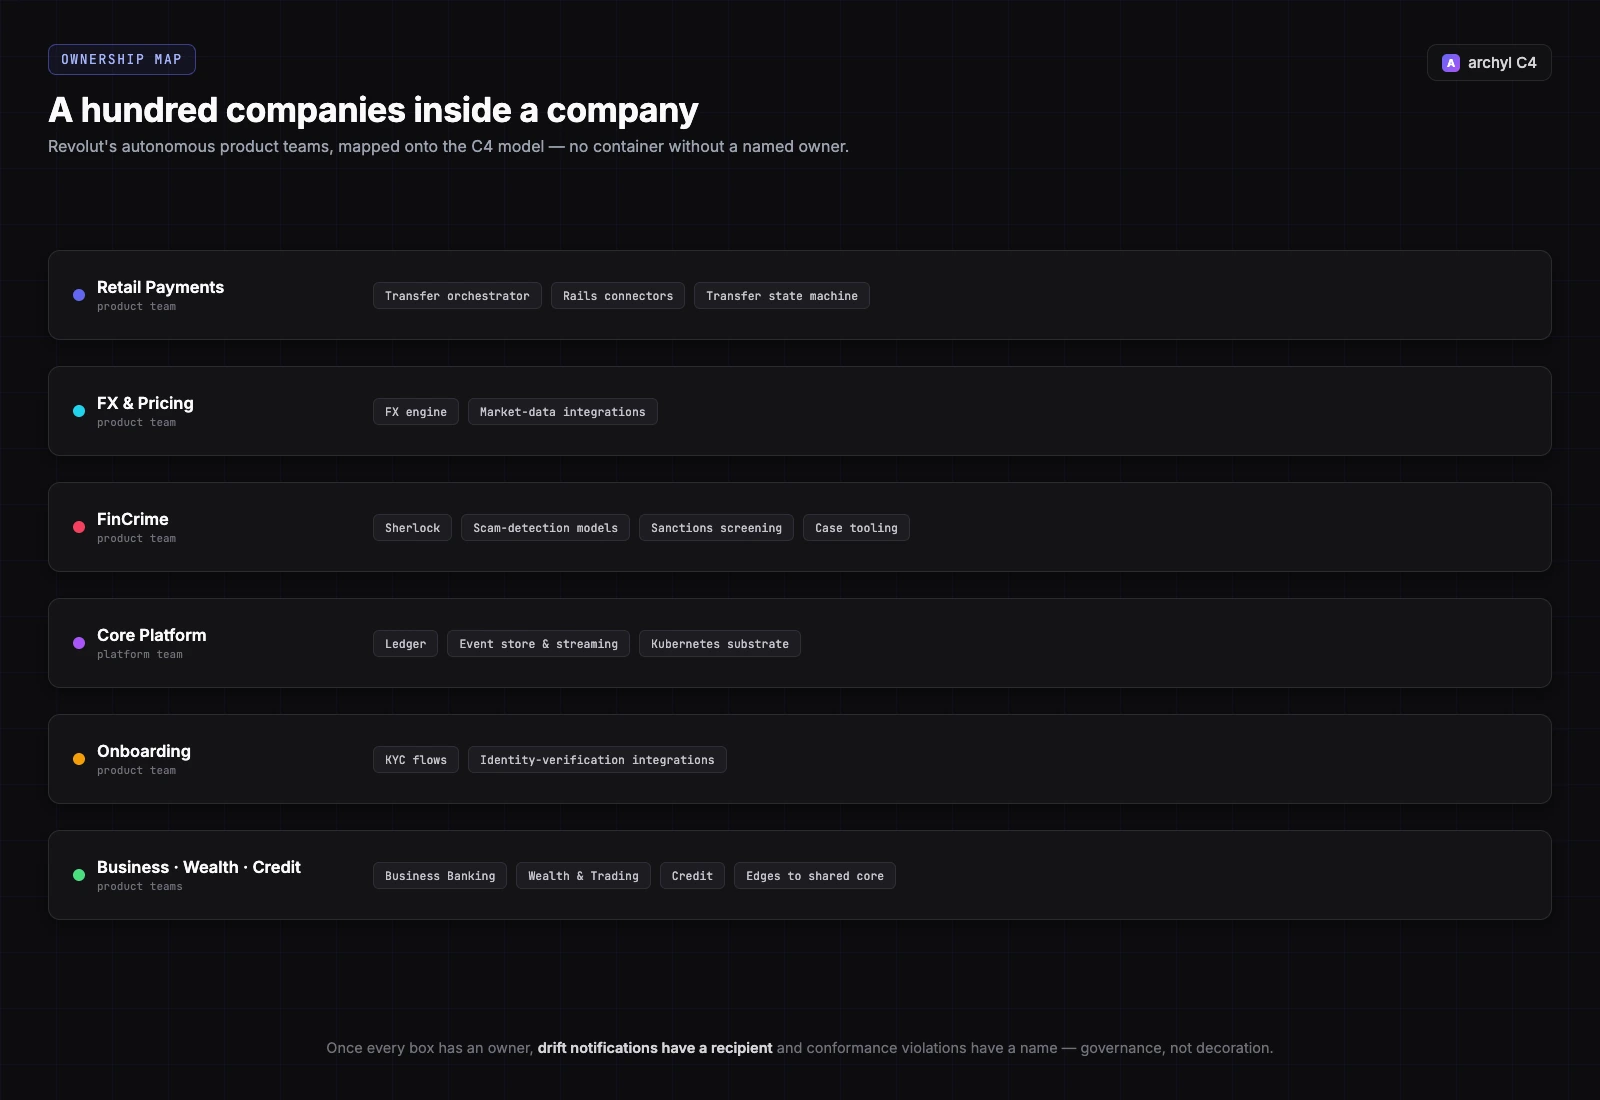
O Revolut é notoriamente organizado em times de produto autônomos — a liderança fala da empresa como "cem startups", cada uma com um owner accountable de ponta a ponta pelas métricas, roadmap e serviços de um produto. Isso mapeia diretamente no modelo C4:
- Retail Payments possui o orquestrador de transferências, os connectors de rails, e a state machine de transferência
- FX & Pricing possui o motor de FX e suas integrações de market data
- FinCrime possui o Sherlock, os modelos de detecção de golpes, o screening de sanções, e o tooling de casos
- Core Platform possui o ledger, o event store e a plataforma de streaming, e o substrato Kubernetes
- Onboarding possui os fluxos de KYC e as integrações de verificação de identidade
- Business, Wealth, Credit cada um possui seus sistemas-produto e suas bordas com o core compartilhado
Uma vez que todo container tem um owner, o modelo deixa de ser documentação e passa a ser governança. Um serviço novo aparece no codebase e não está no diagrama? Um time específico recebe a notificação de drift. Um container tenta ler o ledger diretamente em vez de consumir eventos? Isso é uma violação de regra de conformidade com um nome anexado — e numa empresa operando sob supervisão do PRA desde março de 2026, "quem possui esta caixa" é uma pergunta que os reguladores também fazem.
No Archyl, o Ownership Map mais a detecção de drift mais o resumo semanal de equipe transformam o design organizacional do Revolut em uma propriedade aplicável da arquitetura: o resumo de segunda de Retail Payments cobre o orquestrador e os rails; o de FinCrime cobre o Sherlock e a pipeline de screening. Mesma superfície, scoped ao perímetro de cada equipe.
Roube isto, pule isto
O objetivo de modelar a arquitetura de outra pessoa é tomar decisões melhores na sua. Nossa leitura:
Roube:
- O event log como source of truth, sobre PostgreSQL. Você quase certamente não precisa de Kafka no dia um. Uma tabela append-only com consumidores disciplinados te dá replayability, audit, e debugabilidade em SQL — e escala muito mais longe do que o consenso das palestras de conferência admite.
- Um budget de latência rígido para a decisão mais arriscada. "O scoring de fraude responde em 50 ms ou aprova com uma flag" é uma constraint arquitetural que desenha metade do sistema por você.
- Um owner accountable por caixa. O modelo "cem startups" do Revolut é extremo, mas sua tradução em C4 — nenhum container sem um time nomeado — não custa nada e muda tudo em incident response e drift.
Pule (a menos que você tenha o contexto do Revolut):
- Construir sua própria plataforma de event streaming. Esse ADR é downstream de ter um time de plataforma world-class e centenas de serviços. Com dez serviços, messaging managed ou simples filas em Postgres ganham.
- Processamento de cartões in-house. A decisão se pagou com milhões de transações por semana. Abaixo disso, é escopo PCI e fardo de auditoria sem upside — a seção de contexto do ADR-002 é quem carrega o peso.
Você não precisa de 70 milhões de clientes
A disciplina escala para baixo. Separar Context de Container de Component; escrever o ADR que explica uma decisão path-dependent (pulamos o Kafka, trouxemos o processamento para dentro, compramos o profile store); anexar um owner a cada caixa — é isso que mantém um stack de trinta serviços legível enquanto vira um stack de trezentos.
C4 + ADRs + Ownership + Drift + Conformidade é o que o Archyl te dá out of the box. O Revolut é simplesmente o que essa disciplina parece quando composta ao longo de uma década em velocidade de fintech — do zero a um banco de US$ 75B sobre Java, Postgres, e um ownership incomumente claro.
Abra sua própria arquitetura. Desenhe os sistemas (oito, ou três). Siga o equivalente das £450 de Léa do seu produto através dos containers. Escreva os três ADRs que um senior hire perguntaria na primeira semana. Mapeie uma equipe a cada caixa.
Você estará à frente de onde a maioria das organizações de engenharia chega em um ano.
FAQ
O Revolut usa Kafka? Não — por escolha deliberada. O Revolut persiste eventos em um event store sobre PostgreSQL e construiu sua plataforma de streaming e messaging in-house em Kotlin (JetBrains Ktor, coroutines), achando-a mais fácil de manter, customizar e consultar do que um deployment Kafka.
Que banco de dados o Revolut usa? PostgreSQL é o backbone — inclusive para o event store que atua como source of truth — complementado por Redis para caching e Couchbase como o profile store in-memory dentro do motor de fraude Sherlock.
Em que linguagem de programação o Revolut é escrito? O backend é predominantemente Java (17/21), com Kotlin para a plataforma de event streaming e jOOQ para acesso SQL tipado. Roda sobre Google Cloud e Kubernetes.
O Revolut é um banco de verdade? Sim. O Revolut opera sob uma licença bancária da UE (via Banco da Lituânia) e recebeu sua licença bancária britânica completa do PRA em março de 2026, após a licença restrita concedida em julho de 2024.
Como o Revolut detecta fraude? Com o Sherlock, um sistema de machine learning in-house: modelos CatBoost pontuam cada transação com cartão em menos de 50 milissegundos contra perfis comportamentais armazenados em Couchbase, e retreinam toda noite. O Revolut reporta perdas por fraude de cerca de 1¢ por US$ 100 processados, contra uma média da indústria de 7–8¢.
Quer modelar sua própria arquitetura em C4? Comece com Archyl. Este é o quarto post da série Anatomia — leia Stripe: Anatomia de um Charge, Netflix: Anatomia de um Play, e Uber: Anatomia de uma Corrida, ou mergulhe em por que ADRs e C4 funcionam melhor juntos.