면책 조항. 이 글은 Revolut의 공개 커뮤니케이션 — 엔지니어링 블로그, 컨퍼런스 발표, 채용 공고, 연간 보고서, 외부 케이스 스터디 — 만을 기반으로 합니다. Revolut 공식 아키텍처 문서가 아닙니다. 복잡한 스택이 C4 모델로 어떻게 readable해질 수 있는지 보여주기 위해 공개된 내용을 모델링합니다. 세부사항이 Revolut이 명시한 것이 아니라 추론된 경우 그 사실을 명시합니다.
Transfer의 해부학: Revolut을 C4로 Archyl에서 모델링하기
금요일 파리 시간 19:47. Léa가 Revolut을 열고, £450를 입력하고, 연락처에서 런던의 집주인을 선택한 뒤 Send 를 탭합니다. 그녀의 유로는 은행 간 환율로 파운드로 환전되고, 사기와 제재 대상 여부가 스크리닝되고, 불변 ledger에 기록되고, 영국의 Faster Payments 레일에 올라갑니다. Léa가 폰을 주머니에 다시 넣기도 전에 집주인의 시중은행이 돈을 입금합니다.
이 3초의 여정은 모바일 앱, API edge, transfer 오케스트레이터, FX 엔진, 50밀리초 이하 예산을 가진 금융범죄 파이프라인, event store, 그리고 외부 국가 결제 네트워크를 가로지릅니다 — 이 모든 것을 11년 전에는 존재하지도 않았던 회사가 운영합니다.
숫자로 보는 Revolut
| 고객 | 7,000만+ 명 (2026년 5월), 2024년 11월 5,000만에서 증가 |
| 2025년 매출 | 60억 달러 (+46% YoY), 세전 이익 23억 달러 |
| 거래량 | 2025년 £1.3조 (+65% YoY) |
| 기업 가치 | 750억 달러 |
| 진출 지역 | 40개 이상 국가 — 영국 1,300만, 스페인 600만, 프랑스 500만 고객 |
| 사기 손실 | 처리액 $100당 약 1¢, 업계 평균 7–8¢ 대비 |
| 핵심 스택 | Java 17/21 & Kotlin, PostgreSQL, GCP, Kubernetes — 그리고 유명하게도 Kafka 없음 |
연간 £1.3조를 움직이는 스택을 어떻게 이해할까요? 이 시리즈에서 Stripe, Netflix, Uber에 접근했던 것과 같은 방식입니다: 이해할 수 없습니다 — 한 번에는요. 하나의 사용자 액션 을 4개의 C4 레벨에 걸쳐 따라가고, 그 길에 만나는 결정을 설명하는 ADR을 작성하고, 각 박스를 누가 소유하는지의 맵으로 끝맺습니다.
Léa의 £450가 우리의 실마리입니다.
레벨 1 — System Context: 은행, 브로커, 거래소, 그리고 앱스토어
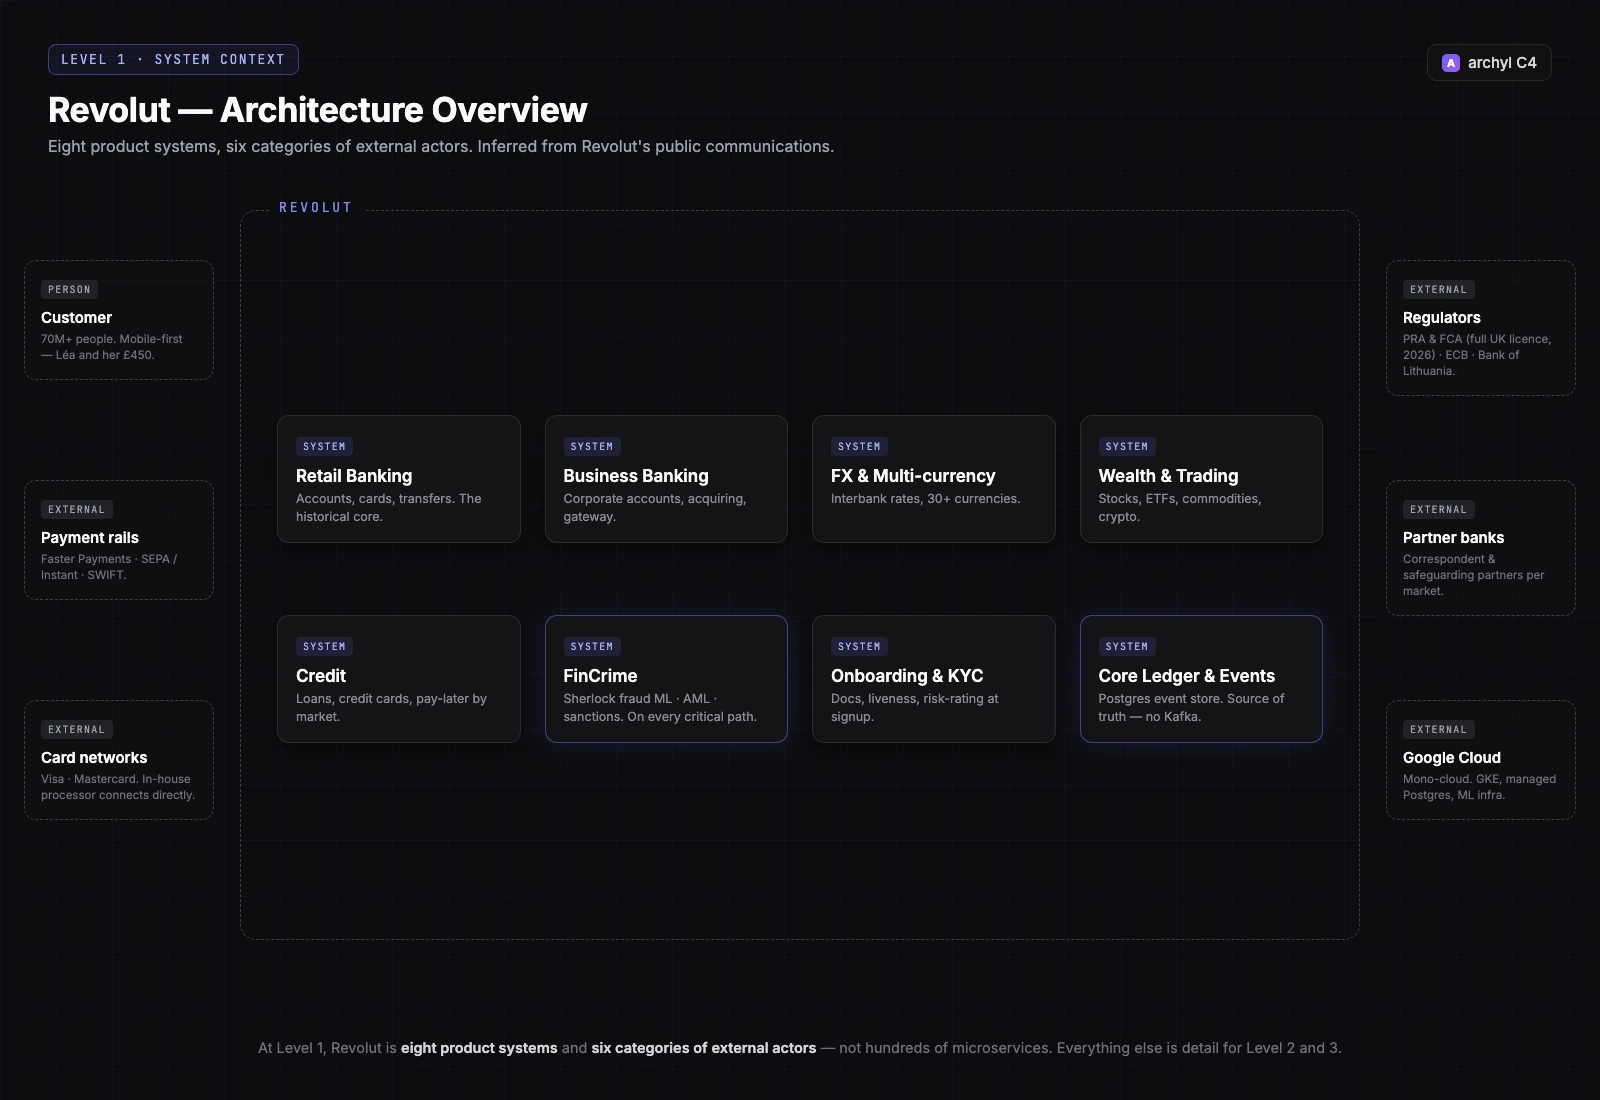
System Context 레벨에서 Revolut은 "뱅킹 앱"이 아닙니다. 공개 커뮤니케이션은 하나의 기반을 공유하는 최소 8개의 제품 시스템을 묘사합니다:
- Retail Banking — 멀티 통화 계좌, 카드, 이체: 역사적 핵심
- Business Banking — 계좌, 법인 카드, 그리고 자체 payment gateway를 가진 머천트 acquiring 부문
- FX & Multi-currency — Revolut을 유명하게 만든 환전 엔진, 30개 이상 통화에 걸친 은행 간 환율
- Wealth & Trading — 주식, ETF, 원자재, 암호화폐
- Credit — 개인 대출, 신용카드, 시장별 pay-later 상품
- FinCrime — 사기 스코어링(Sherlock), AML, 제재 스크리닝, 스캠 탐지
- Onboarding & KYC — 문서 검증, liveness 체크, 가입 시 리스크 평가
- Core Ledger & Event Backbone — 모든 제품이 기록하는 source of truth
주변에는: 카드 네트워크 (Visa, Mastercard), 결제 레일 (영국 Faster Payments, SEPA와 SEPA Instant, 롱테일을 위한 SWIFT), 파트너 및 코레스폰던트 은행, 규제 기관 (영국의 PRA와 FCA — Revolut은 2024년 7월의 제한적 라이선스 이후 2026년 3월 정식 영국 은행 라이선스를 받았습니다; EU에서는 ECB와 리투아니아 은행), Wealth를 위한 시장 데이터 및 브로커리지 파트너, 그리고 기반 인프라인 Google Cloud 가 있습니다.
8개 시스템, 6가지 카테고리의 외부 액터. 나머지는 모두 디테일입니다.
레벨 1이 이미 알려주는, 어떤 조직도가 알려주지 않는 것에 주목하세요: FinCrime은 기능이 아니라 시스템 입니다. 모든 제품의 크리티컬 패스 위에 있습니다 — 리테일 이체, 카드 결제, 암호화폐 출금, 비즈니스 payout. 회사가 context 다이어그램을 그렸을 때 하나의 박스에 사방에서 화살표가 향한다면, 그 박스는 최고의 보석이거나 병목입니다. Revolut에서는 둘 다이고, 그에 맞게 인력을 배치했습니다.
ADR-001 · 이벤트 기반 백본 — Kafka 없이
상태 · Accepted (~2017년, 2026년에도 여전히 활성)
컨텍스트 · Revolut의 백엔드는 이벤트 교환으로 조율되는 수백 개의 독립 마이크로서비스입니다. 2017년 업계의 기본 답은 (그리고 아마 지금도) Apache Kafka였습니다. 하지만 Kafka는 무거운 운영 표면을 가져옵니다: 브로커, 파티션, 리밸런싱, 리텐션 튜닝 — 풀타임 플랫폼 관심사입니다. Revolut의 엔지니어링 문화는 작은 팀이 단순하고 쿼리 가능한 프리미티브를 소유하는 것을 선호합니다.
결정 · Kafka를 도입하지 않는다. 이벤트를 PostgreSQL 위에 구축된 단일 event store 에 지속화하고, 스트리밍과 메시징 레이어를 자체 구축한다 — JetBrains Ktor 기반 Kotlin으로 작성하고, 고동시성 이벤트 전달에 코루틴을 사용한다. Risk, PnL, 사기 탐지 같은 컨슈머는 스토어에서 읽고, 읽기 replica가 쿼리 부하를 흡수한다.
결과 · 이벤트 백본은 작은 팀으로 유지보수 가능하고, 결정적으로 — SQL로 쿼리 가능 합니다. 결제 디버깅은 파티션된 로그를 뒤지는 게 아니라 SELECT 한 번입니다. 트레이드오프는 실재합니다: Kafka가 기성품으로 제공했을 가용성, 순서, 전달 시맨틱을 이제 Revolut이 직접 책임집니다. 이 결정은 플랫폼을 소유한 팀이 탁월함을 유지하는 동안에만 옳은 결정으로 남습니다.
Archyl에서 이 ADR은 Core Ledger & Event Backbone 시스템과 그곳에 발행하는 모든 컨테이너에 링크됩니다. "왜 이 다이어그램에 Kafka가 없죠?"라고 묻는 사람은 — 그리고 시니어 신규 입사자는 모두 묻습니다 — 한 번의 클릭으로 답을 얻습니다.
3초를 타임라인으로
레벨 2로 줌인하기 전에, Léa의 이체를 타임라인으로 봅시다. (지연 수치는 크기 감을 위한 예시이며, Revolut이 공표한 숫자가 아닙니다.)
| t | 무슨 일이 일어나는가 | 어디서 |
|---|---|---|
| 0 ms | Léa가 Send 를 탭 | 모바일 앱 |
| ~10 ms | 세션 검증, 요청 인증 및 파싱 | API edge |
| ~30 ms | 잔액 확인과 자금 예약, 트랜잭셔널하게 | Transfer 오케스트레이터 + Ledger (PostgreSQL) |
| ~50 ms | EUR→GBP를 은행 간 환율로 견적 | FX 엔진 |
| ~100 ms | 제재 스크리닝 + 사기/스캠 스코어링 — 50 ms 이하 예산 | FinCrime 파이프라인 |
| ~150 ms | TransferInitiated 가 event store에 append; Risk, PnL, 알림, 분석이 이를 소비 |
이벤트 백본 |
| ~200 ms | Faster Payments에 결제 제출 | FPS 레일 커넥터 |
| ~2–3 s | 수취 은행 확인; ledger 확정; 푸시 알림 발송 | Rails + Ledger + Notifications |
8번의 홉, 그중 3번은 되돌릴 수 없는 side effect입니다 (자금 예약, 레일 제출, ledger 확정). 이 구조를 기억해 두세요 — 정확히 Container 레벨이 가시화해야 하는 것입니다.
레벨 2 — Container: transfer 경로 줌인
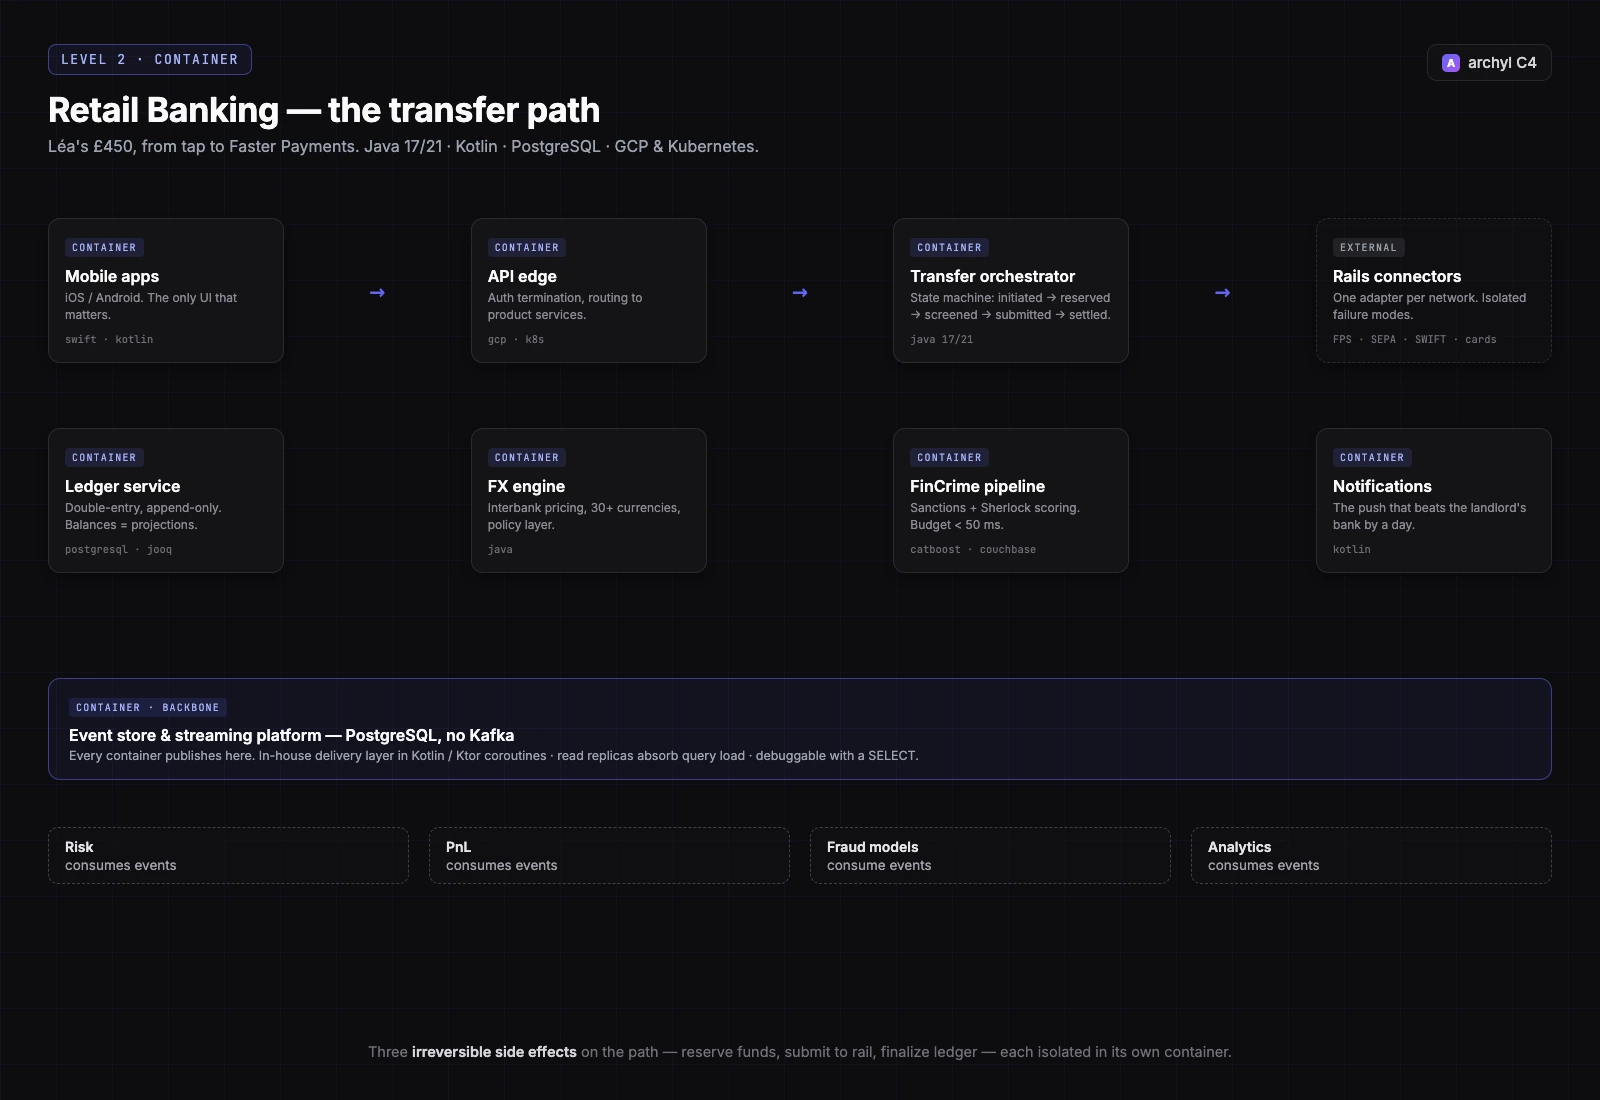
Retail Banking 박스를 열고 £450를 따라가 봅시다. 공개 소스 — 엔지니어링 포스트, 발표, 그리고 10년치 채용 공고 — 가 경로 위의 컨테이너들을 이름 붙일 수 있게 해줍니다:
- Mobile apps — iOS와 Android, 유일하게 의미 있는 사용자 인터페이스; 의미 있는 웹 뱅킹 표면은 존재하지 않음
- API edge — GCP 위의 정문, auth를 종료하고 제품 서비스로 라우팅
- Transfer orchestrator — transfer 상태 머신을 소유한 Java 서비스:
initiated→reserved→screened→submitted→settled(또는 각 단계의 보상 경로) - Ledger service — 복식부기, append-only, PostgreSQL 위. 잔액은 mutable한 행이 아니라 이벤트 히스토리의 projection
- FX engine — 30개 이상 통화에 걸친 실시간 프라이싱, 은행 간 환율에 정책(주말 마크업, 플랜별 한도)을 더함
- FinCrime pipeline — 제재 스크리닝과 ML 스코어링; 카드 사기를 위한 Sherlock, 푸시 결제를 위한 전용 스캠 탐지 모델 (레벨 3에서 줌인)
- Rails connectors — 네트워크당 하나의 어댑터: Faster Payments, SEPA / SEPA Instant, SWIFT, 그리고 카드 프로세서. 각자 자기 네트워크의 프로토콜을 말하고 자신의 실패 모드를 격리
- Event store & streaming platform — ADR-001의 Postgres 기반 백본, Kotlin/Ktor 전달 레이어와 함께
- Notification service — 집주인의 은행 앱보다 하루 먼저 도착하는 푸시 메시지
이 레벨의 기술 스택은 Revolut의 채용 공고에서 곧바로: 지배적 백엔드 언어인 Java 17/21, 스트리밍 플랫폼의 Kotlin, 중요한 모든 곳의 PostgreSQL, 캐싱의 Redis, 타입드 SQL의 jOOQ, 마이그레이션의 Flyway, 테스트의 Spock, 이 모두가 GCP와 Kubernetes 위에서, Grafana, Prometheus, New Relic으로 관측됩니다.
다이어그램이 명백하게 만드는 것에 주목하세요: rails connectors는 Revolut이 엔지니어링으로 없앨 수 없는 유일한 실패를 가진 컨테이너입니다 — Faster Payments가 다운되는 것은 Revolut의 장애가 아니지만, Revolut의 서포트 티켓입니다. 외부 의존성을 명시적 관계를 가진 first-class 컨테이너로 모델링하는 것이, 인시던트 리뷰가 그 리스크를 가시화하기 전에 미리 가시화하는 방법입니다.
ADR-002 · 카드 프로세싱 인하우스화
상태 · Accepted (~2019년, 이후 완전 배포)
컨텍스트 · 동세대의 거의 모든 핀테크처럼, Revolut은 서드파티 카드 프로세서로 출발했습니다. 프로세서는 모든 카드 트랜잭션의 크리티컬 패스 위에 있었습니다: 그들의 장애는 Revolut의 장애였고 (헤드라인이 되었고), 트랜잭션당 수수료는 Revolut의 성장에 비례해 커졌고, 그들의 로드맵이 Revolut의 카드 기능을 게이팅했습니다.
결정 · 인하우스 payment processor를 구축하고 카드 트래픽을 그리로 마이그레이션한다. 카드 네트워크와의 연결을 직접 소유한다.
결과 · Revolut은 인하우스 시스템에서 주당 수백만 건의 결제를 거의 완벽한 가동시간으로 처리한다고 보고합니다. 볼륨이 폭발하는 정확히 그 시점에 유닛 이코노믹스가 개선되었고, 카드 기능은 벤더의 캘린더가 아닌 Revolut의 캘린더로 출시됩니다. 대가: Revolut은 이제 대부분의 회사가 마땅히 아웃소싱하는 PCI 범위 인프라를 운영하고, 그에 따르는 규제와 감사 부담을 짊어집니다. 이 ADR은 특정 트랜잭션 볼륨을 넘어서야만 말이 됩니다 — 이것이 바로 ADR의 컨텍스트 섹션이 존재하는 이유입니다. 컨텍스트 없이 결정만 베끼면 재앙입니다.
레벨 3 — Component: 50밀리초의 심판, Sherlock 내부
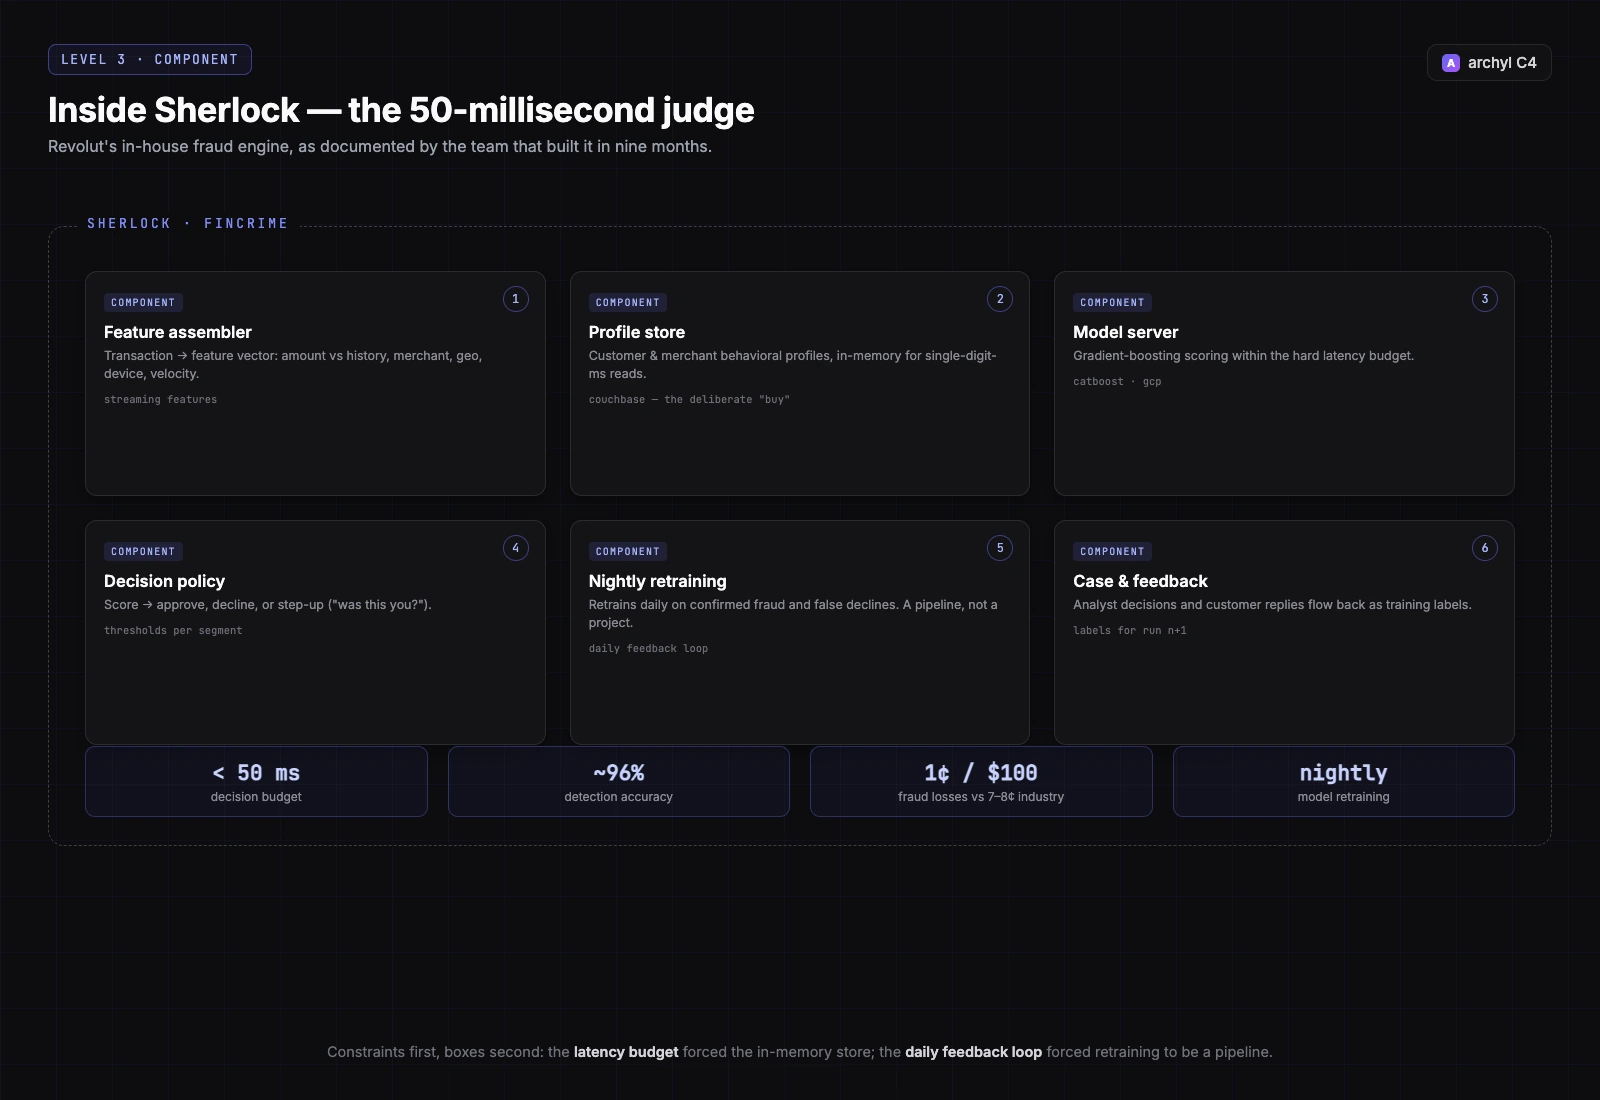
Revolut 스택의 모든 것 중에서 사기 엔진은 가장 공개적으로 문서화된 것입니다 — 팀은 9개월 만에 어떻게 구축했는지를 발표했고, 벤더 케이스 스터디가 데이터 레이어를 채워줍니다. 그래서 이전 포스트에서 Stripe의 idempotency layer를 다뤘던 것처럼, Component 레벨 줌인의 최적 후보입니다.
카드 트랜잭션이 (또는, 인접한 스캠 모델을 통해, Léa의 것 같은 푸시 결제가) 판정을 필요로 할 때, 이 컴포넌트들을 통과합니다:
- Feature assembler — 원시 트랜잭션을 feature 벡터로 변환: 이력 대비 금액, 머천트 카테고리, 지역, 디바이스 신호, velocity 카운터
- Profile store — 고객과 머천트의 행동 프로필을 인메모리 NoSQL 레이어인 Couchbase 에 보관, 룩업이 한 자릿수 밀리초에 머물도록
- Model server — CatBoost gradient-boosting 모델이 트랜잭션을 스코어링; 전체 결정의 예산은 50밀리초 이내
- Decision policy — 임계값이 점수를 액션으로 변환: 승인, 거절, 또는 step-up (Léa에게 "본인이 맞나요?"라고 묻는 푸시 알림)
- Nightly retraining pipeline — 매일 밤, 그날 확인된 사기와 잘못된 거절로 모델을 재학습, 피드백 루프를 분기가 아닌 일 단위로 닫음
- Case & feedback service — 분석가 결정과 고객 응답이 다음 학습을 위한 레이블로 되돌아옴
보고된 결과: 약 96% 탐지 정확도 와 처리액 $100당 약 1센트 의 사기 손실, 업계 평균 7~8센트 대비 — 첫해에만 약 300만 달러 규모의 격차입니다.
아키텍처적 교훈은 "CatBoost를 써라"가 아닙니다. 형태 입니다: 엄격한 지연 예산이 전용 인메모리 profile store를 강제했고, 일 단위 피드백 루프가 재학습을 프로젝트가 아닌 파이프라인으로 강제했습니다. 제약이 먼저, 박스는 그다음.
ADR-003 · Profile store는 사고, 나머지는 전부 만든다
상태 · Accepted (~2018년, 여전히 활성)
컨텍스트 · Revolut의 문화는 눈에 띄게 build-first입니다: 인하우스 프로세서 (ADR-002), 인하우스 이벤트 스트리밍 (ADR-001), 인하우스 뱅킹 코어. Sherlock은 수백만 개의 행동 프로필에 대한 10 ms 이하 읽기가 필요했고, 쓰기는 지속적으로 스트리밍되어 들어옵니다 — 데이터베이스 시장에서 이미 해결된 문제이고, "직접 만들기"가 회사에서 가장 타이트한 예산을 가진 바로 그 컴포넌트에 지연 리스크를 더하는 영역입니다.
결정 · 산다: Sherlock 내부의 인메모리 profile store로 Couchbase를 사용하고, 팀의 구축 역량은 차별화되는 부분 — features, 모델, decision policy, 재학습 루프 — 에 쓴다.
결과 · 사기 팀은 스토리지 엔진이 아니라 모델을 출시합니다. 그리고 이 아키텍처는 뼛속에 유용한 교훈을 새기고 있습니다: 유럽 핀테크에서 가장 build를 좋아하는 엔지니어링 문화조차 컴포넌트가 차별화되지 않고 실패 모드가 용서 없을 때는 삽니다. "우리는 이걸 샀고, 이유는 이것이고, 이런 상황이면 재검토한다" 라고 말하는 ADR 하나가 벤더 평가 위키 페이지 열 장의 가치가 있습니다.
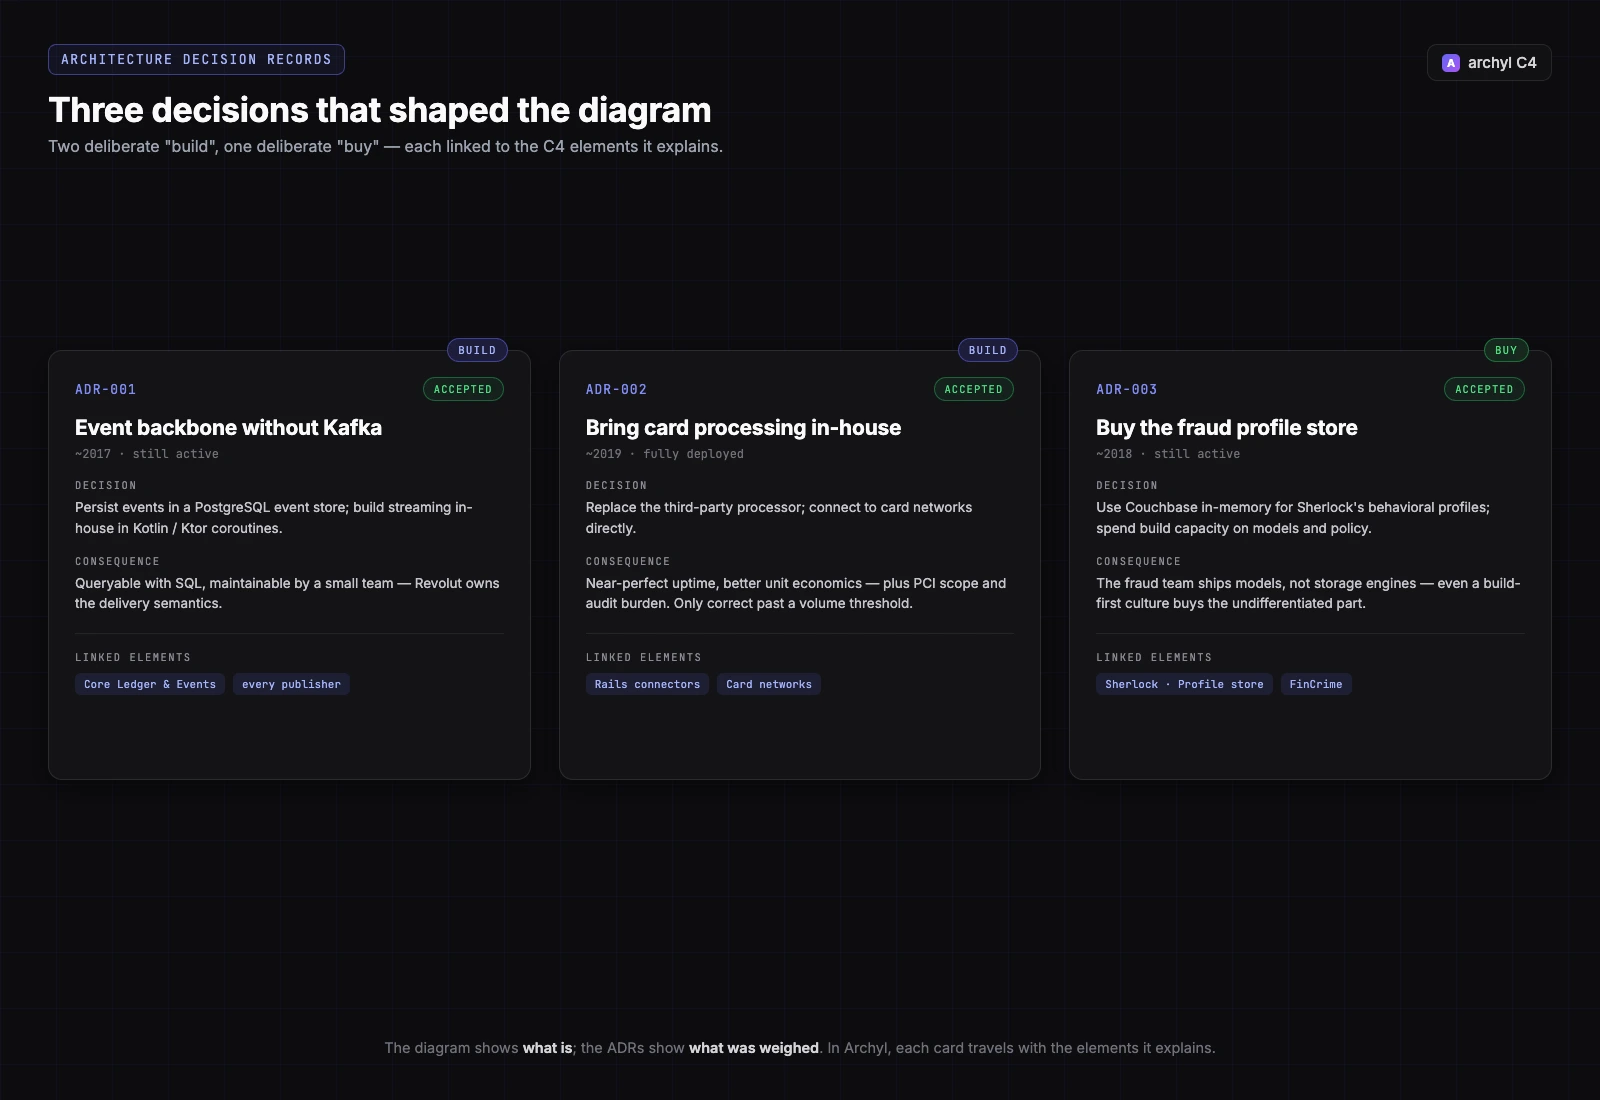
세 가지 결정, Archyl의 세 카드, 각각이 형성하는 C4 요소에 링크 — 이벤트 백본은 모든 발행 컨테이너에, 인하우스 프로세싱은 rails connectors에, buy-vs-build 결정은 Sherlock의 profile store에. 두 개의 "build" 결정과 하나의 의도적인 "buy": 다이어그램은 현재를 보여주고, ADR은 무엇이 저울질되었는지를 보여줍니다.
Ownership: 회사 안의 백 개의 회사
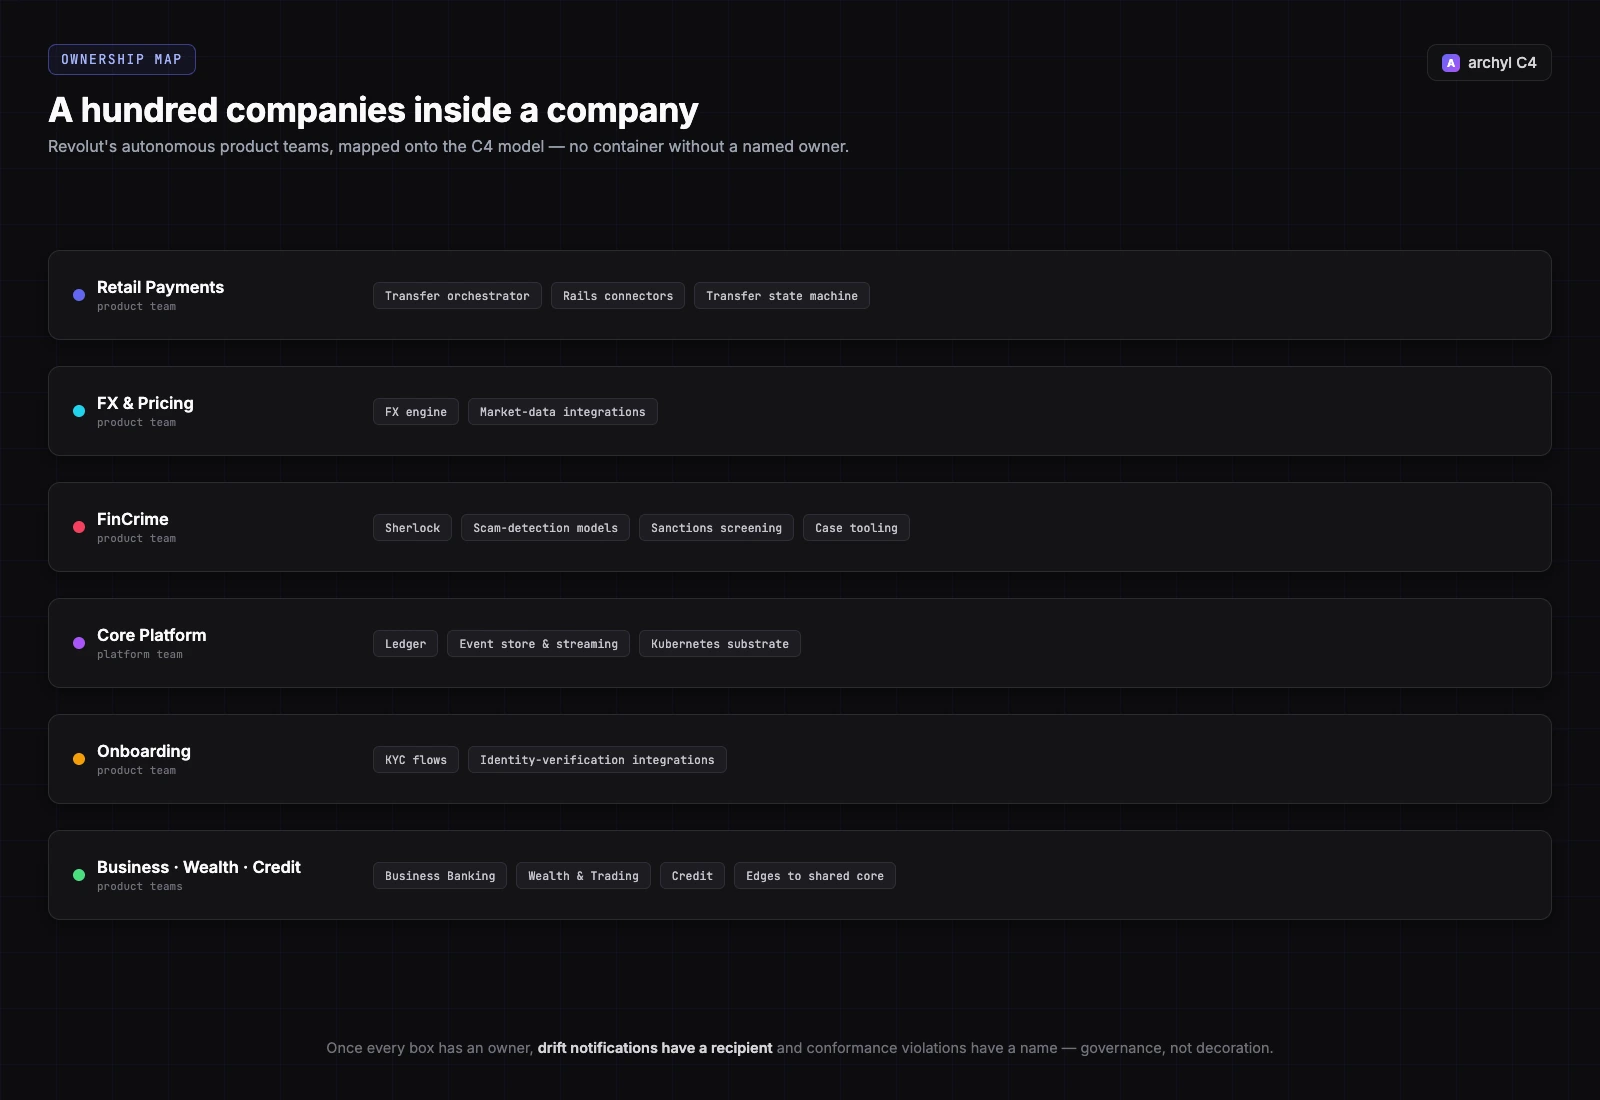
Revolut은 자율적인 제품 팀으로 조직된 것으로 유명합니다 — 리더십은 회사를 "백 개의 스타트업"이라고 표현하며, 각 팀에는 제품의 지표, 로드맵, 서비스에 end-to-end로 책임지는 오너가 있습니다. 이것은 C4 모델에 직접 매핑됩니다:
- Retail Payments 가 transfer orchestrator, rails connectors, transfer 상태 머신을 소유
- FX & Pricing 이 FX 엔진과 시장 데이터 통합을 소유
- FinCrime 이 Sherlock, 스캠 탐지 모델, 제재 스크리닝, 케이스 툴링을 소유
- Core Platform 이 ledger, event store와 스트리밍 플랫폼, Kubernetes 기반을 소유
- Onboarding 이 KYC 플로우와 신원 검증 통합을 소유
- Business, Wealth, Credit 이 각자 자기 제품 시스템과 공유 코어와의 경계를 소유
모든 컨테이너에 오너가 생기면, 모델은 문서화이기를 멈추고 거버넌스가 되기 시작합니다. 다이어그램에 없는 새 서비스가 코드베이스에 나타나면? 특정 팀이 drift 알림을 받습니다. 어떤 컨테이너가 이벤트를 소비하는 대신 ledger를 직접 읽으려 시도하면? 이름이 붙은 컨포먼스 규칙 위반입니다 — 그리고 2026년 3월부터 PRA 감독 아래 운영되는 회사에서 "이 박스는 누가 소유하나" 는 규제 기관도 묻는 질문입니다.
Archyl에서는 Ownership Map과 drift 탐지, 그리고 주간 팀 다이제스트가 Revolut의 조직 설계를 아키텍처의 강제 가능한 속성으로 바꿉니다: Retail Payments의 월요일 다이제스트는 orchestrator와 rails를 커버하고, FinCrime의 다이제스트는 Sherlock과 스크리닝 파이프라인을 커버합니다. 같은 표면, 각 팀의 경계에 스코프됩니다.
이건 훔치고, 이건 건너뛰세요
다른 회사의 아키텍처를 모델링하는 목적은 자기 아키텍처에서 더 나은 결정을 내리기 위함입니다. 우리의 견해:
훔칠 것:
- PostgreSQL 위의, source of truth로서의 이벤트 로그. 첫날부터 Kafka가 필요할 일은 거의 확실히 없습니다. 규율 있는 컨슈머를 가진 append-only 테이블이 replay 가능성, 감사, SQL 디버깅 가능성을 줍니다 — 그리고 컨퍼런스 발표의 통념이 인정하는 것보다 훨씬 멀리 스케일합니다.
- 가장 리스크가 큰 결정에 대한 엄격한 지연 예산. "사기 스코어링은 50 ms 안에 답하거나 플래그와 함께 승인한다"는 시스템의 절반을 대신 설계해 주는 아키텍처 제약입니다.
- 박스당 한 명의 책임 있는 오너. Revolut의 "백 개의 스타트업" 모델은 극단적이지만, 그 C4 번역 — 이름 붙은 팀 없는 컨테이너는 없다 — 은 비용이 들지 않으면서 인시던트 대응과 drift에 관한 모든 것을 바꿉니다.
건너뛸 것 (Revolut의 컨텍스트가 없다면):
- 자체 이벤트 스트리밍 플랫폼 구축. 그 ADR은 월드클래스 플랫폼 팀과 수백 개의 서비스를 가진 다음에 오는 것입니다. 서비스 10개 규모에서는 관리형 메시징이나 평범한 Postgres 큐가 이깁니다.
- 인하우스 카드 프로세싱. 이 결정은 주당 수백만 트랜잭션에서 성과를 냈습니다. 그 아래에서는 아무 이점 없이 PCI 범위와 감사 부담만 남습니다 — ADR-002의 컨텍스트 섹션이 무거운 역할을 하는 이유입니다.
7,000만 고객이 필요하지 않습니다
이 규율은 아래로도 스케일합니다. Context를 Container에서, Container를 Component에서 분리하는 것; path-dependent한 결정을 설명하는 ADR을 작성하는 것 (우리는 Kafka를 건너뛰었다, 프로세싱을 인하우스로 가져왔다, profile store는 샀다); 모든 박스에 오너를 붙이는 것 — 그것이 30개 서비스 스택이 300개 서비스 스택이 되어가는 동안에도 readable하게 유지해 주는 것입니다.
C4 + ADR + Ownership + Drift + 컨포먼스가 Archyl이 out of the box로 제공하는 것입니다. Revolut은 단지 그 규율이 핀테크의 속도로 10년간 복리로 쌓이면 어떤 모습인지를 보여줄 뿐입니다 — Java, Postgres, 그리고 유난히 명확한 ownership으로 제로에서 750억 달러 은행까지.
자신의 아키텍처를 열어보세요. 시스템을 그리세요 (8개든, 3개든). 당신 제품에서 Léa의 £450에 해당하는 것을 컨테이너들을 따라 추적하세요. 시니어 신규 입사자가 첫 주에 물어볼 만한 3개의 ADR을 작성하세요. 모든 박스에 팀을 매핑하세요.
대부분의 엔지니어링 조직이 1년에 도달하는 곳보다 앞서 있을 것입니다.
FAQ
Revolut은 Kafka를 사용하나요? 아니요 — 의도적인 선택입니다. Revolut은 이벤트를 PostgreSQL 기반 event store에 지속화하고 스트리밍/메시징 플랫폼을 Kotlin으로 자체 구축했습니다 (JetBrains Ktor, 코루틴). Kafka 배포보다 유지보수, 커스터마이즈, 쿼리가 쉽다고 판단했습니다.
Revolut은 어떤 데이터베이스를 사용하나요? PostgreSQL이 백본입니다 — source of truth 역할을 하는 event store를 포함해서요. 캐싱을 위한 Redis와 Sherlock 사기 엔진 내부의 인메모리 profile store인 Couchbase가 보완합니다.
Revolut은 어떤 프로그래밍 언어로 작성되었나요? 백엔드는 압도적으로 Java (17/21)이고, 이벤트 스트리밍 플랫폼에는 Kotlin, 타입드 SQL 접근에는 jOOQ를 사용합니다. Google Cloud와 Kubernetes 위에서 실행됩니다.
Revolut은 진짜 은행인가요? 네. Revolut은 EU 은행 라이선스 (리투아니아 은행 경유)로 운영되며, 2024년 7월에 부여된 제한적 라이선스 이후 2026년 3월 PRA로부터 정식 영국 은행 라이선스를 받았습니다.
Revolut은 사기를 어떻게 탐지하나요? 인하우스 머신러닝 시스템인 Sherlock으로요: CatBoost 모델이 Couchbase에 저장된 행동 프로필을 기반으로 모든 카드 트랜잭션을 50밀리초 이내에 스코어링하고, 매일 밤 재학습합니다. Revolut은 처리액 $100당 약 1¢의 사기 손실을 보고하며, 업계 평균은 7–8¢입니다.
자신의 아키텍처를 C4로 모델링하고 싶으신가요? Archyl로 시작하세요. 이 글은 Anatomy 시리즈의 네 번째 포스트입니다 — Stripe: Anatomy of a Charge, Netflix: Anatomy of a Play, Uber: Anatomy of a Ride를 읽어보시거나, 왜 ADR과 C4가 함께 더 잘 작동하는지를 살펴보세요.