Disclaimer. Questo articolo si basa interamente sulle comunicazioni pubbliche di Revolut — il loro engineering blog, talk a conferenze, job posting, report annuali e case study esterni. Non è un documento di architettura ufficiale Revolut. Modelliamo ciò che sappiamo pubblicamente per illustrare come uno stack complesso possa essere reso leggibile con il modello C4. Quando i dettagli sono inferiti invece che affermati da Revolut, lo diciamo.
Anatomia di un Transfer: modellare Revolut in C4 con Archyl
Sono le 19:47 di un venerdì a Parigi. Léa apre Revolut, digita £450, sceglie il suo padrone di casa londinese dai contatti, e tocca Invia. I suoi euro vengono convertiti in sterline al tasso interbancario, sottoposti a screening per frode e sanzioni, scritti su un ledger immutabile, e spinti sul rail Faster Payments del Regno Unito. La banca tradizionale del padrone di casa accredita il denaro prima che Léa abbia rimesso il telefono in tasca.
Quel viaggio di tre secondi attraversa un'app mobile, un API edge, un orchestratore di transfer, un motore FX, una pipeline di financial crime con un budget sotto i 50 millisecondi, un event store, e una rete di pagamento nazionale esterna — il tutto operato da un'azienda che undici anni fa non esisteva.
Revolut in numeri
| Clienti | 70+ milioni (maggio 2026), dai 50M di novembre 2024 |
| Ricavi 2025 | 6 miliardi di dollari (+46% YoY), 2,3 miliardi di profitto ante imposte |
| Volume di transazioni | £1,3 trilioni nel 2025 (+65% YoY) |
| Valutazione | 75 miliardi di dollari |
| Presenza | 40+ paesi — 13M di clienti nel Regno Unito, 6M in Spagna, 5M in Francia |
| Perdite da frode | ~1¢ per $100 processati, contro una media di settore di 7–8¢ |
| Stack core | Java 17/21 & Kotlin, PostgreSQL, GCP, Kubernetes — e, notoriamente, niente Kafka |
Come si comprende uno stack che muove £1,3 trilioni all'anno? Nello stesso modo in cui abbiamo affrontato Stripe, Netflix e Uber in questa serie: non lo si comprende — non in un colpo solo. Si segue una sola azione utente attraverso i quattro livelli C4, si scrivono gli ADR che spiegano le decisioni incontrate lungo il percorso, e si finisce con una mappa di chi possiede ogni scatola.
Le £450 di Léa sono il nostro filo conduttore.
Livello 1 — System Context: una banca, un broker, un exchange e un app store
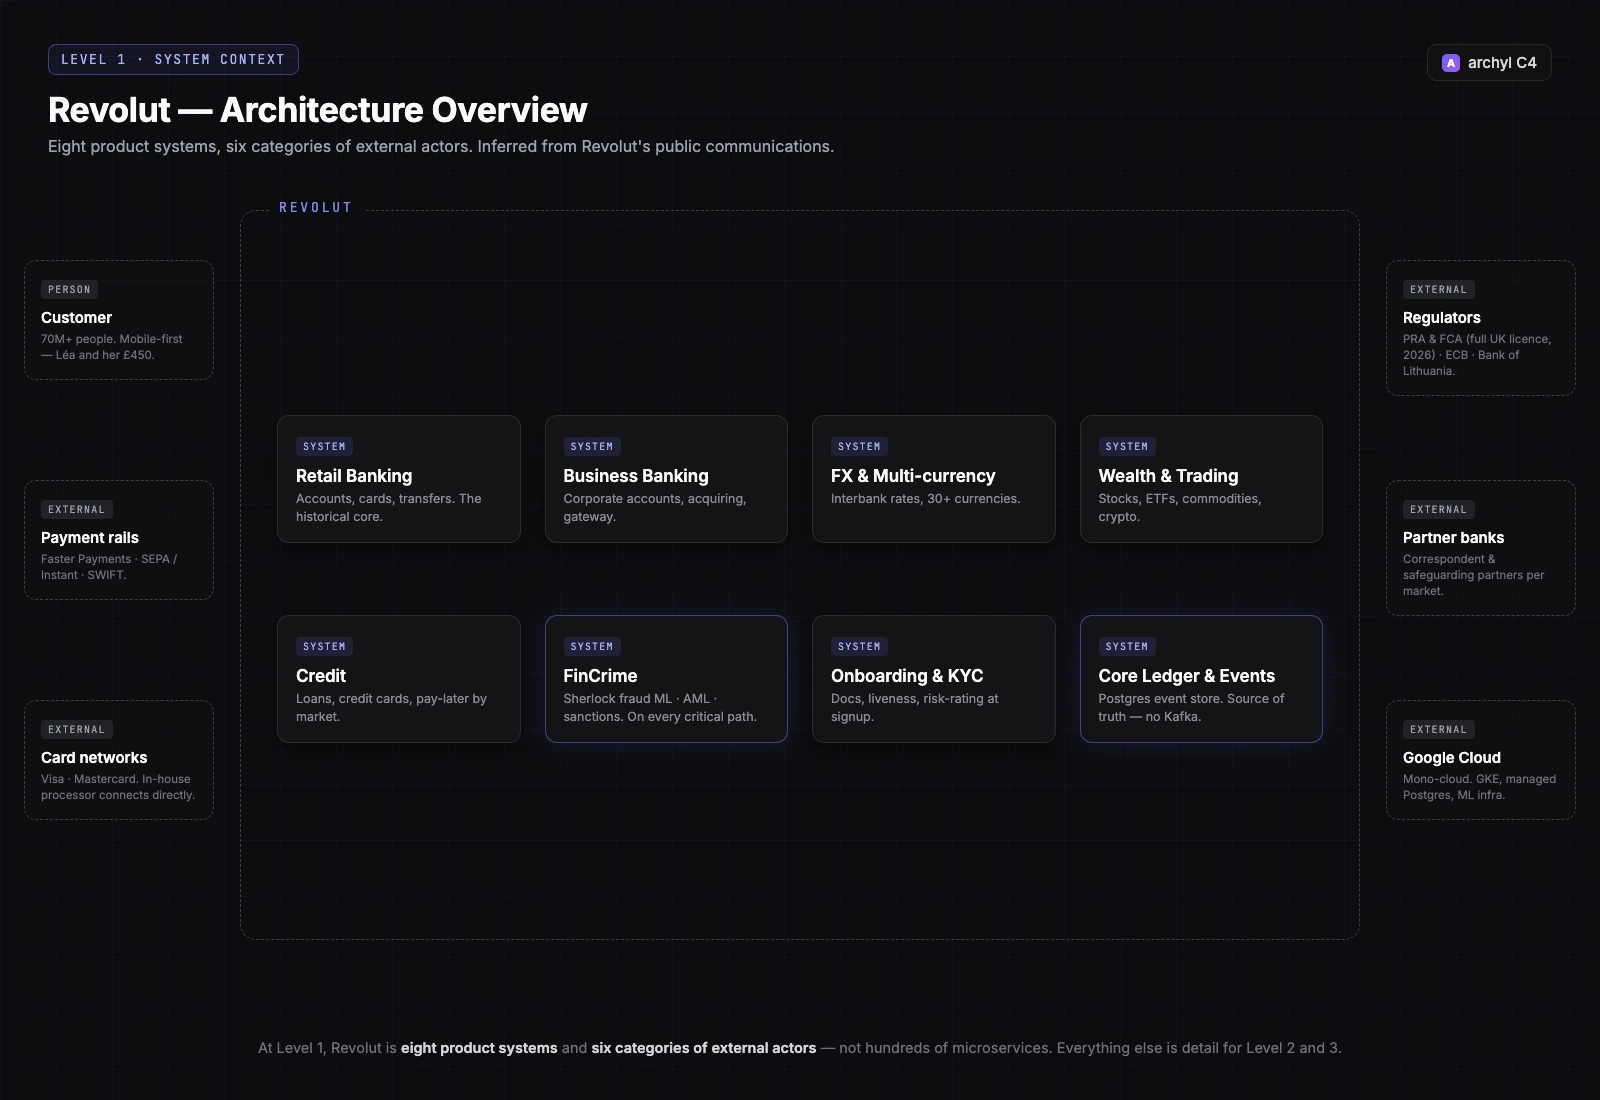
Al livello System Context, Revolut non è "un'app di banking". Le comunicazioni pubbliche descrivono almeno otto sistemi-prodotto che condividono una fondazione:
- Retail Banking — conti multi-valuta, carte, transfer: il cuore storico
- Business Banking — conti, carte corporate, e un ramo di merchant acquiring con il proprio payment gateway
- FX & Multi-currency — il motore di cambio che ha reso Revolut famosa, tassi interbancari su 30+ valute
- Wealth & Trading — azioni, ETF, commodity, crypto
- Credit — prestiti personali, carte di credito, prodotti pay-later per mercato
- FinCrime — scoring di frode (Sherlock), AML, screening sanzioni, rilevazione scam
- Onboarding & KYC — verifica documenti, liveness check, risk-rating alla registrazione
- Core Ledger & Event Backbone — la source of truth su cui ogni prodotto scrive
Intorno: card networks (Visa, Mastercard), payment rails (UK Faster Payments, SEPA e SEPA Instant, SWIFT per la coda lunga), banche partner e corrispondenti, regolatori (la PRA e la FCA nel Regno Unito — Revolut ha ricevuto la sua licenza bancaria UK completa a marzo 2026, dopo la licenza con restrizioni del luglio 2024; la BCE e la Banca di Lituania nell'UE), partner di market data e brokerage per Wealth, e Google Cloud come infrastruttura sottostante.
Otto sistemi, sei categorie di attori esterni. Tutto il resto è dettaglio.
Notate cosa vi dice già il Livello 1 che nessun organigramma dice: FinCrime è un sistema, non una feature. Si trova sul critical path di ogni prodotto — transfer retail, pagamenti con carta, prelievi crypto, payout business. Quando un'azienda disegna il suo context diagram e una scatola riceve frecce da ovunque, quella scatola è o il gioiello della corona o il collo di bottiglia. In Revolut è entrambi, e hanno assegnato il personale di conseguenza.
ADR-001 · Una backbone event-driven — senza Kafka
Stato · Accepted (~2017, ancora attivo nel 2026)
Contesto · Il backend di Revolut è composto da centinaia di microservizi indipendenti che si coordinano scambiando eventi. La risposta di default dell'industria nel 2017 (e probabilmente anche oggi) era Apache Kafka. Ma Kafka porta con sé una pesante superficie operativa: broker, partizioni, rebalancing, tuning della retention — un concern di piattaforma a tempo pieno. La cultura di engineering di Revolut privilegia piccoli team che possiedono primitive semplici e interrogabili.
Decisione · Non adottare Kafka. Persistere gli eventi in un unico event store costruito su PostgreSQL, e costruire il layer di streaming e messaging in-house — scritto in Kotlin su JetBrains Ktor, usando le coroutine per la consegna di eventi ad alta concorrenza. Consumatori come Risk, PnL e la rilevazione frodi leggono dallo store, con read replica che assorbono il carico di query.
Conseguenze · La backbone di eventi è manutenibile da un piccolo team, e — punto cruciale — interrogabile con SQL. Debuggare un pagamento non è un'esplorazione speleologica di log partizionati; è una SELECT. Il trade-off è reale: Revolut possiede la disponibilità, l'ordering e la semantica di delivery che Kafka avrebbe fornito off the shelf. È una decisione che rimane corretta solo finché il team che possiede la piattaforma rimane eccellente.
In Archyl, questo ADR è linkato al sistema Core Ledger & Event Backbone e a ogni container che vi pubblica. Chiunque chieda "perché non c'è Kafka in questo diagramma?" — e ogni senior hire lo chiede — ottiene la risposta in un click.
I tre secondi, su una timeline
Prima di zoomare nel Livello 2, ecco il transfer di Léa come timeline. (Le cifre di latenza sono ordini di grandezza illustrativi, non numeri pubblicati da Revolut.)
| t | Cosa succede | Dove |
|---|---|---|
| 0 ms | Léa tocca Invia | App mobile |
| ~10 ms | Sessione validata, richiesta autenticata e parsata | API edge |
| ~30 ms | Verifica del saldo e riserva dei fondi, transazionalmente | Transfer orchestrator + Ledger (PostgreSQL) |
| ~50 ms | EUR→GBP quotato al tasso interbancario | Motore FX |
| ~100 ms | Screening sanzioni + scoring frode/scam — il budget sotto i 50 ms | Pipeline FinCrime |
| ~150 ms | TransferInitiated appeso all'event store; Risk, PnL, notifiche e analytics lo consumano |
Event backbone |
| ~200 ms | Pagamento sottomesso a Faster Payments | Connettore rail FPS |
| ~2–3 s | La banca ricevente conferma; il ledger finalizza; parte la push notification | Rails + Ledger + Notifiche |
Otto hop, tre dei quali sono side effect irreversibili (riservare i fondi, sottomettere al rail, finalizzare il ledger). Tenete a mente quella struttura — è esattamente ciò che il livello Container deve rendere visibile.
Livello 2 — Container: zoom nel percorso del transfer
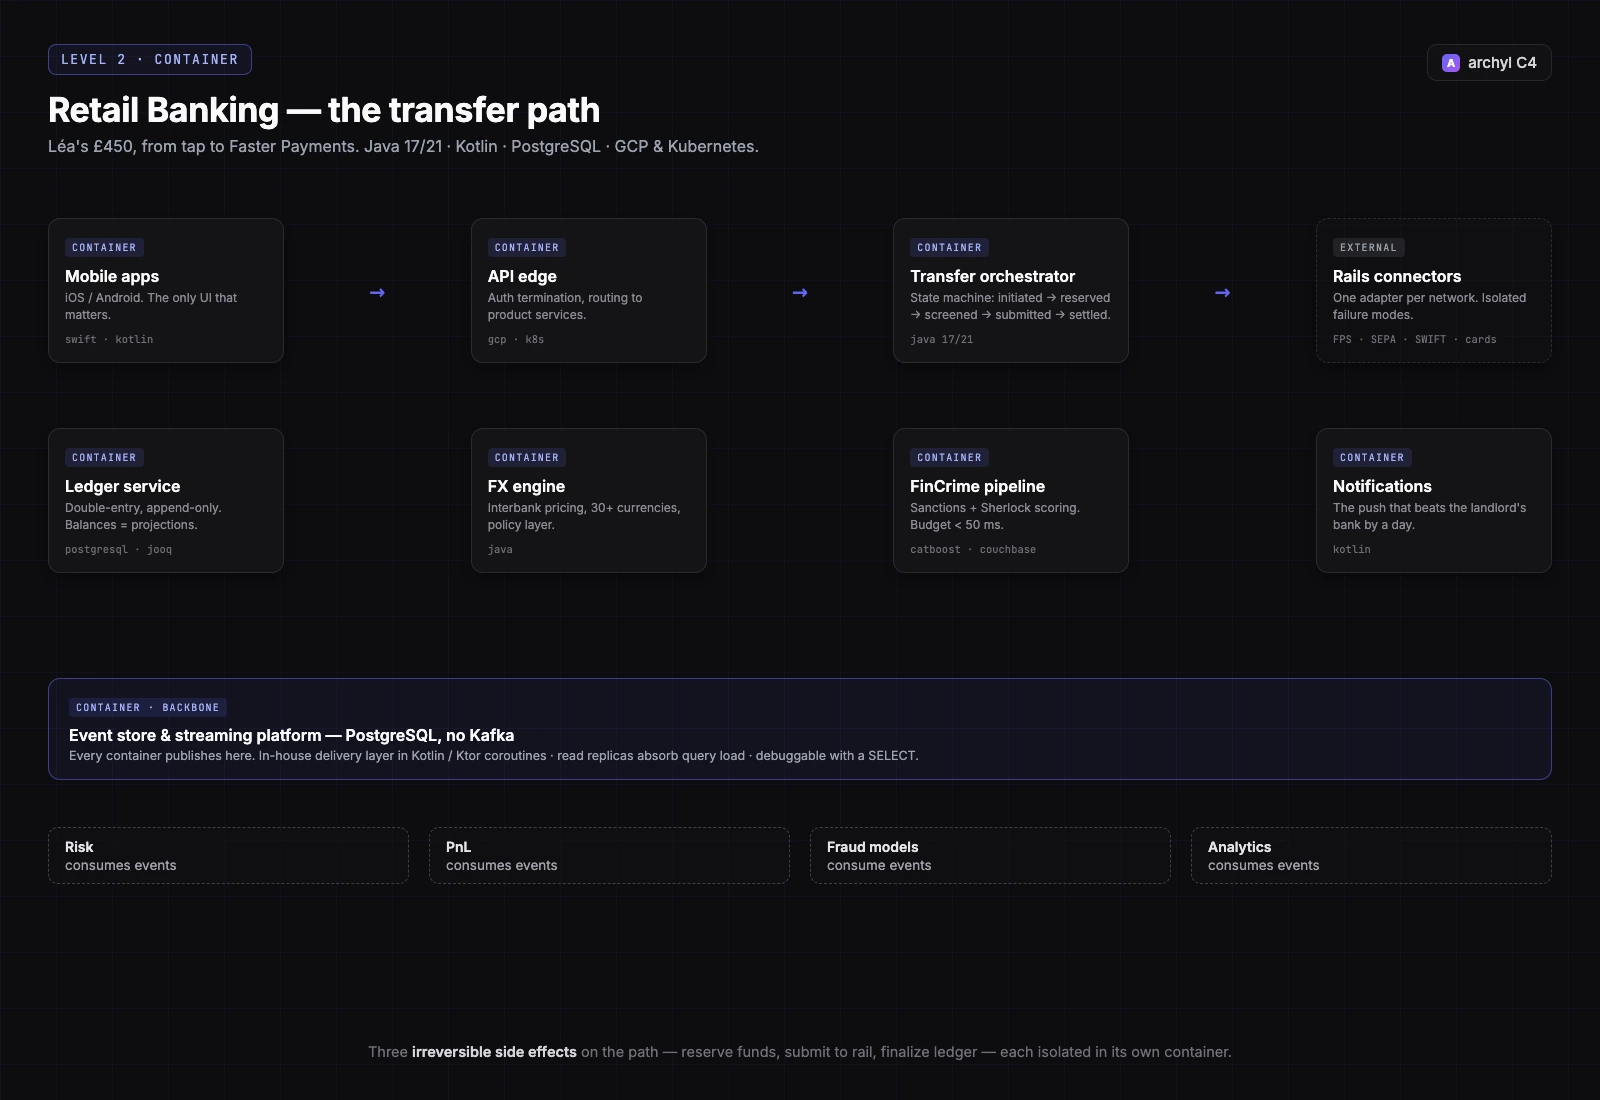
Aprite la scatola Retail Banking e seguite le £450. Le fonti pubbliche — engineering post, talk, e un decennio di job spec — ci permettono di nominare i container sul percorso:
- App mobile — iOS e Android, l'unica interfaccia utente che conta; non esiste una superficie di web banking significativa
- API edge — la porta d'ingresso su GCP, che termina l'auth e instrada verso i servizi prodotto
- Transfer orchestrator — un servizio Java che possiede la state machine del transfer:
initiated→reserved→screened→submitted→settled(o il percorso di compensazione a ogni step) - Ledger service — partita doppia, append-only, su PostgreSQL. I saldi sono proiezioni della storia degli eventi, non righe mutabili
- Motore FX — pricing in tempo reale su 30+ valute, tasso interbancario più policy (markup del weekend, franchigie in base al piano)
- Pipeline FinCrime — screening sanzioni più scoring ML; Sherlock per le frodi carta, modelli dedicati di scam detection per i push payment (zoomiamo al Livello 3)
- Rails connectors — un adapter per rete: Faster Payments, SEPA / SEPA Instant, SWIFT, e il card processor. Ognuno parla il protocollo della propria rete e isola i suoi failure mode
- Event store & streaming platform — la backbone su Postgres dell'ADR-001, con il delivery layer Kotlin/Ktor
- Notification service — il messaggio push che batte l'app della banca del padrone di casa di un giorno intero
Lo stack tecnologico a questo livello, direttamente dai job posting di Revolut: Java 17/21 come linguaggio backend dominante, Kotlin per la streaming platform, PostgreSQL ovunque conti, Redis per il caching, jOOQ per SQL tipato, Flyway per le migrazioni, Spock per i test, tutto su GCP e Kubernetes, osservato tramite Grafana, Prometheus e New Relic.
Notate cosa rende ovvio il diagramma: i rails connectors sono gli unici container il cui failure Revolut non può ingegnerizzare via — Faster Payments down non è un incidente Revolut, ma è un ticket di supporto Revolut. Modellare le dipendenze esterne come container first-class con relazioni esplicite è il modo per rendere quel rischio visibile prima che sia la incident review a renderlo visibile per voi.
ADR-002 · Portare il card processing in-house
Stato · Accepted (~2019, completamente deployato da allora)
Contesto · Come quasi ogni fintech della sua generazione, Revolut è partita su un card processor di terze parti. Il processor sedeva sul critical path di ogni transazione con carta: i suoi outage erano gli outage di Revolut (e facevano notizia), le sue fee per transazione scalavano con la crescita di Revolut, e la sua roadmap faceva da gate alle feature carta di Revolut.
Decisione · Costruire un payment processor in-house e migrarvi il traffico carte. Possedere direttamente la connessione alle card networks.
Conseguenze · Revolut riferisce di processare milioni di pagamenti a settimana su sistemi in-house con uptime quasi perfetto. La unit economics è migliorata esattamente nel momento in cui il volume è esploso, e le feature carta escono sul calendario di Revolut, non su quello di un vendor. Il prezzo: Revolut ora opera infrastruttura in scope PCI che la maggior parte delle aziende giustamente esternalizza, e porta il fardello regolatorio e di audit che ne consegue. Questo ADR ha senso solo oltre un certo volume di transazioni — che è precisamente ciò a cui serve la sezione contesto di un ADR. Copiate la decisione senza il contesto ed è una catastrofe.
Livello 3 — Component: dentro Sherlock, il giudice dei 50 millisecondi
Di tutto lo stack di Revolut, il motore antifrode è la parte più documentata pubblicamente — il team ha pubblicato come lo hanno costruito in nove mesi, e il case study del vendor riempie il data layer. Questo lo rende il nostro miglior candidato per uno zoom a livello Component, esattamente come la idempotency layer di Stripe nel post precedente.
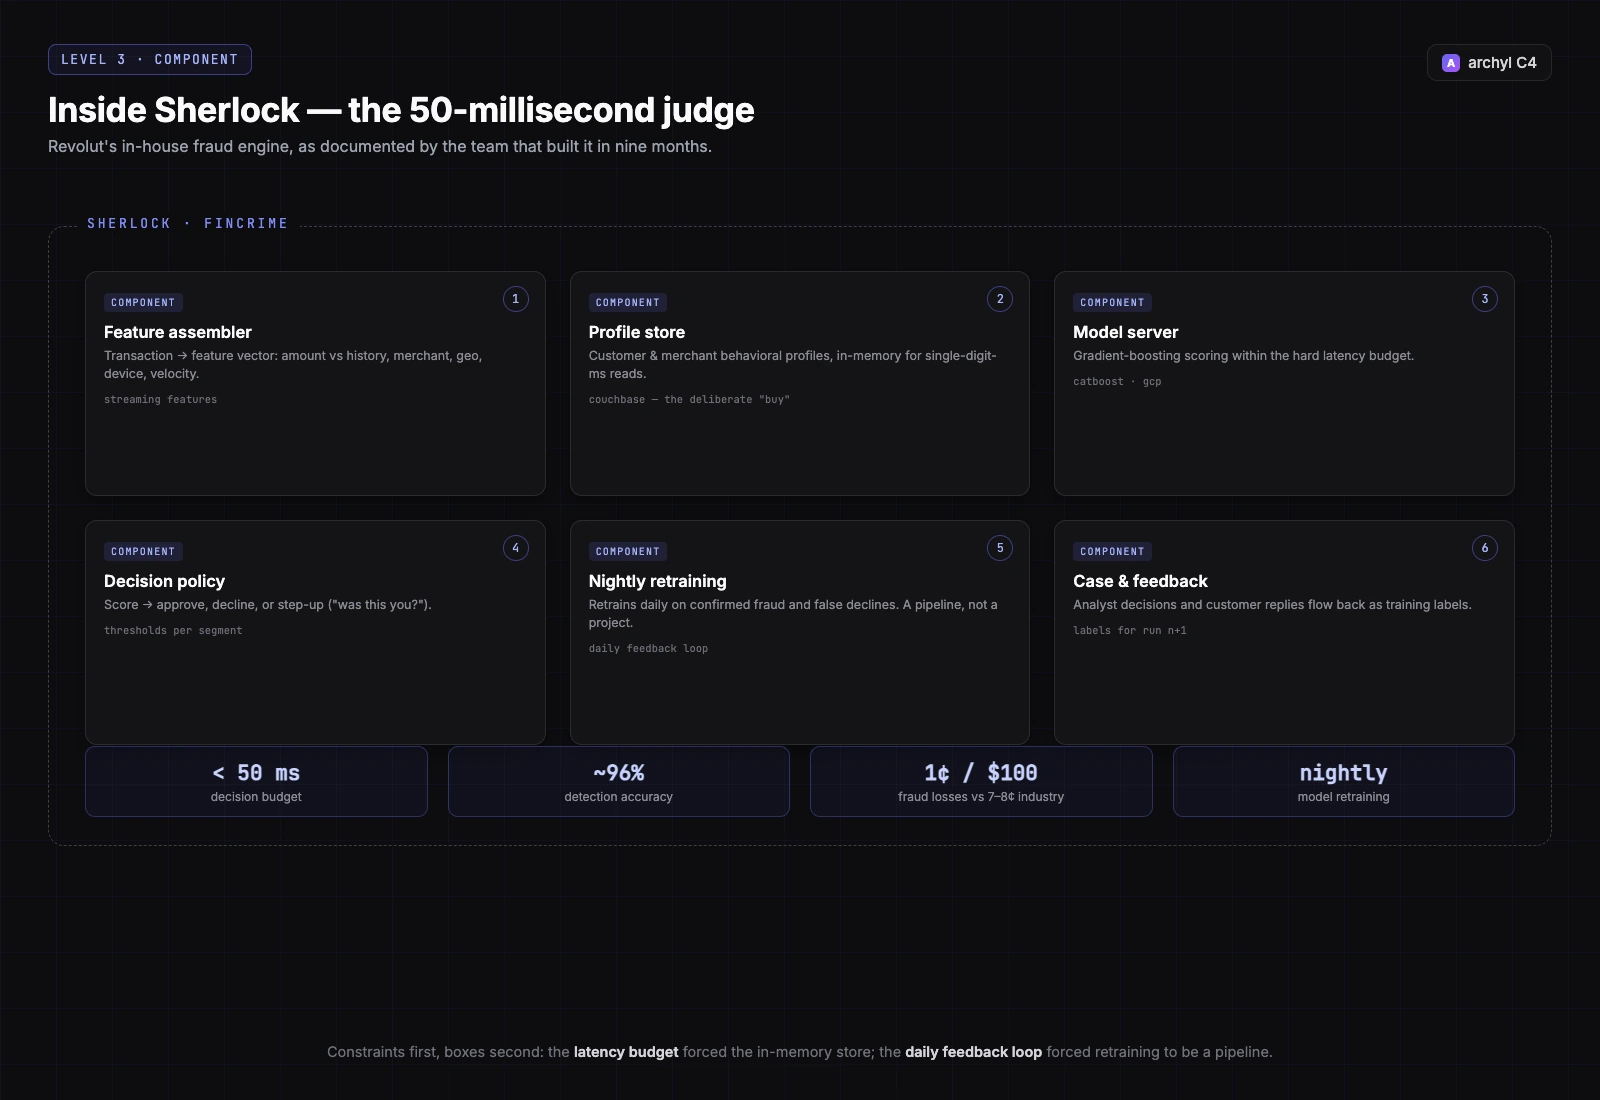
Quando una transazione con carta (o, tramite i modelli scam adiacenti, un push payment come quello di Léa) ha bisogno di un verdetto, attraversa questi componenti:
- Feature assembler — trasforma la transazione grezza in un feature vector: importo vs. storia, categoria merchant, geografia, segnali del device, contatori di velocity
- Profile store — profili comportamentali di clienti e merchant tenuti in Couchbase, un layer NoSQL in-memory, così i lookup restano nei millisecondi a una cifra
- Model server — un modello gradient-boosting CatBoost dà lo score alla transazione; l'intera decisione ha un budget di meno di 50 millisecondi
- Decision policy — le soglie trasformano uno score in un'azione: approve, decline, o step-up (push notification che chiede a Léa "sei stata tu?")
- Nightly retraining pipeline — ogni notte, i modelli si riaddestrano sulle frodi confermate e sui falsi decline della giornata, chiudendo il feedback loop quotidianamente invece che trimestralmente
- Case & feedback service — le decisioni degli analisti e le risposte dei clienti rifluiscono come label per il training run successivo
I risultati riportati: circa 96% di accuratezza di rilevazione e perdite da frode intorno a un centesimo per $100 processati, contro una media di settore di sette-otto centesimi — un gap che vale nell'ordine di 3 milioni di dollari solo nel primo anno.
La lezione architetturale non è "usa CatBoost". È la forma: un budget di latenza rigido ha imposto un profile store in-memory dedicato; un feedback loop quotidiano ha imposto che il retraining fosse una pipeline, non un progetto. Prima i vincoli, poi le scatole.
ADR-003 · Comprare il profile store, costruire tutto il resto
Stato · Accepted (~2018, ancora attivo)
Contesto · La cultura di Revolut è vistosamente build-first: processor in-house (ADR-002), event streaming in-house (ADR-001), banking core in-house. Sherlock aveva bisogno di letture sotto i 10 ms su milioni di profili comportamentali, con write in streaming continuo — un problema risolto nel mercato dei database, e uno in cui "farselo in casa" aggiunge rischio di latenza all'unico componente con il budget più stretto dell'azienda.
Decisione · Comprare: usare Couchbase come profile store in-memory dentro Sherlock, e spendere la capacità di build del team sulle parti che differenziano — feature, modelli, decision policy, e il retraining loop.
Conseguenze · Il team antifrode spedisce modelli, non storage engine. E l'architettura porta una lezione utile nelle sue ossa: persino la cultura di engineering più build-happy della fintech europea compra quando il componente è indifferenziato e il failure mode è spietato. Un ADR che dice "lo abbiamo comprato, ecco perché, ecco cosa ci farebbe rivedere la scelta" vale dieci pagine di wiki di valutazione vendor.
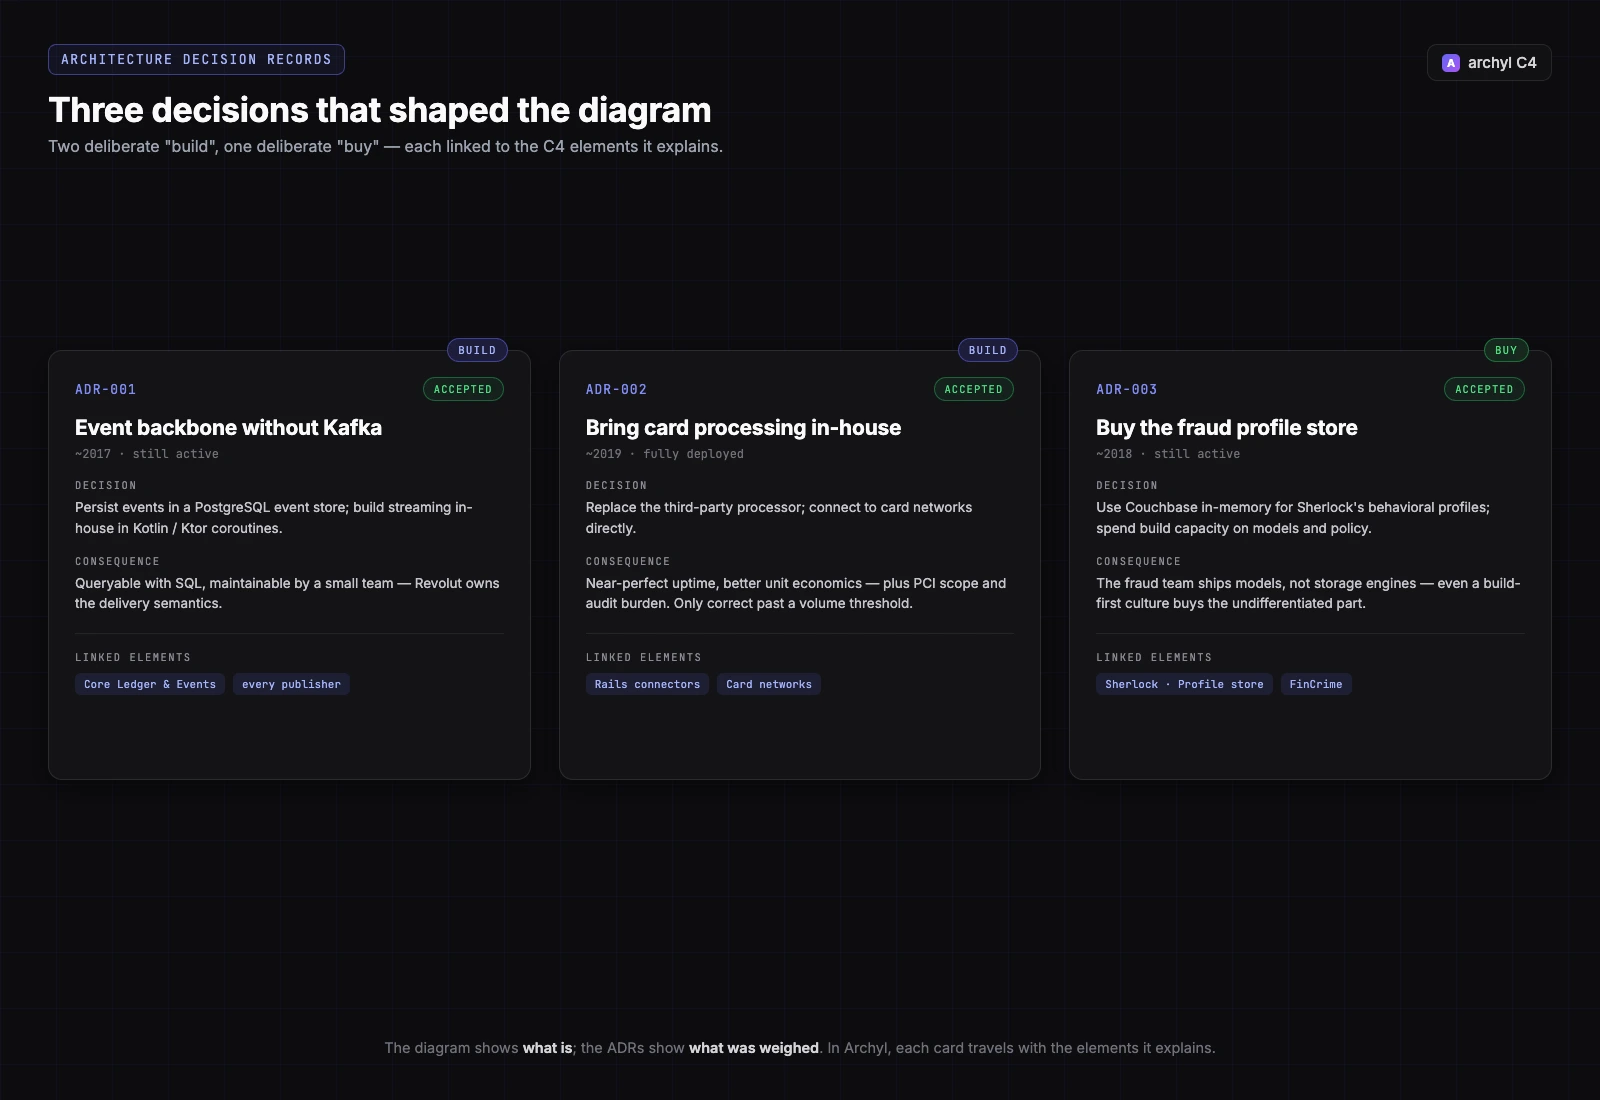
Tre decisioni, tre card in Archyl, ognuna linkata agli elementi C4 a cui dà forma — la event backbone a ogni container che pubblica, il processing in-house ai rails connectors, la scelta buy-vs-build al profile store di Sherlock. Due decisioni "build" e un "buy" deliberato: il diagramma mostra ciò che è; gli ADR mostrano ciò che è stato soppesato.
Ownership: cento aziende dentro un'azienda
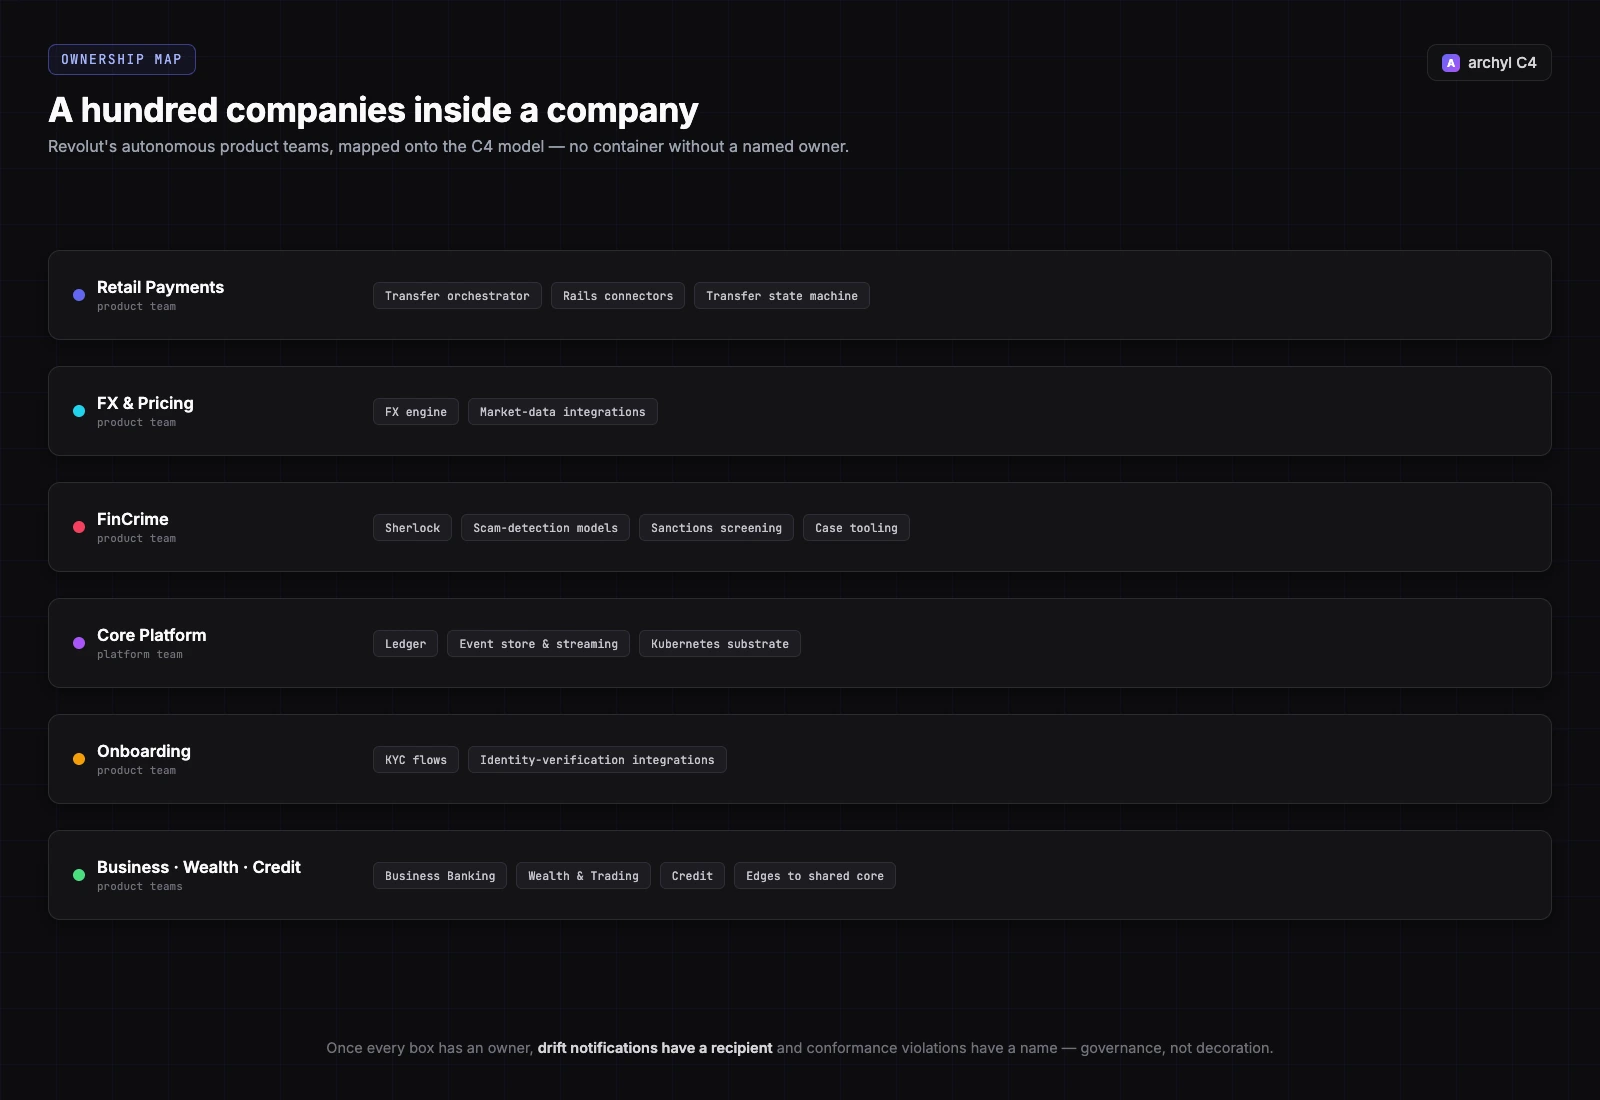
Revolut è notoriamente organizzata in team prodotto autonomi — la leadership parla dell'azienda come di "cento startup", ognuna con un owner responsabile end-to-end delle metriche, della roadmap e dei servizi di un prodotto. Questo si mappa direttamente sul modello C4:
- Retail Payments possiede il transfer orchestrator, i rails connectors, e la state machine del transfer
- FX & Pricing possiede il motore FX e le sue integrazioni di market data
- FinCrime possiede Sherlock, i modelli di scam detection, lo screening sanzioni, e il case tooling
- Core Platform possiede il ledger, l'event store e la streaming platform, e il sostrato Kubernetes
- Onboarding possiede i flussi KYC e le integrazioni di identity verification
- Business, Wealth, Credit possiedono ciascuno i propri sistemi prodotto e i propri edge verso il core condiviso
Una volta che ogni container ha un owner, il modello smette di essere documentazione e inizia a essere governance. Un nuovo servizio appare nel codebase e non è sul diagramma? Un team specifico riceve la notifica di drift. Un container prova a leggere il ledger direttamente invece di consumare eventi? È una violazione di regola di conformità con un nome attaccato — e in un'azienda che opera sotto supervisione PRA da marzo 2026, "chi possiede questa scatola" è una domanda che fanno anche i regolatori.
In Archyl, l'Ownership Map più la rilevazione di drift più il digest settimanale di team trasformano l'org design di Revolut in una proprietà enforceable dell'architettura: il digest del lunedì di Retail Payments copre l'orchestrator e i rails; quello di FinCrime copre Sherlock e la pipeline di screening. Stessa superficie, scoped al perimetro di ogni team.
Da rubare, da evitare
Il punto di modellare l'architettura di qualcun altro è prendere decisioni migliori nella propria. La nostra opinione:
Da rubare:
- L'event log come source of truth, su PostgreSQL. Quasi certamente non avete bisogno di Kafka dal giorno uno. Una tabella append-only con consumatori disciplinati vi dà replayability, audit, e debuggabilità SQL — e scala molto più in là di quanto il consenso da conference talk ammetta.
- Un budget di latenza rigido per la decisione più rischiosa. "Lo scoring di frode risponde in 50 ms o approva con un flag" è un vincolo architetturale che progetta metà del sistema per voi.
- Un owner responsabile per scatola. Il modello "cento startup" di Revolut è estremo, ma la sua traduzione C4 — nessun container senza un team con un nome — non costa nulla e cambia tutto nell'incident response e nel drift.
Da evitare (a meno che non abbiate il contesto di Revolut):
- Costruire la propria piattaforma di event streaming. Quell'ADR è a valle dell'avere un platform team di classe mondiale e centinaia di servizi. A dieci servizi, il messaging managed o semplici code Postgres vincono.
- Il card processing in-house. La decisione ha pagato a milioni di transazioni a settimana. Sotto quella soglia, è scope PCI e fardello di audit senza alcun upside — la sezione contesto dell'ADR-002 sta facendo il grosso del lavoro.
Non avete bisogno di 70 milioni di clienti
La disciplina scala anche verso il basso. Separare Context da Container da Component; scrivere l'ADR che spiega una decisione path-dependent (abbiamo saltato Kafka, abbiamo portato il processing in-house, abbiamo comprato il profile store); attaccare un owner a ogni scatola — è ciò che mantiene leggibile uno stack di trenta servizi mentre diventa uno stack di trecento.
C4 + ADR + Ownership + Drift + Conformità è ciò che Archyl vi dà out of the box. Revolut è semplicemente l'aspetto di quella disciplina composta su un decennio a velocità fintech — da zero a una banca da 75 miliardi di dollari su Java, Postgres, e un'ownership insolitamente chiara.
Aprite la vostra architettura. Disegnate i sistemi (otto, o tre). Seguite l'equivalente delle £450 di Léa del vostro prodotto attraverso i container. Scrivete i tre ADR che un senior hire chiederebbe nella prima settimana. Mappate un team a ogni scatola.
Sarete avanti rispetto a dove la maggior parte delle organizzazioni di engineering arriva in un anno.
FAQ
Revolut usa Kafka? No — per scelta deliberata. Revolut persiste gli eventi in un event store basato su PostgreSQL e ha costruito la sua piattaforma di streaming e messaging in-house in Kotlin (JetBrains Ktor, coroutine), trovandola più facile da mantenere, personalizzare e interrogare rispetto a un deployment Kafka.
Che database usa Revolut? PostgreSQL è la spina dorsale — incluso l'event store che funge da source of truth — complementato da Redis per il caching e Couchbase come profile store in-memory dentro il motore antifrode Sherlock.
In che linguaggio di programmazione è scritto Revolut? Il backend è prevalentemente Java (17/21), con Kotlin per la piattaforma di event streaming e jOOQ per l'accesso SQL tipato. Gira su Google Cloud e Kubernetes.
Revolut è una vera banca? Sì. Revolut opera con una licenza bancaria UE (tramite la Banca di Lituania) e ha ricevuto la sua licenza bancaria UK completa dalla PRA a marzo 2026, dopo la licenza con restrizioni concessa a luglio 2024.
Come rileva le frodi Revolut? Con Sherlock, un sistema di machine learning in-house: modelli CatBoost danno uno score a ogni transazione con carta in meno di 50 millisecondi contro profili comportamentali memorizzati in Couchbase, e si riaddestrano ogni notte. Revolut riporta perdite da frode di circa 1¢ per $100 processati, contro una media di settore di 7–8¢.
Vuoi modellare la tua architettura in C4? Inizia con Archyl. Questo è il quarto post della serie Anatomia — leggi Stripe: Anatomia di un Charge, Netflix: Anatomia di un Play, e Uber: Anatomia di una Ride, o approfondisci perché ADR e C4 funzionano meglio insieme.