Avertissement. Cet article s'appuie exclusivement sur les communications publiques de Revolut — leur blog d'ingénierie, leurs conférences, leurs offres d'emploi, leurs rapports annuels et des études de cas externes. Ce n'est pas un document d'architecture officiel de Revolut. Nous modélisons ce qui est public pour illustrer comment le modèle C4 rend lisible une stack complexe. Quand un détail est déduit plutôt qu'affirmé par Revolut, nous le précisons.
Anatomie d'un virement : modéliser Revolut en C4 avec Archyl
Il est 19h47 un vendredi, à Paris. Léa ouvre Revolut, tape 450 £, sélectionne son propriétaire londonien dans ses contacts, et appuie sur Envoyer. Ses euros sont convertis en livres au taux interbancaire, passés au crible de la fraude et des sanctions, écrits dans un ledger immuable, puis poussés sur le rail britannique Faster Payments. La banque de quartier du propriétaire crédite l'argent avant que Léa ait remis son téléphone dans sa poche.
Ce voyage de trois secondes traverse une application mobile, un edge API, un orchestrateur de virements, un moteur de change, une chaîne de lutte contre la criminalité financière dotée d'un budget inférieur à 50 millisecondes, un event store, et un réseau de paiement national externe — le tout opéré par une entreprise qui n'existait pas il y a onze ans.
Revolut en chiffres
| Clients | 70+ millions (mai 2026), contre 50 M en nov. 2024 |
| Revenus 2025 | 6 milliards $ (+46 % sur un an), 2,3 Md$ de bénéfice avant impôt |
| Volume de transactions | 1 300 milliards £ en 2025 (+65 % sur un an) |
| Valorisation | 75 milliards $ |
| Présence | 40+ pays — 13 M de clients au Royaume-Uni, 6 M en Espagne, 5 M en France |
| Pertes liées à la fraude | ~1 ¢ pour 100 $ traités, contre 7–8 ¢ de moyenne sectorielle |
| Stack cœur | Java 17/21 & Kotlin, PostgreSQL, GCP, Kubernetes — et, célèbre décision, pas de Kafka |
Comment comprendre une stack qui déplace 1 300 milliards de livres par an ? De la même façon que nous avons abordé Stripe, Netflix et Uber dans cette série : on ne comprend pas — pas d'un coup. On suit une seule action utilisateur à travers les quatre niveaux C4, on écrit les ADRs qui expliquent les décisions croisées en chemin, et on termine par la carte des équipes propriétaires de chaque boîte.
Les 450 £ de Léa sont notre fil rouge.
Niveau 1 — System Context : une banque, un courtier, un bureau de change et un app store
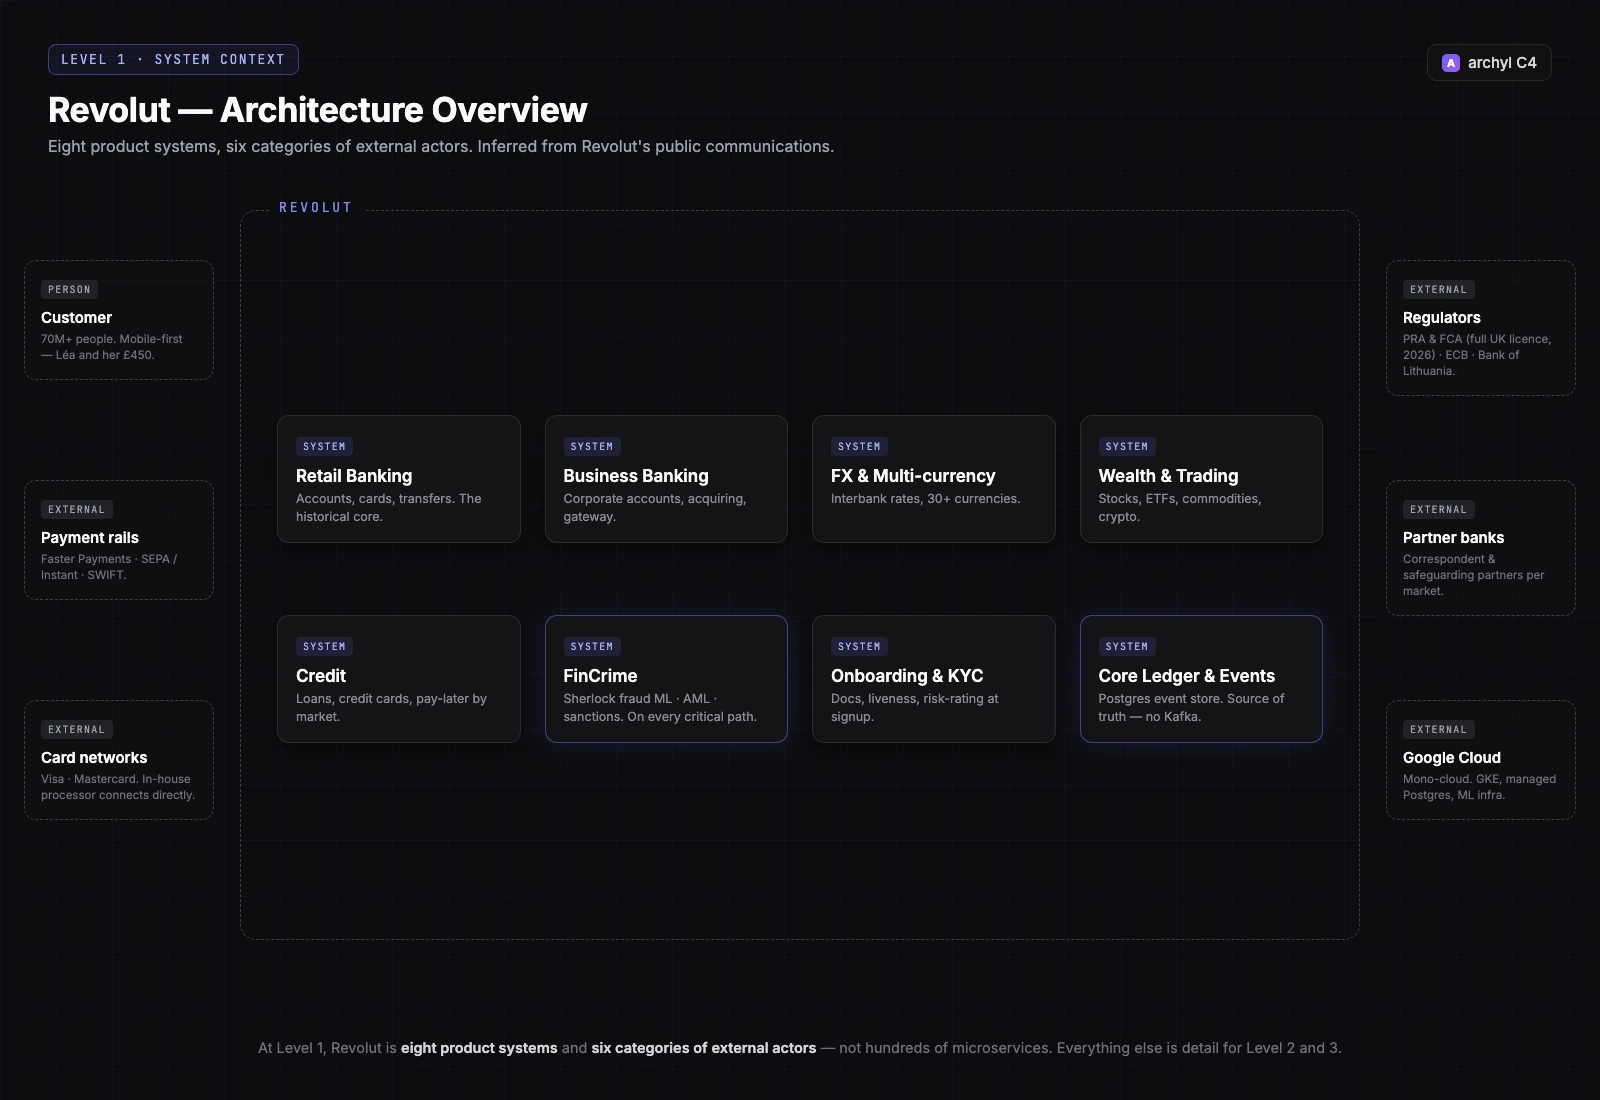
Au niveau System Context, Revolut n'est pas « une app bancaire ». Les communications publiques décrivent au moins huit systèmes produits partageant une même fondation :
- Retail Banking — comptes multi-devises, cartes, virements : le cœur historique
- Business Banking — comptes pro, cartes corporate, et une activité d'acquisition marchande avec sa propre passerelle de paiement
- FX & Multi-devises — le moteur de change qui a fait la réputation de Revolut, taux interbancaire sur 30+ devises
- Wealth & Trading — actions, ETF, matières premières, crypto
- Crédit — prêts personnels, cartes de crédit, paiement différé selon les marchés
- FinCrime — scoring anti-fraude (Sherlock), AML, filtrage des sanctions, détection des arnaques
- Onboarding & KYC — vérification documentaire, détection du vivant, notation de risque à l'inscription
- Core Ledger & Event Backbone — la source de vérité dans laquelle tous les produits écrivent
Autour d'eux : les réseaux de cartes (Visa, Mastercard), les rails de paiement (Faster Payments au Royaume-Uni, SEPA et SEPA Instant, SWIFT pour la longue traîne), les banques partenaires et correspondantes, les régulateurs (la PRA et la FCA au Royaume-Uni — Revolut a obtenu sa licence bancaire britannique complète en mars 2026, après la licence restreinte de juillet 2024 ; la BCE et la Banque de Lituanie dans l'UE), les partenaires de données de marché et de courtage pour Wealth, et Google Cloud comme infrastructure sous-jacente.
Huit systèmes, six catégories d'acteurs externes. Tout le reste est du détail.
Remarquez ce que le niveau 1 vous dit déjà et qu'aucun organigramme ne montre : FinCrime est un système, pas une fonctionnalité. Il est sur le chemin critique de chaque produit — virements retail, paiements par carte, retraits crypto, payouts business. Quand une entreprise dessine son diagramme de contexte et qu'une boîte reçoit des flèches de partout, cette boîte est soit le joyau de la couronne, soit le goulet d'étranglement. Chez Revolut, c'est les deux — et les effectifs suivent.
ADR-001 · Un backbone événementiel — sans Kafka
Statut · Accepté (~2017, toujours en vigueur en 2026)
Contexte · Le backend de Revolut, ce sont des centaines de microservices indépendants qui se coordonnent en échangeant des événements. La réponse par défaut de l'industrie en 2017 (et sans doute encore aujourd'hui) : Apache Kafka. Mais Kafka apporte une surface opérationnelle lourde — brokers, partitions, rebalancing, réglage de la rétention — un sujet plateforme à temps plein. La culture d'ingénierie de Revolut privilégie de petites équipes possédant des primitives simples et requêtables.
Décision · Ne pas adopter Kafka. Persister les événements dans un event store unique construit sur PostgreSQL, et développer la couche de streaming et de messaging en interne — écrite en Kotlin sur JetBrains Ktor, avec des coroutines pour la livraison d'événements à forte concurrence. Les consommateurs comme Risk, PnL et la détection de fraude lisent depuis le store, des read replicas absorbant la charge de lecture.
Conséquences · Le backbone événementiel reste maintenable par une petite équipe et — point crucial — requêtable en SQL. Déboguer un paiement, ce n'est pas spéléologuer dans des logs partitionnés ; c'est un SELECT. La contrepartie est réelle : Revolut assume la disponibilité, l'ordonnancement et les sémantiques de livraison que Kafka aurait fournis sur étagère. C'est une décision qui ne reste juste que tant que l'équipe qui possède la plateforme reste excellente.
Dans Archyl, cet ADR est lié au système Core Ledger & Event Backbone et à chaque conteneur qui y publie. Quiconque demande « pourquoi il n'y a pas de Kafka sur ce diagramme ? » — et chaque senior qui arrive le demande — obtient la réponse en un clic.
Les trois secondes, sur une timeline
Avant de zoomer au niveau 2, voici le virement de Léa sous forme de chronologie. (Les latences sont des ordres de grandeur illustratifs, pas des chiffres publiés par Revolut.)
| t | Ce qui se passe | Où |
|---|---|---|
| 0 ms | Léa appuie sur Envoyer | App mobile |
| ~10 ms | Session validée, requête authentifiée et parsée | Edge API |
| ~30 ms | Vérification du solde et réservation des fonds, transactionnellement | Orchestrateur de virements + Ledger (PostgreSQL) |
| ~50 ms | Cotation EUR→GBP au taux interbancaire | Moteur FX |
| ~100 ms | Filtrage sanctions + scoring fraude/arnaque — le budget < 50 ms | Chaîne FinCrime |
| ~150 ms | TransferInitiated ajouté à l'event store ; Risk, PnL, notifications et analytics le consomment |
Backbone événementiel |
| ~200 ms | Paiement soumis à Faster Payments | Connecteur de rail FPS |
| ~2–3 s | La banque destinataire confirme ; le ledger finalise ; la notification push part | Rails + Ledger + Notifications |
Huit étapes, dont trois effets de bord irréversibles (réserver les fonds, soumettre au rail, finaliser le ledger). Gardez cette structure en tête — c'est exactement ce que le niveau Container doit rendre visible.
Niveau 2 — Container : zoom sur le chemin du virement
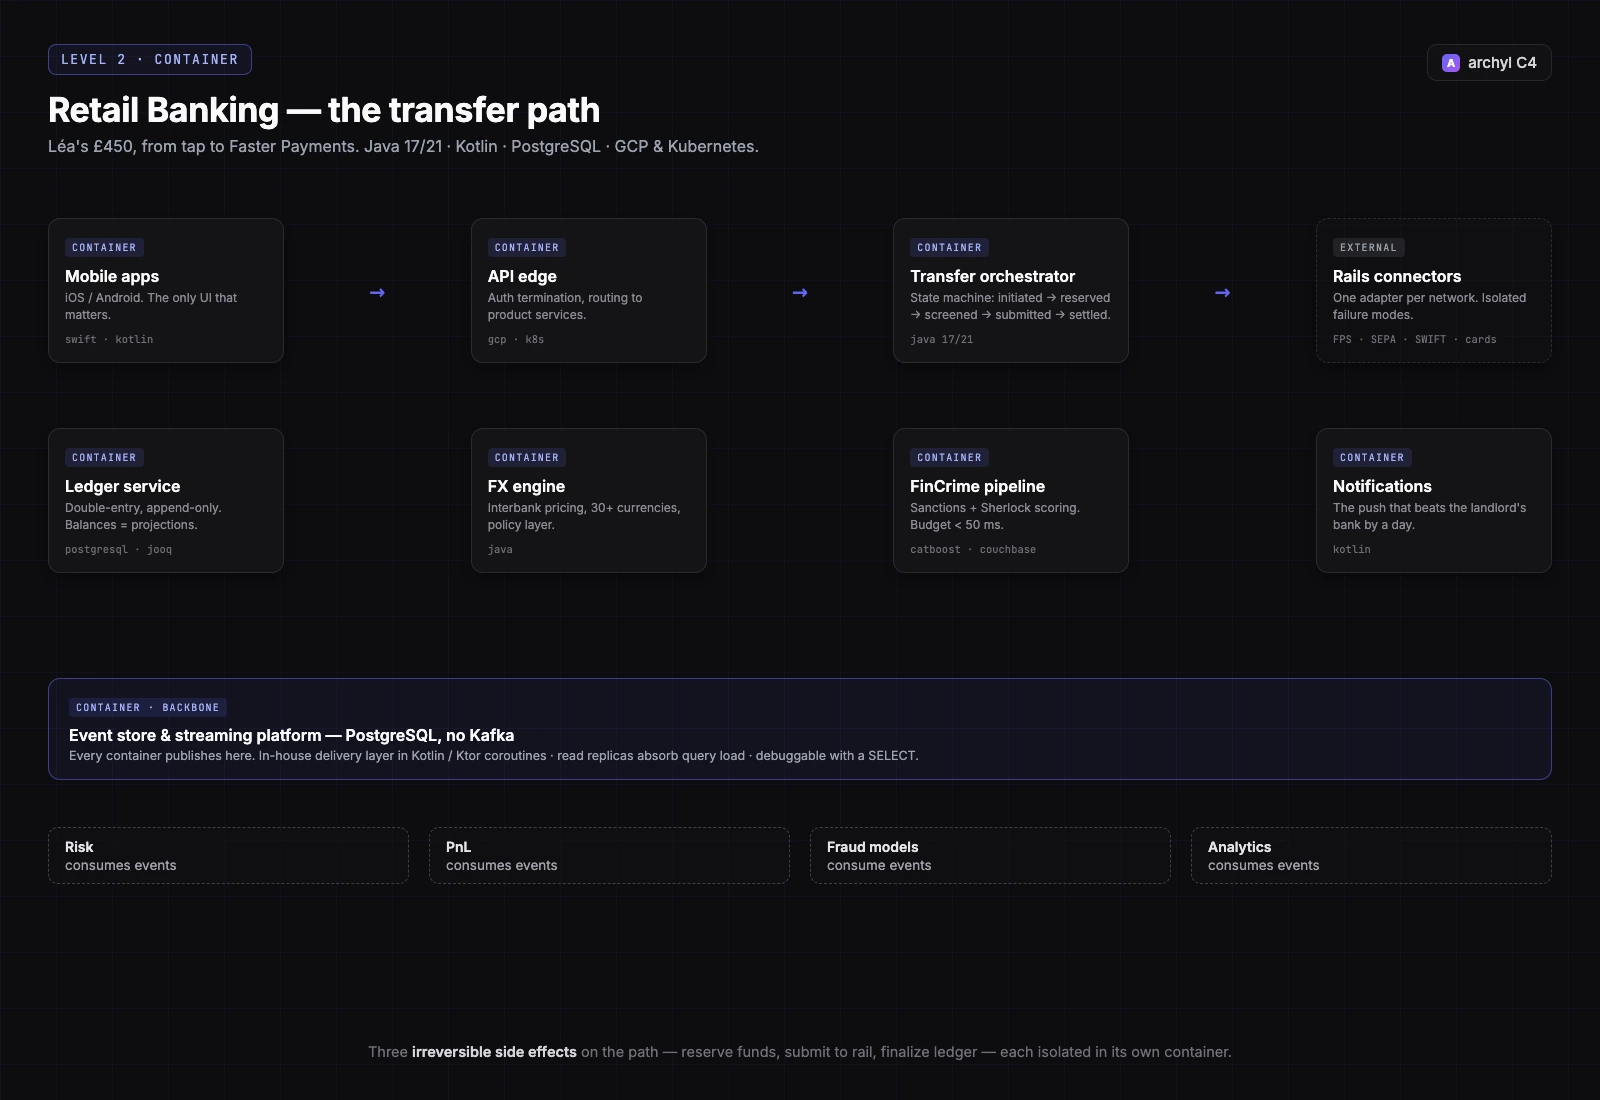
Ouvrez la boîte Retail Banking et suivez les 450 £. Les sources publiques — articles d'ingénierie, conférences et une décennie d'offres d'emploi — permettent de nommer les conteneurs sur le chemin :
- Apps mobiles — iOS et Android, la seule interface utilisateur qui compte ; il n'existe pas de véritable banque web
- Edge API — la porte d'entrée sur GCP, qui termine l'authentification et route vers les services produits
- Orchestrateur de virements — un service Java propriétaire de la machine à états du virement :
initiated→reserved→screened→submitted→settled(ou le chemin de compensation à chaque étape) - Service Ledger — comptabilité en partie double, append-only, sur PostgreSQL. Les soldes sont des projections de l'historique d'événements, pas des lignes mutables
- Moteur FX — pricing temps réel sur 30+ devises, taux interbancaire plus politique commerciale (majorations le week-end, quotas selon les plans)
- Chaîne FinCrime — filtrage des sanctions plus scoring ML ; Sherlock pour la fraude carte, des modèles dédiés de détection d'arnaques pour les virements (on y zoome au niveau 3)
- Connecteurs de rails — un adaptateur par réseau : Faster Payments, SEPA / SEPA Instant, SWIFT, et le processeur carte. Chacun parle le protocole de son réseau et isole ses modes de défaillance
- Event store & plateforme de streaming — le backbone sur Postgres de l'ADR-001, avec la couche de livraison Kotlin/Ktor
- Service de notifications — le push qui devance l'app de la banque du propriétaire d'une journée entière
La stack technique à ce niveau, tout droit sortie des offres d'emploi de Revolut : Java 17/21 comme langage backend dominant, Kotlin pour la plateforme de streaming, PostgreSQL partout où ça compte, Redis pour le cache, jOOQ pour le SQL typé, Flyway pour les migrations, Spock pour les tests, le tout sur GCP et Kubernetes, observé via Grafana, Prometheus et New Relic.
Remarquez ce que le diagramme rend évident : les connecteurs de rails sont les seuls conteneurs dont Revolut ne peut pas s'approprier les pannes — un Faster Payments indisponible n'est pas un incident Revolut, mais c'est bien un ticket de support Revolut. Modéliser les dépendances externes comme des conteneurs à part entière, avec des relations explicites, c'est rendre ce risque visible avant que la revue d'incident ne s'en charge à votre place.
ADR-002 · Internaliser le processing carte
Statut · Accepté (~2019, entièrement déployé depuis)
Contexte · Comme presque toutes les fintechs de sa génération, Revolut a démarré avec un processeur de cartes tiers. Ce processeur était sur le chemin critique de chaque transaction carte : ses pannes étaient les pannes de Revolut (et faisaient les gros titres), ses frais à la transaction croissaient avec la croissance de Revolut, et sa roadmap conditionnait les fonctionnalités carte de Revolut.
Décision · Construire un processeur de paiement en interne et y migrer le trafic carte. Détenir en direct la connexion aux réseaux de cartes.
Conséquences · Revolut annonce traiter des millions de paiements chaque semaine sur ses systèmes internes avec une disponibilité quasi parfaite. L'économie unitaire s'est améliorée exactement au moment où le volume explosait, et les fonctionnalités carte sortent au rythme de Revolut, pas de celui d'un fournisseur. Le prix : Revolut opère désormais une infrastructure dans le périmètre PCI que la plupart des entreprises externalisent à raison, avec la charge réglementaire et d'audit qui l'accompagne. Cet ADR n'a de sens qu'au-delà d'un certain volume de transactions — et c'est précisément à ça que sert la section contexte d'un ADR. Copiez la décision sans le contexte, et c'est la catastrophe.
Niveau 3 — Component : dans Sherlock, le juge des 50 millisecondes
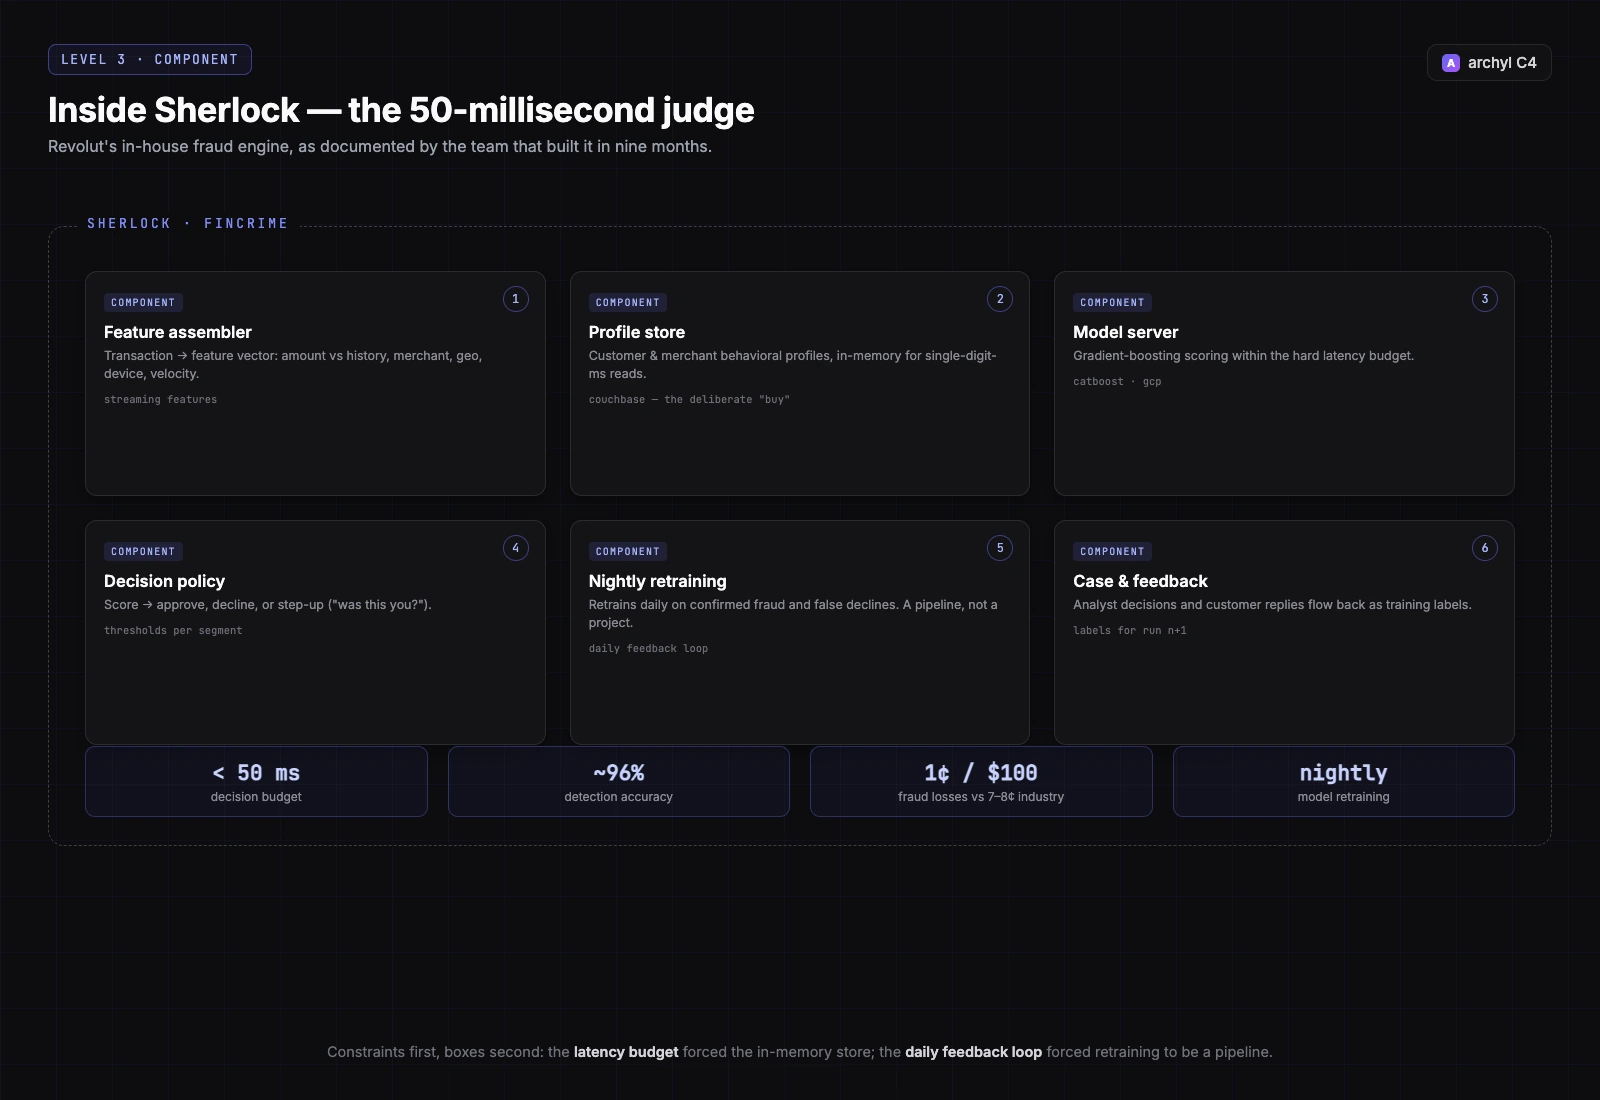
De toute la stack de Revolut, le moteur anti-fraude est l'élément le mieux documenté publiquement — l'équipe a raconté comment elle l'a construit en neuf mois, et l'étude de cas de l'éditeur complète la couche de données. C'est donc notre meilleur candidat pour un zoom au niveau Component, exactement comme la couche d'idempotence de Stripe dans l'article précédent.
Quand une transaction carte (ou, via les modèles adjacents de détection d'arnaques, un virement comme celui de Léa) a besoin d'un verdict, elle traverse ces composants :
- Assembleur de features — transforme la transaction brute en vecteur de caractéristiques : montant vs historique, catégorie du marchand, géographie, signaux du device, compteurs de vélocité
- Store de profils — les profils comportementaux clients et marchands, stockés dans Couchbase, une couche NoSQL en mémoire, pour des lectures en quelques millisecondes
- Serveur de modèles — un modèle de gradient boosting CatBoost score la transaction ; la décision complète dispose d'un budget inférieur à 50 millisecondes
- Politique de décision — des seuils transforment un score en action : approuver, refuser, ou vérifier (notification push demandant à Léa « c'était bien vous ? »)
- Pipeline de réentraînement nocturne — chaque nuit, les modèles se réentraînent sur les fraudes confirmées et les faux refus de la journée, bouclant la boucle de feedback quotidiennement plutôt que trimestriellement
- Service de cas & feedback — les décisions des analystes et les réponses des clients reviennent comme labels pour le prochain entraînement
Les résultats rapportés : environ 96 % de précision de détection et des pertes de fraude autour d'un centime pour 100 $ traités, contre une moyenne sectorielle de sept à huit centimes — un écart qui valait de l'ordre de 3 M$ dès la première année.
La leçon d'architecture n'est pas « utilisez CatBoost ». C'est la forme : un budget de latence dur a imposé un store de profils en mémoire dédié ; une boucle de feedback quotidienne a imposé que le réentraînement soit un pipeline, pas un projet. Les contraintes d'abord, les boîtes ensuite.
ADR-003 · Acheter le store de profils, construire tout le reste
Statut · Accepté (~2018, toujours en vigueur)
Contexte · La culture de Revolut est ostensiblement build-first : processeur interne (ADR-002), streaming événementiel interne (ADR-001), core bancaire interne. Sherlock avait besoin de lectures sous 10 ms sur des millions de profils comportementaux, avec des écritures en flux continu — un problème résolu sur le marché des bases de données, et un cas où « le refaire soi-même » ajoute un risque de latence au composant qui a le budget le plus serré de l'entreprise.
Décision · Acheter : utiliser Couchbase comme store de profils en mémoire au sein de Sherlock, et investir la capacité de build de l'équipe dans ce qui différencie — features, modèles, politique de décision et boucle de réentraînement.
Conséquences · L'équipe fraude livre des modèles, pas des moteurs de stockage. Et l'architecture porte une leçon utile dans ses fondations : même la culture d'ingénierie la plus build-happy de la fintech européenne achète quand le composant est indifférencié et que le mode de défaillance ne pardonne pas. Un ADR qui dit « nous avons acheté ceci, voici pourquoi, voici ce qui nous ferait reconsidérer » vaut dix pages de wiki d'évaluation fournisseur.
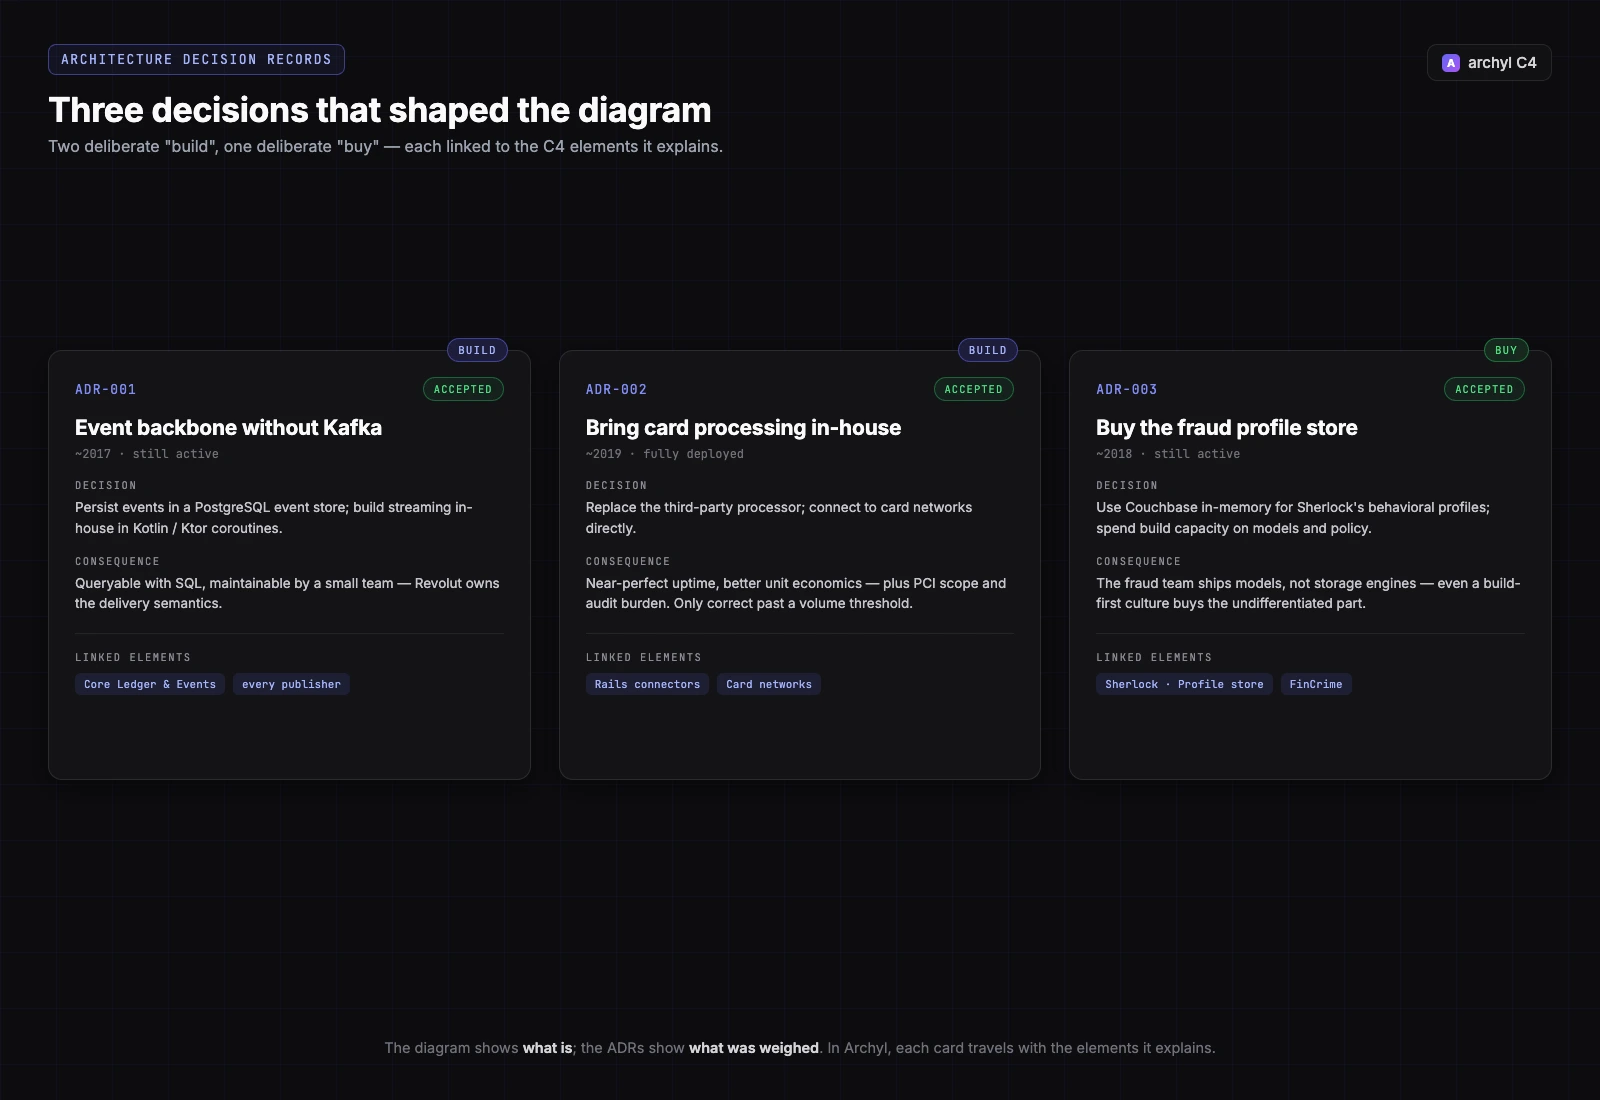
Trois décisions, trois cartes dans Archyl, chacune liée aux éléments C4 qu'elle façonne — le backbone événementiel à chaque conteneur qui y publie, le processing interne aux connecteurs de rails, l'arbitrage buy-vs-build au store de profils de Sherlock. Deux décisions « build » et un « buy » délibéré : le diagramme montre ce qui est ; les ADRs montrent ce qui a été pesé.
Ownership : cent entreprises dans l'entreprise
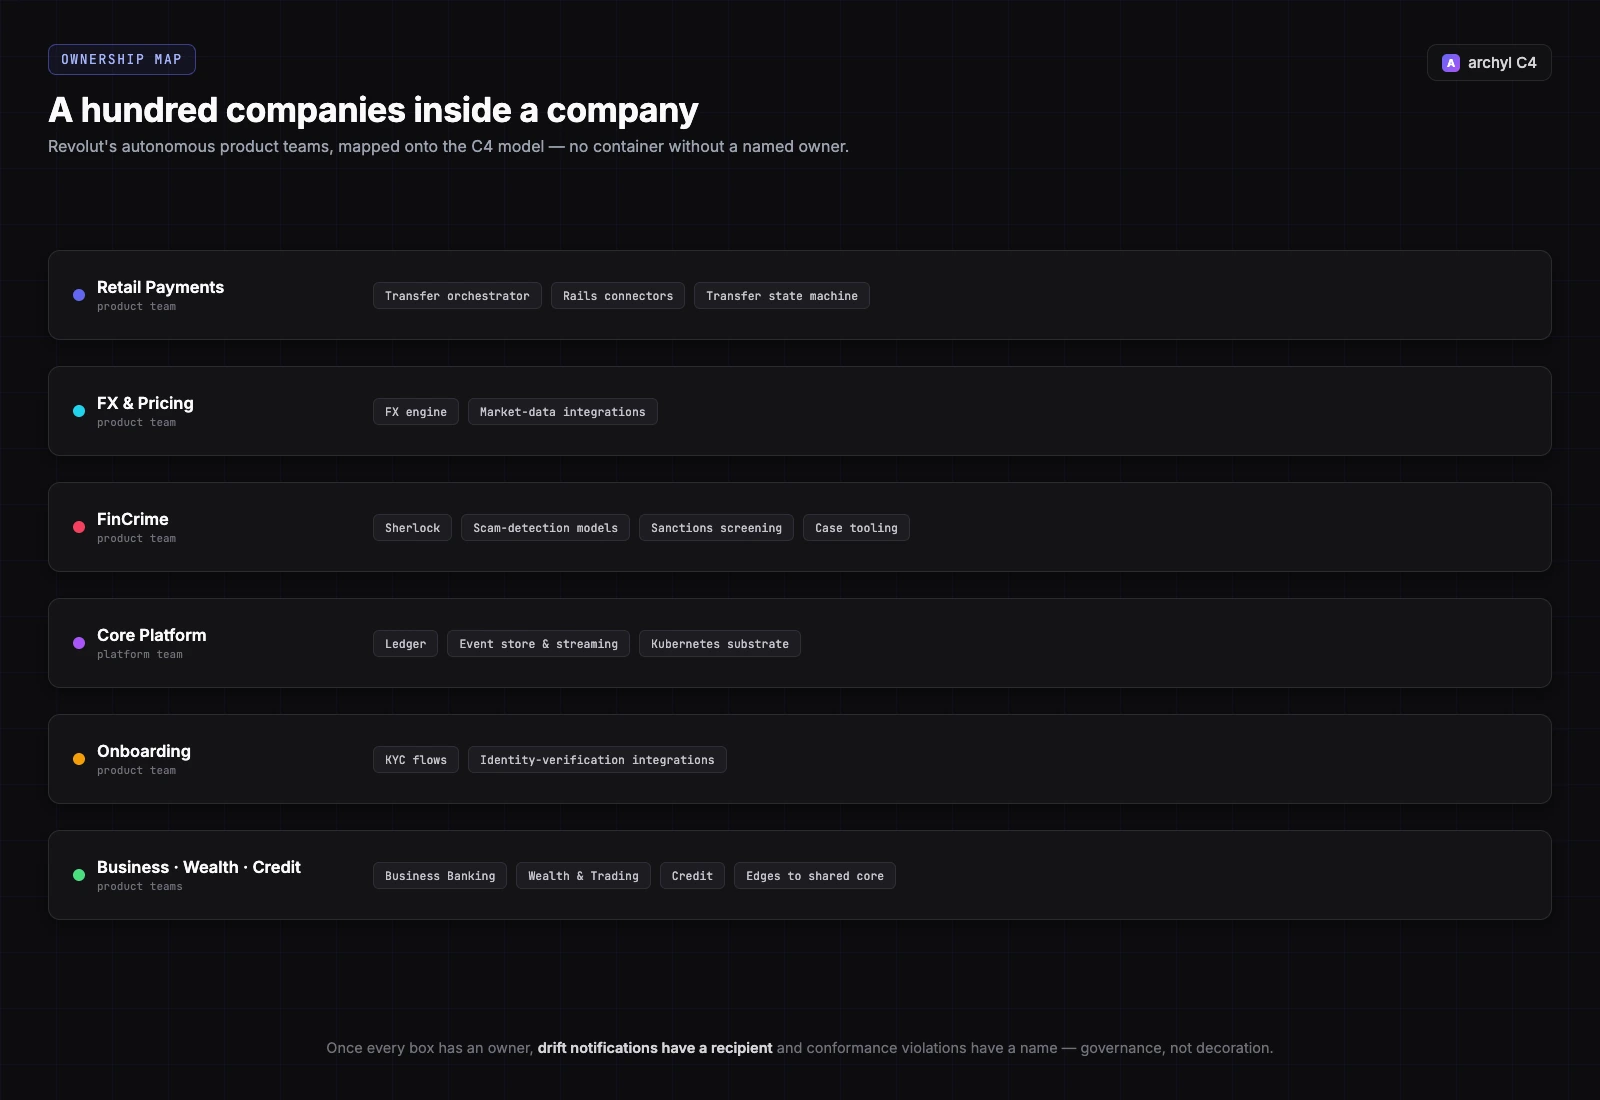
Revolut est célèbre pour son organisation en équipes produits autonomes — la direction décrit l'entreprise comme « une centaine de startups », chacune avec un propriétaire responsable de bout en bout des métriques, de la roadmap et des services d'un produit. Cela se projette directement sur le modèle C4 :
- Retail Payments possède l'orchestrateur de virements, les connecteurs de rails et la machine à états du virement
- FX & Pricing possède le moteur FX et ses intégrations de données de marché
- FinCrime possède Sherlock, les modèles de détection d'arnaques, le filtrage des sanctions et l'outillage des analystes
- Core Platform possède le ledger, l'event store et la plateforme de streaming, ainsi que le socle Kubernetes
- Onboarding possède les parcours KYC et les intégrations de vérification d'identité
- Business, Wealth, Crédit possèdent chacun leur système produit et ses interfaces avec le cœur partagé
Dès que chaque conteneur a un propriétaire, le modèle cesse d'être de la documentation et devient de la gouvernance. Un nouveau service apparaît dans le code sans figurer sur le diagramme ? Une équipe précise reçoit la notification de drift. Un conteneur tente de lire le ledger directement au lieu de consommer les événements ? C'est une violation de règle de conformance avec un nom en face — et dans une entreprise sous supervision de la PRA depuis mars 2026, « qui possède cette boîte » est aussi une question que posent les régulateurs.
Dans Archyl, l'Ownership Map, la détection de drift et le digest hebdomadaire d'équipe transforment le design organisationnel de Revolut en propriété vérifiable de l'architecture : le digest du lundi de Retail Payments couvre l'orchestrateur et les rails ; celui de FinCrime couvre Sherlock et la chaîne de filtrage. Même surface, scopée au périmètre de chaque équipe.
À voler, à éviter
L'intérêt de modéliser l'architecture des autres, c'est de prendre de meilleures décisions dans la vôtre. Notre lecture :
À voler :
- Le log d'événements comme source de vérité, sur PostgreSQL. Vous n'avez presque certainement pas besoin de Kafka au premier jour. Une table append-only avec des consommateurs disciplinés vous donne la rejouabilité, l'audit et le débogage en SQL — et ça tient bien plus loin que ne l'admet le consensus des conférences.
- Un budget de latence dur pour la décision la plus risquée. « Le scoring fraude répond en 50 ms ou il approuve avec un flag » est une contrainte d'architecture qui conçoit la moitié du système à votre place.
- Un propriétaire responsable par boîte. Le modèle « cent startups » de Revolut est extrême, mais sa traduction C4 — aucun conteneur sans équipe nommée — ne coûte rien et change tout dans la réponse aux incidents et le drift.
À éviter (sauf à avoir le contexte de Revolut) :
- Construire votre propre plateforme de streaming événementiel. Cet ADR découle d'une équipe plateforme de classe mondiale et de centaines de services. À dix services, un messaging managé ou de simples queues Postgres gagnent.
- Le processing carte en interne. La décision a payé à des millions de transactions par semaine. En dessous, c'est du périmètre PCI et de la charge d'audit sans contrepartie — la section contexte de l'ADR-002 fait tout le travail.
Vous n'avez pas besoin de 70 millions de clients
La discipline fonctionne à toutes les échelles. Séparer le Context du Container du Component ; écrire l'ADR qui explique une décision dépendante du chemin (nous avons évité Kafka, nous avons internalisé le processing, nous avons acheté le store de profils) ; attacher un propriétaire à chaque boîte — c'est ce qui garde une stack de trente services lisible pendant qu'elle en devient trois cents.
C4 + ADRs + Ownership + Drift + Conformance, c'est ce qu'Archyl vous donne nativement. Revolut est simplement ce à quoi ressemble cette discipline composée pendant une décennie à la vitesse d'une fintech — de zéro à une banque valorisée 75 Md$ sur Java, Postgres et un ownership inhabituellement clair.
Ouvrez votre propre architecture. Dessinez les systèmes (huit, ou trois). Suivez l'équivalent des 450 £ de Léa dans vos conteneurs. Écrivez les trois ADRs qu'un senior demanderait dès sa première semaine. Associez une équipe à chaque boîte.
Vous serez en avance sur ce que la plupart des organisations d'ingénierie atteignent en un an.
FAQ
Revolut utilise-t-il Kafka ? Non — par choix délibéré. Revolut persiste ses événements dans un event store construit sur PostgreSQL et a développé sa plateforme de streaming et de messaging en interne, en Kotlin (JetBrains Ktor, coroutines), la jugeant plus simple à maintenir, personnaliser et requêter qu'un déploiement Kafka.
Quelle base de données utilise Revolut ? PostgreSQL est la colonne vertébrale — y compris pour l'event store qui sert de source de vérité — complété par Redis pour le cache et Couchbase comme store de profils en mémoire au sein du moteur anti-fraude Sherlock.
En quel langage Revolut est-il écrit ? Le backend est majoritairement en Java (17/21), avec Kotlin pour la plateforme de streaming événementiel et jOOQ pour l'accès SQL typé. Le tout tourne sur Google Cloud et Kubernetes.
Revolut est-il une vraie banque ? Oui. Revolut opère sous une licence bancaire européenne (via la Banque de Lituanie) et a reçu sa licence bancaire britannique complète de la PRA en mars 2026, après la licence restreinte accordée en juillet 2024.
Comment Revolut détecte-t-il la fraude ? Avec Sherlock, un système de machine learning maison : des modèles CatBoost scorent chaque transaction carte en moins de 50 millisecondes contre des profils comportementaux stockés dans Couchbase, et se réentraînent chaque nuit. Revolut rapporte des pertes de fraude d'environ 1 ¢ pour 100 $ traités, contre 7–8 ¢ de moyenne sectorielle.
Envie de modéliser votre propre architecture en C4 ? Commencez avec Archyl. C'est le quatrième article de la série Anatomy — lisez Stripe : Anatomie d'un Charge, Netflix : Anatomie d'un Play et Uber : Anatomie d'un Ride, ou plongez dans pourquoi ADRs et C4 fonctionnent mieux ensemble.