Aviso. Este artículo se basa íntegramente en las comunicaciones públicas de Revolut — su engineering blog, charlas de conferencias, job postings, informes anuales y casos de estudio externos. No es un documento oficial de arquitectura de Revolut. Modelamos lo que sabemos públicamente para ilustrar cómo un stack complejo puede hacerse legible con el modelo C4. Cuando los detalles son inferidos en vez de afirmados por Revolut, lo decimos.
Anatomía de una Transferencia: modelando Revolut en C4 con Archyl
Son las 19:47 de un viernes en París. Léa abre Revolut, teclea £450, elige a su casero de Londres entre sus contactos y pulsa Enviar. Sus euros se convierten a libras al tipo interbancario, pasan el screening de fraude y sanciones, se escriben en un ledger inmutable y se empujan al rail de Faster Payments del Reino Unido. El banco tradicional del casero acredita el dinero antes de que Léa haya vuelto a guardar el teléfono en el bolsillo.
Ese viaje de tres segundos atraviesa una app móvil, un API edge, un orquestador de transferencias, un motor de FX, un pipeline de financial crime con un budget de menos de 50 milisegundos, un event store, y una red de pagos nacional externa — todo operado por una empresa que no existía hace once años.
Revolut en cifras
| Clientes | 70+ millones (mayo 2026), frente a 50M en nov 2024 |
| Ingresos 2025 | 6 mil millones de dólares (+46% interanual), 2,3 mil millones de beneficio antes de impuestos |
| Volumen de transacciones | £1,3 trillones en 2025 (+65% interanual) |
| Valoración | 75 mil millones de dólares |
| Presencia | 40+ países — 13M de clientes en el Reino Unido, 6M en España, 5M en Francia |
| Pérdidas por fraude | ~1¢ por cada $100 procesados, frente a una media de la industria de 7–8¢ |
| Stack core | Java 17/21 & Kotlin, PostgreSQL, GCP, Kubernetes — y, famosamente, sin Kafka |
¿Cómo entiendes un stack que mueve £1,3 trillones al año? De la misma forma en que abordamos Stripe, Netflix y Uber en esta serie: no lo entiendes — no de un golpe. Sigues una sola acción de usuario a través de los cuatro niveles C4, escribes los ADRs que explican las decisiones que encuentras en el camino, y terminas con un mapa de quién posee cada caja.
Las £450 de Léa son nuestro hilo conductor.
Nivel 1 — System Context: un banco, un broker, un exchange y una app store
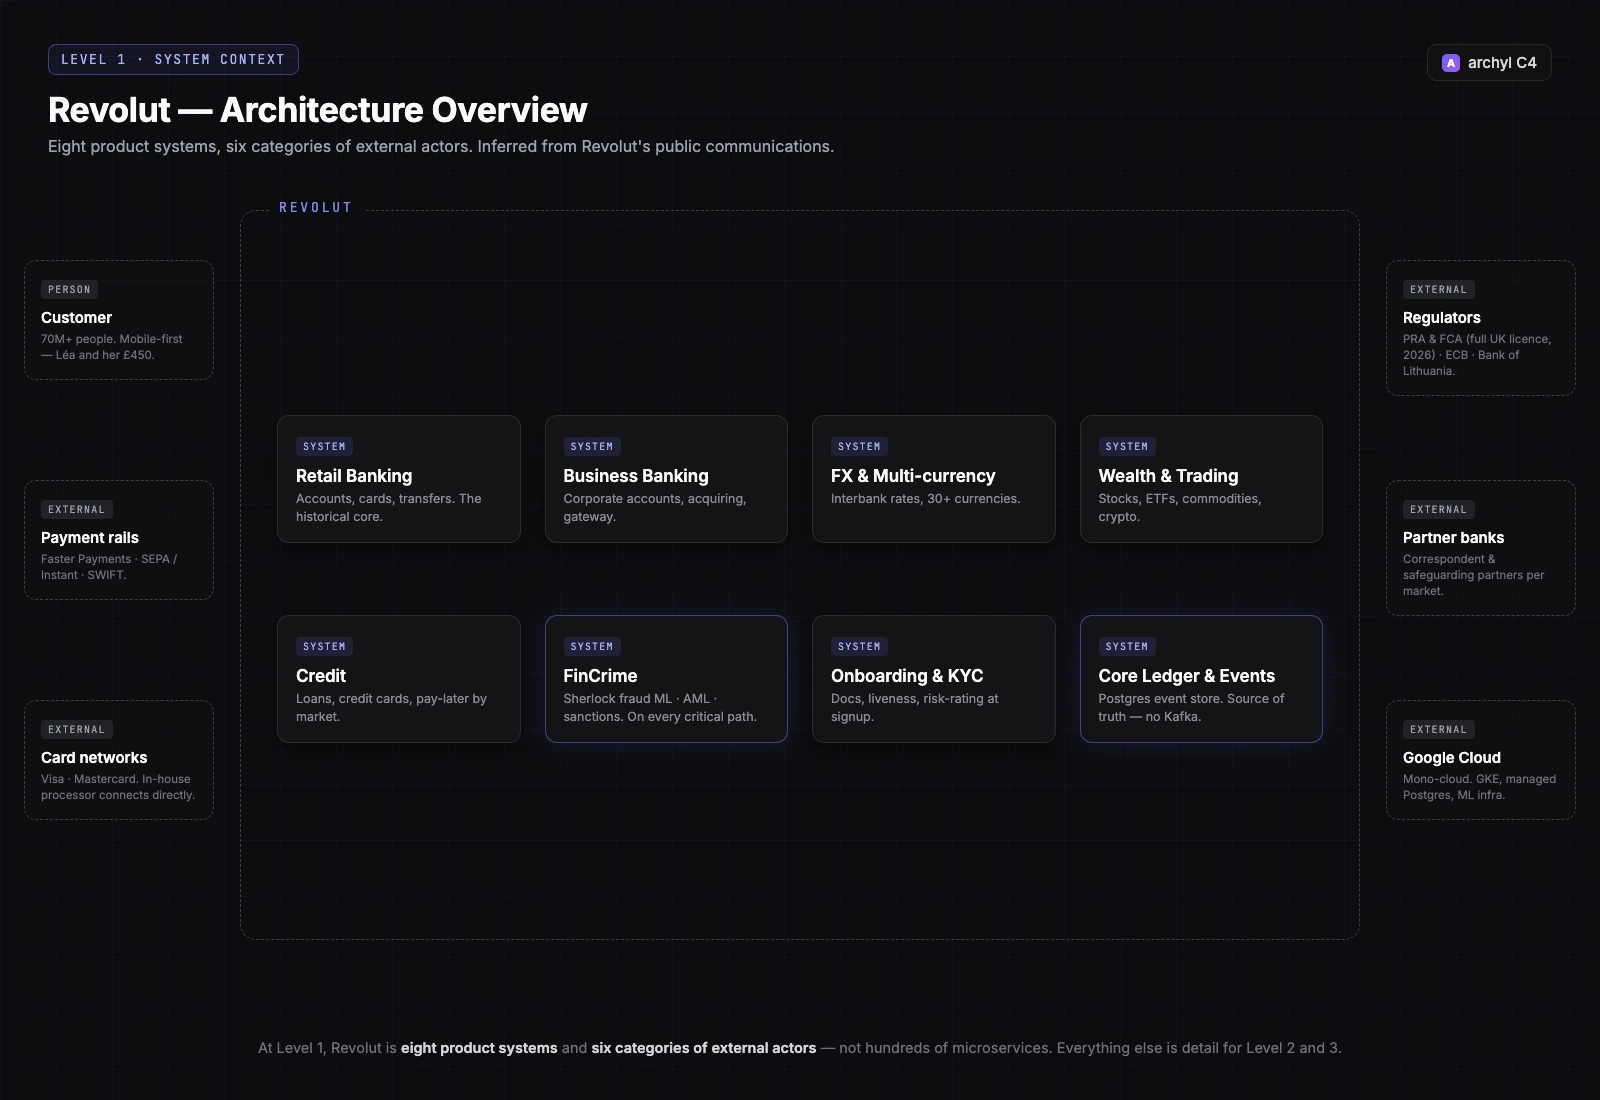
En el nivel System Context, Revolut no es "una app de banca". Las comunicaciones públicas describen al menos ocho sistemas-producto compartiendo una base:
- Retail Banking — cuentas multi-divisa, tarjetas, transferencias: el núcleo histórico
- Business Banking — cuentas, tarjetas corporativas, y un brazo de merchant acquiring con su propio payment gateway
- FX & Multi-currency — el motor de cambio que hizo famoso a Revolut, tipos interbancarios en 30+ divisas
- Wealth & Trading — acciones, ETFs, commodities, crypto
- Credit — préstamos personales, tarjetas de crédito, productos pay-later según el mercado
- FinCrime — scoring de fraude (Sherlock), AML, screening de sanciones, detección de scams
- Onboarding & KYC — verificación de documentos, liveness checks, risk-rating al registrarse
- Core Ledger & Event Backbone — la source of truth en la que escribe cada producto
Alrededor: redes de tarjetas (Visa, Mastercard), rails de pago (UK Faster Payments, SEPA y SEPA Instant, SWIFT para la long tail), bancos partner y corresponsales, reguladores (la PRA y la FCA en el Reino Unido — Revolut recibió su licencia bancaria británica completa en marzo de 2026, tras la licencia restringida de julio de 2024; el BCE y el Banco de Lituania en la UE), partners de market data y brokerage para Wealth, y Google Cloud como infraestructura subyacente.
Ocho sistemas, seis categorías de actores externos. Todo lo demás es detalle.
Fíjate en lo que el Nivel 1 ya te dice y ningún organigrama te dice: FinCrime es un sistema, no una feature. Está en el critical path de cada producto — transferencias retail, pagos con tarjeta, retiradas de crypto, payouts business. Cuando una empresa dibuja su diagrama de contexto y una caja tiene flechas desde todas partes, esa caja es o la joya de la corona o el cuello de botella. En Revolut es ambas cosas, y la dotaron de equipo en consecuencia.
ADR-001 · Un backbone event-driven — sin Kafka
Estado · Accepted (~2017, todavía activo en 2026)
Contexto · El backend de Revolut son cientos de microservicios independientes que se coordinan intercambiando eventos. La respuesta por defecto de la industria en 2017 (y podría decirse que hoy) era Apache Kafka. Pero Kafka trae una superficie operacional pesada: brokers, particiones, rebalancing, tuning de retención — una preocupación de plataforma a tiempo completo. La cultura de ingeniería de Revolut favorece equipos pequeños que poseen primitivas simples y queryables.
Decisión · No adoptar Kafka. Persistir los eventos en un único event store construido sobre PostgreSQL, y construir la capa de streaming y messaging in-house — escrita en Kotlin sobre JetBrains Ktor, usando coroutines para delivery de eventos de alta concurrencia. Consumidores como Risk, PnL y detección de fraude leen del store, con read replicas absorbiendo la carga de queries.
Consecuencias · El event backbone es mantenible por un equipo pequeño y — crucialmente — queryable con SQL. Debuggear un pago no es hacer espeleología en logs particionados; es un SELECT. El trade-off es real: Revolut posee las semánticas de disponibilidad, ordering y delivery que Kafka les habría dado off the shelf. Es una decisión que solo sigue siendo correcta mientras el equipo que posee la plataforma siga siendo excelente.
En Archyl, este ADR está linkado al sistema Core Ledger & Event Backbone y a cada container que publica en él. Quien pregunte "¿por qué no hay Kafka en este diagrama?" — y todo senior hire lo pregunta — obtiene la respuesta en un clic.
Los tres segundos, en un timeline
Antes de hacer zoom en el Nivel 2, aquí está la transferencia de Léa como timeline. (Las cifras de latencia son órdenes de magnitud ilustrativos, no números publicados por Revolut.)
| t | Qué pasa | Dónde |
|---|---|---|
| 0 ms | Léa pulsa Enviar | App móvil |
| ~10 ms | Sesión validada, request autenticada y parseada | API edge |
| ~30 ms | Comprobación de saldo y reserva de fondos, transaccionalmente | Orquestador de transferencias + Ledger (PostgreSQL) |
| ~50 ms | EUR→GBP cotizado al tipo interbancario | Motor FX |
| ~100 ms | Screening de sanciones + scoring de fraude/scam — el budget de menos de 50 ms | Pipeline FinCrime |
| ~150 ms | TransferInitiated añadido al event store; Risk, PnL, notificaciones y analytics lo consumen |
Event backbone |
| ~200 ms | Pago enviado a Faster Payments | Connector del rail FPS |
| ~2–3 s | El banco receptor confirma; el ledger finaliza; se dispara la push notification | Rails + Ledger + Notificaciones |
Ocho hops, tres de ellos side effects irreversibles (reservar fondos, enviar al rail, finalizar el ledger). Retén esa estructura — es exactamente lo que el nivel Container necesita hacer visible.
Nivel 2 — Container: zoom en el camino de la transferencia
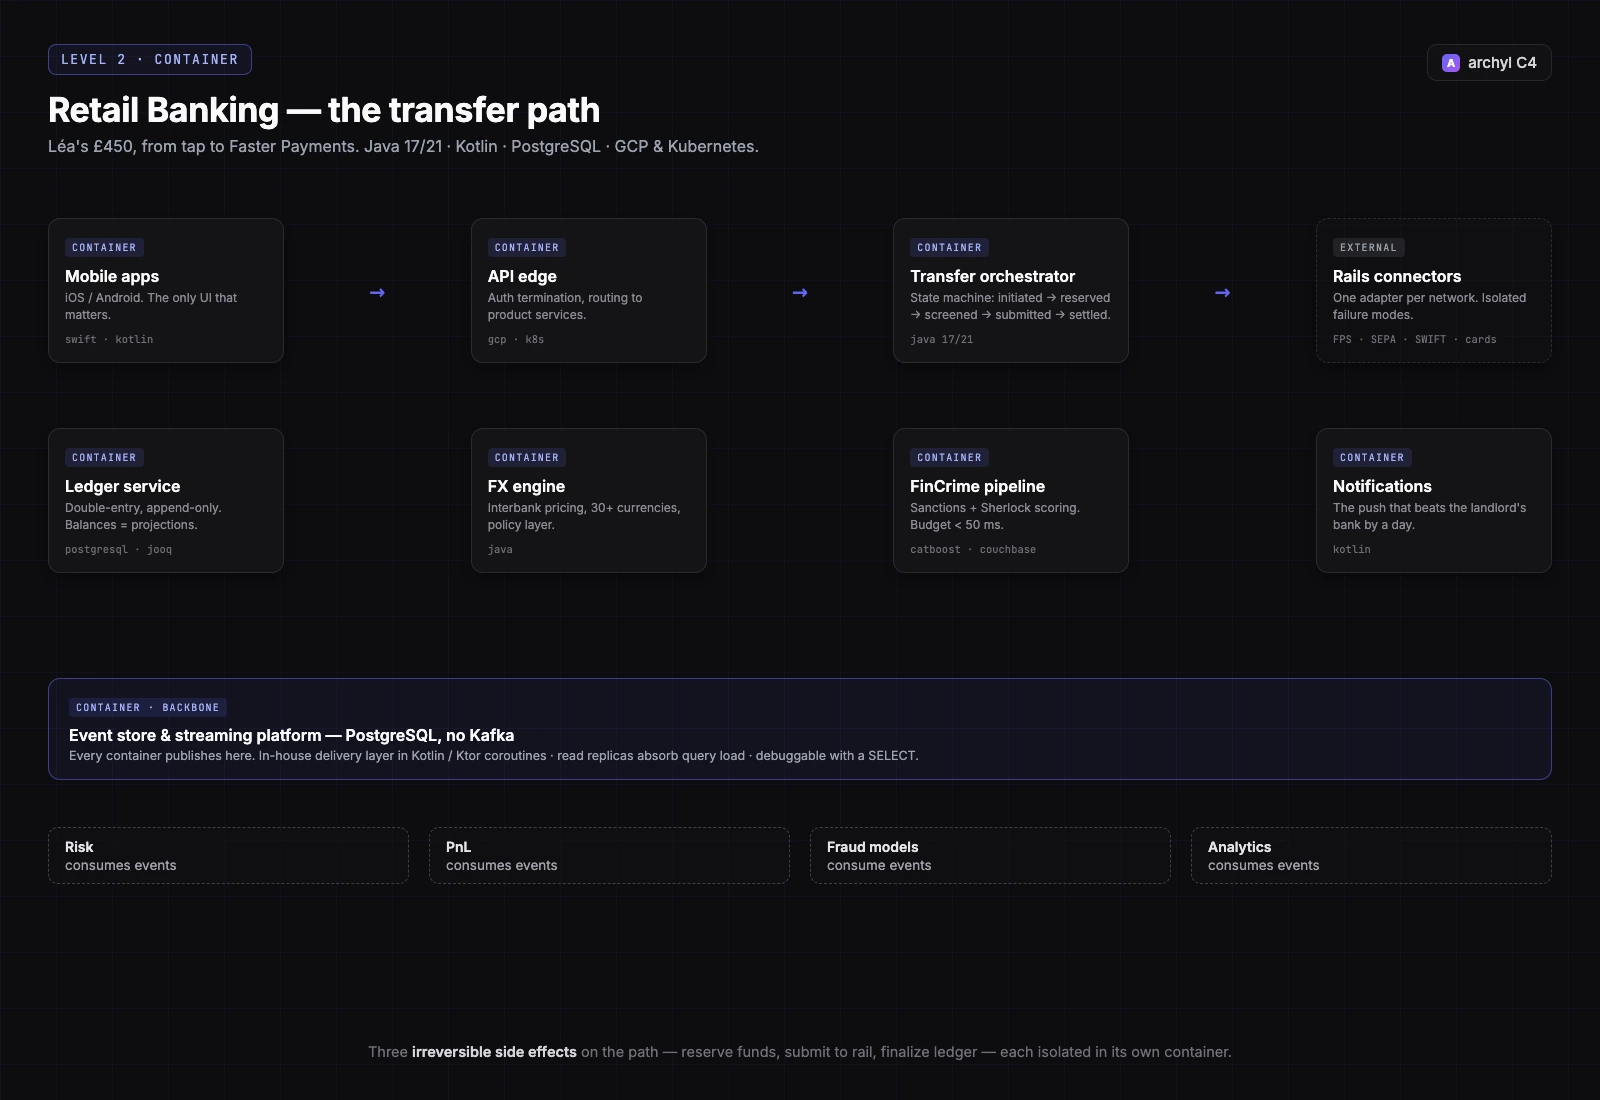
Abre la caja de Retail Banking y sigue las £450. Las fuentes públicas — posts de engineering, charlas, y una década de job specs — nos permiten nombrar los containers del camino:
- Apps móviles — iOS y Android, la única interfaz de usuario que importa; no hay una superficie de banca web significativa
- API edge — la puerta de entrada en GCP, terminando el auth y enrutando hacia los servicios producto
- Orquestador de transferencias — un servicio Java que posee la state machine de la transferencia:
initiated→reserved→screened→submitted→settled(o el camino de compensación en cada paso) - Servicio de Ledger — double-entry, append-only, sobre PostgreSQL. Los saldos son proyecciones del historial de eventos, no filas mutables
- Motor FX — pricing en tiempo real en 30+ divisas, tipo interbancario más política (markups de fin de semana, allowances según plan)
- Pipeline FinCrime — screening de sanciones más scoring ML; Sherlock para fraude con tarjeta, modelos dedicados de detección de scams para push payments (hacemos zoom en el Nivel 3)
- Connectors de rails — un adapter por red: Faster Payments, SEPA / SEPA Instant, SWIFT, y el procesador de tarjetas. Cada uno habla el protocolo de su red y aísla sus failure modes
- Event store & streaming platform — el backbone respaldado por Postgres del ADR-001, con la capa de delivery en Kotlin/Ktor
- Servicio de notificaciones — el push message que llega un día entero antes que la app del banco del casero
El stack tecnológico a este nivel, directo de los propios job postings de Revolut: Java 17/21 como lenguaje backend dominante, Kotlin para la streaming platform, PostgreSQL en todo lo que importa, Redis para caching, jOOQ para SQL tipado, Flyway para migraciones, Spock para testing, todo sobre GCP y Kubernetes, observado a través de Grafana, Prometheus y New Relic.
Fíjate en lo que el diagrama hace obvio: los connectors de rails son los únicos containers cuyo fallo Revolut no puede resolver con ingeniería — que Faster Payments esté caído no es un incidente de Revolut, pero sí es un ticket de soporte de Revolut. Modelar las dependencias externas como containers first-class con relaciones explícitas es cómo haces ese riesgo visible antes de que el incident review lo haga visible por ti.
ADR-002 · Traer el procesamiento de tarjetas in-house
Estado · Accepted (~2019, completamente desplegado desde entonces)
Contexto · Como casi toda fintech de su generación, Revolut lanzó con un procesador de tarjetas de terceros. El procesador estaba en el critical path de cada transacción con tarjeta: sus caídas eran las caídas de Revolut (y salían en los titulares), sus fees por transacción escalaban con el crecimiento de Revolut, y su roadmap frenaba las features de tarjeta de Revolut.
Decisión · Construir un payment processor in-house y migrar el tráfico de tarjetas a él. Poseer la conexión con las redes de tarjetas directamente.
Consecuencias · Revolut reporta procesar millones de pagos semanales en sistemas in-house con un uptime casi perfecto. La unit economics mejoró exactamente en el momento en que el volumen explotó, y las features de tarjeta se shippean según el calendario de Revolut, no el de un vendor. El precio: Revolut ahora opera infraestructura en scope PCI que la mayoría de empresas externalizan con razón, y carga con el burden regulatorio y de auditoría que la acompaña. Este ADR solo tiene sentido a partir de cierto volumen de transacciones — que es precisamente para lo que sirve la sección de contexto de un ADR. Copia la decisión sin el contexto y es una catástrofe.
Nivel 3 — Component: dentro de Sherlock, el juez de los 50 milisegundos
De todo el stack de Revolut, el motor de fraude es lo más públicamente documentado — el equipo publicó cómo lo construyeron en nueve meses, y el case study del vendor completa la capa de datos. Eso lo convierte en nuestro mejor candidato para un zoom a nivel Component, exactamente como la capa de idempotencia de Stripe en el post anterior.
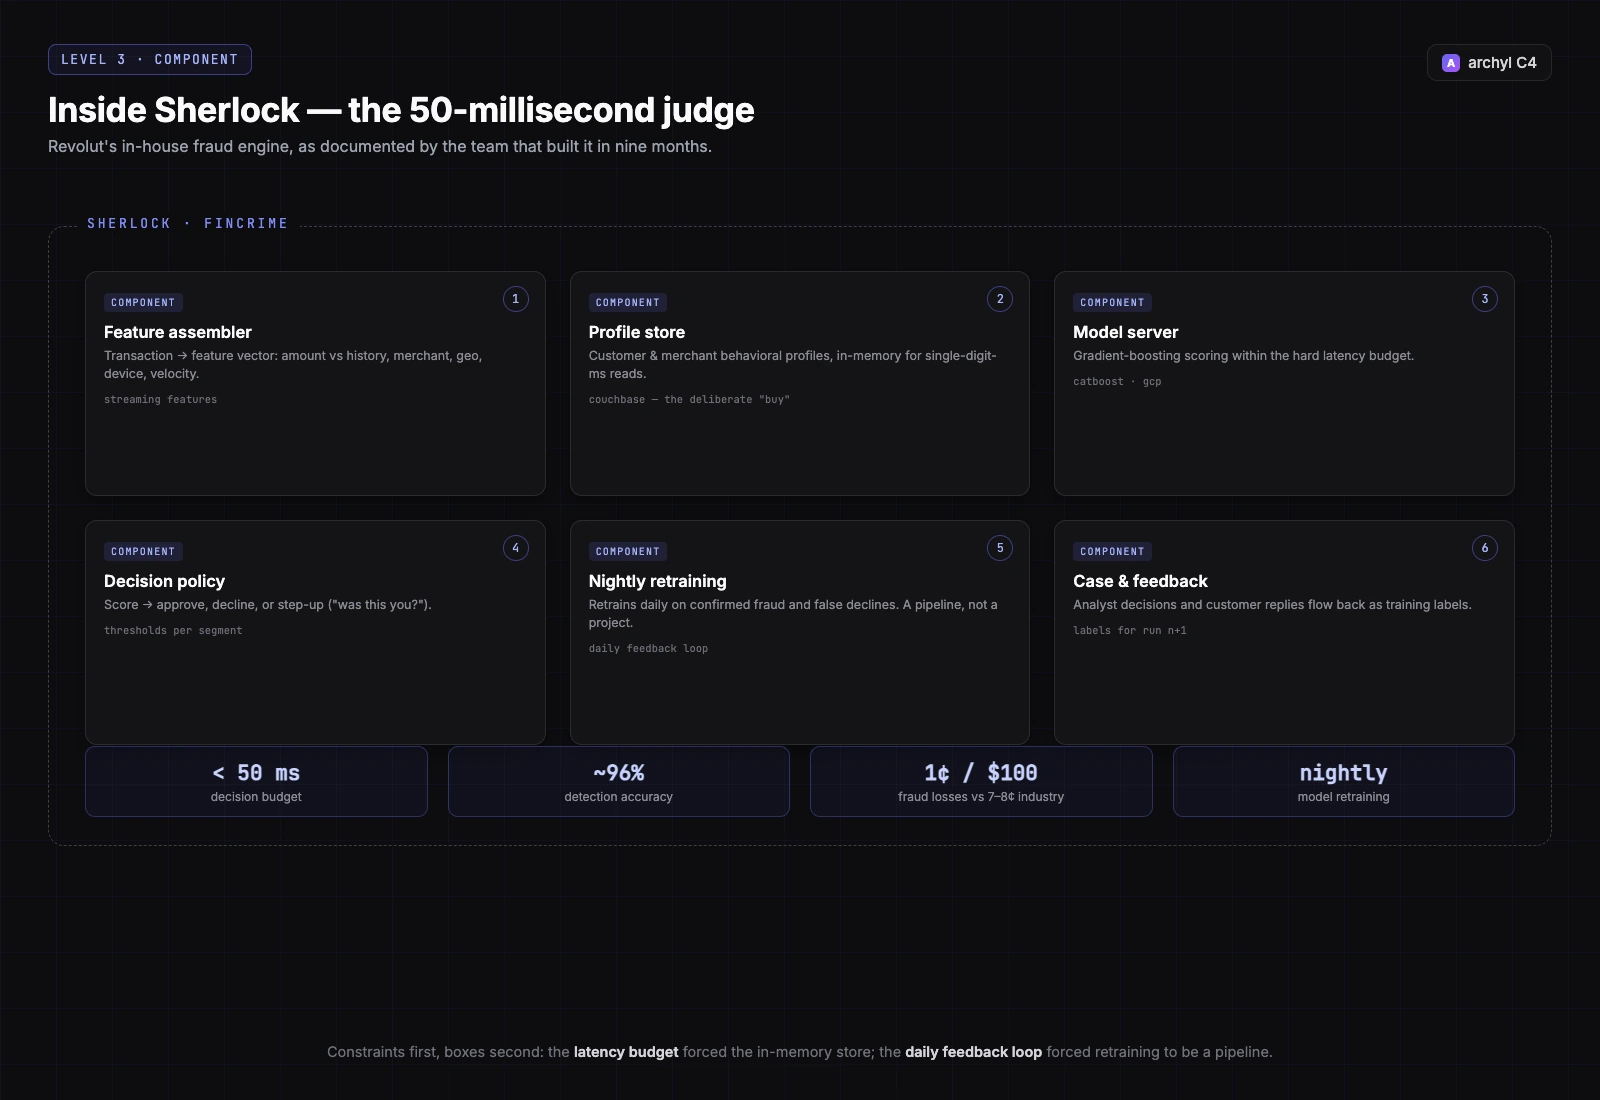
Cuando una transacción con tarjeta (o, a través de los modelos de scam adyacentes, un push payment como el de Léa) necesita un veredicto, fluye por estos componentes:
- Feature assembler — convierte la transacción cruda en un feature vector: importe vs. historial, categoría del merchant, geografía, señales del dispositivo, velocity counters
- Profile store — perfiles de comportamiento de clientes y merchants almacenados en Couchbase, una capa NoSQL in-memory, para que los lookups se queden en milisegundos de un solo dígito
- Model server — un modelo de gradient boosting CatBoost puntúa la transacción; la decisión completa tiene un budget de menos de 50 milisegundos
- Decision policy — los thresholds convierten un score en una acción: aprobar, rechazar, o step-up (push notification preguntando a Léa "¿fuiste tú?")
- Pipeline de retraining nocturno — cada noche, los modelos se reentrenan con el fraude confirmado y los false declines del día, cerrando el feedback loop a diario en vez de trimestralmente
- Case & feedback service — las decisiones de los analistas y las respuestas de los clientes vuelven como labels para el siguiente training run
Los resultados reportados: aproximadamente 96% de precisión de detección y pérdidas por fraude de alrededor de un centavo por cada $100 procesados, frente a una media de la industria de siete a ocho centavos — una brecha que vale del orden de $3M solo en el primer año.
La lección arquitectural no es "usa CatBoost". Es la forma: un budget de latencia duro forzó un profile store in-memory dedicado; un feedback loop diario forzó que el retraining fuera un pipeline, no un proyecto. Primero las constraints, después las cajas.
ADR-003 · Comprar el profile store, construir todo lo demás
Estado · Accepted (~2018, todavía activo)
Contexto · La cultura de Revolut es notoriamente build-first: procesador in-house (ADR-002), event streaming in-house (ADR-001), core bancario in-house. Sherlock necesitaba lecturas de menos de 10 ms sobre millones de perfiles de comportamiento, con writes llegando en streaming continuo — un problema resuelto en el mercado de bases de datos, y uno donde el "roll your own" añade riesgo de latencia al único componente con el budget más ajustado de la empresa.
Decisión · Comprar: usar Couchbase como el profile store in-memory dentro de Sherlock, y gastar la capacidad de construcción del equipo en las partes que diferencian — features, modelos, decision policy, y el retraining loop.
Consecuencias · El equipo de fraude shippea modelos, no storage engines. Y la arquitectura lleva una lección útil en los huesos: hasta la cultura de ingeniería más build-happy de la fintech europea compra cuando el componente es indiferenciado y el failure mode no perdona. Un ADR que dice "compramos esto, aquí está el porqué, aquí está lo que nos haría reconsiderarlo" vale más que diez páginas de wiki de evaluación de vendors.
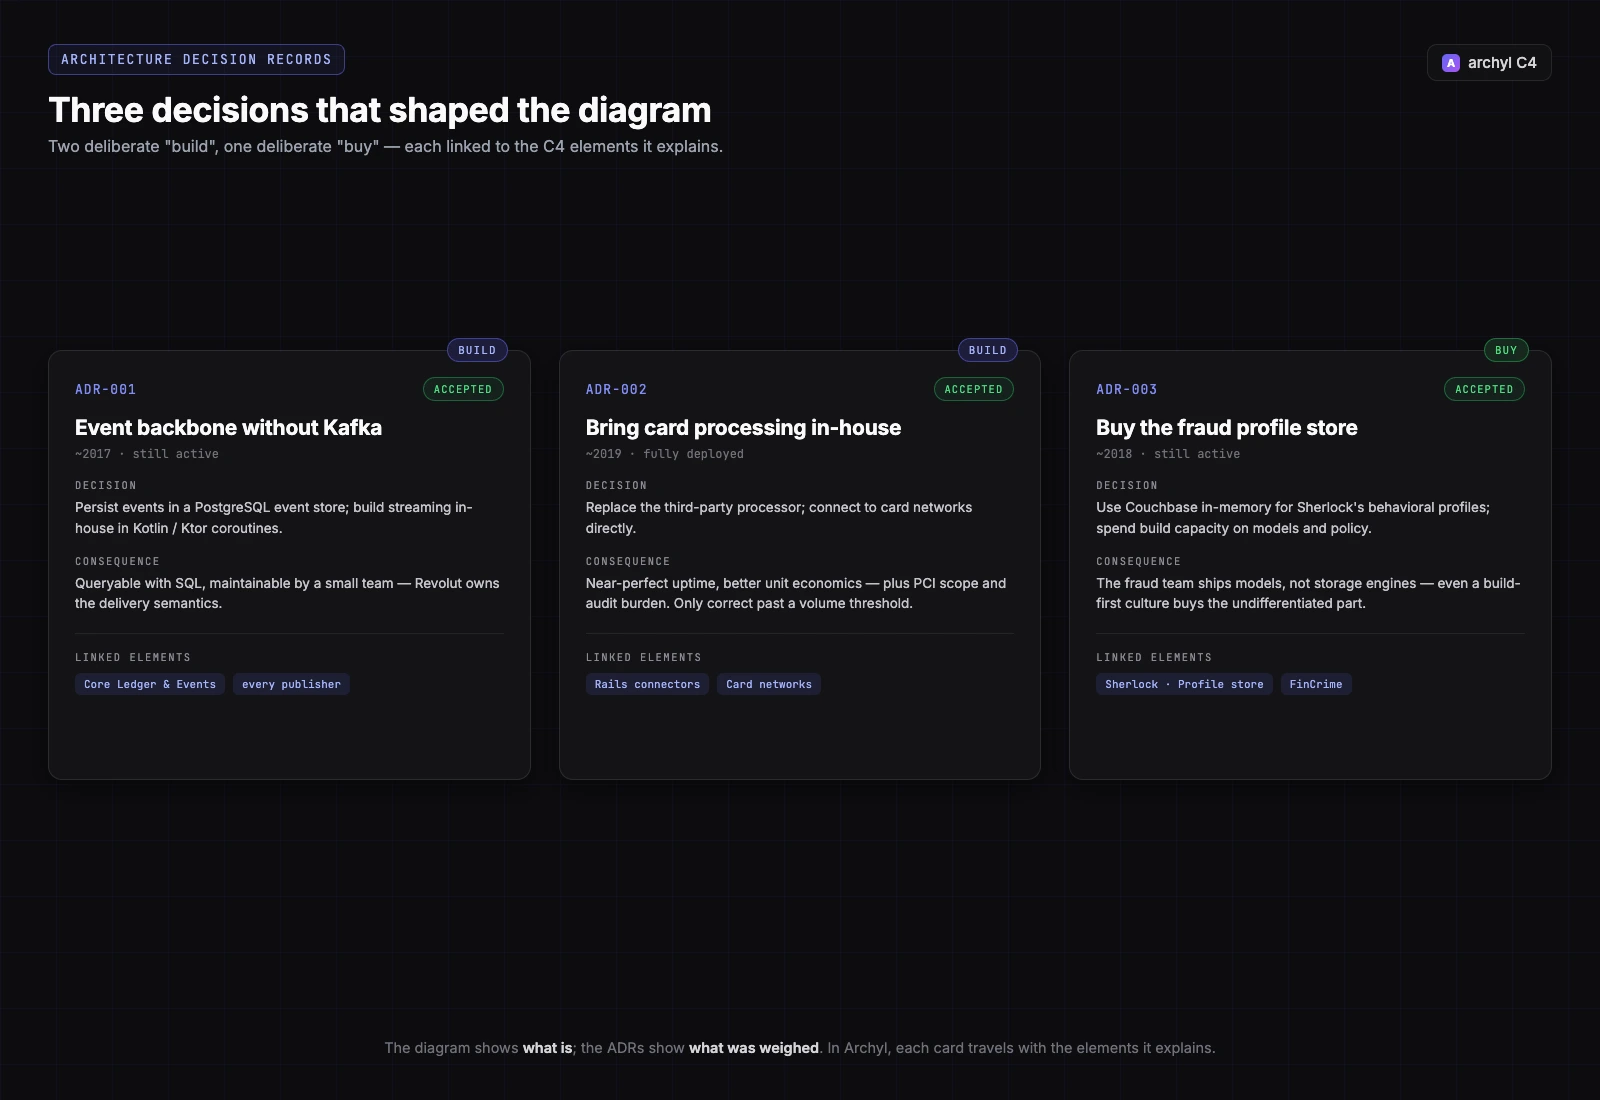
Tres decisiones, tres cards en Archyl, cada una linkada a los elementos C4 a los que da forma — el event backbone a cada container que publica, el procesamiento in-house a los connectors de rails, la decisión buy-vs-build al profile store de Sherlock. Dos decisiones "build" y un "buy" deliberado: el diagrama muestra lo que es; los ADRs muestran lo que se sopesó.
Ownership: cien empresas dentro de una empresa
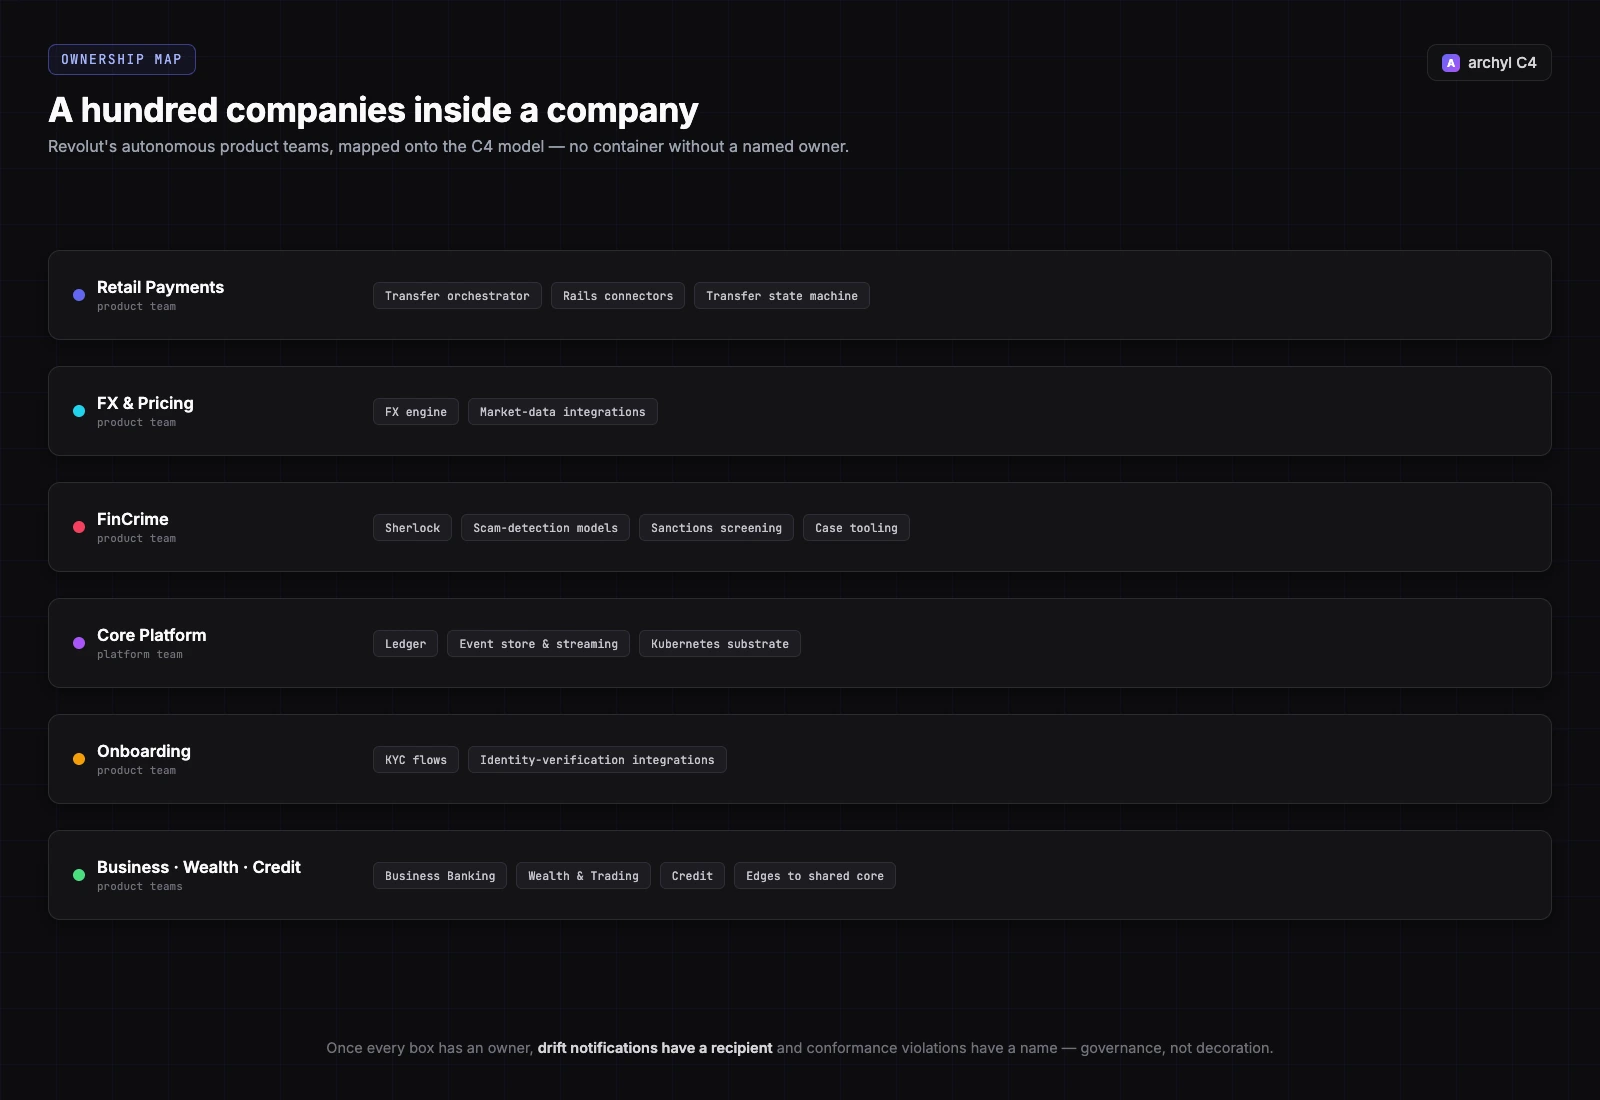
Revolut está famosamente organizada como equipos producto autónomos — el leadership habla de la empresa como "cien startups", cada una con un owner accountable end-to-end de las métricas, el roadmap y los servicios de un producto. Eso mapea directamente sobre el modelo C4:
- Retail Payments posee el orquestador de transferencias, los connectors de rails, y la state machine de la transferencia
- FX & Pricing posee el motor FX y sus integraciones de market data
- FinCrime posee Sherlock, los modelos de detección de scams, el screening de sanciones, y el tooling de casos
- Core Platform posee el ledger, el event store y la streaming platform, y el sustrato Kubernetes
- Onboarding posee los flujos KYC y las integraciones de verificación de identidad
- Business, Wealth, Credit poseen cada uno sus sistemas producto y sus edges hacia el core compartido
Una vez que cada container tiene un owner, el modelo deja de ser documentación y empieza a ser gobernanza. ¿Un nuevo servicio aparece en el codebase y no está en el diagrama? Un equipo específico recibe la notificación de drift. ¿Un container intenta leer el ledger directamente en vez de consumir eventos? Eso es una violación de regla de conformidad con un nombre adjunto — y en una empresa operando bajo supervisión de la PRA desde marzo de 2026, "quién posee esta caja" es una pregunta que los reguladores también hacen.
En Archyl, el Ownership Map más la detección de drift más el resumen semanal de equipo convierten el diseño organizacional de Revolut en una propiedad enforceable de la arquitectura: el resumen del lunes de Retail Payments cubre el orquestador y los rails; el de FinCrime cubre Sherlock y el pipeline de screening. Misma superficie, scoped al perímetro de cada equipo.
Roba esto, sáltate esto
El sentido de modelar la arquitectura de otro es tomar mejores decisiones en la tuya. Nuestra lectura:
Roba:
- El event log como source of truth, sobre PostgreSQL. Casi con certeza no necesitas Kafka el día uno. Una tabla append-only con consumidores disciplinados te da replayability, auditoría y debuggability en SQL — y escala mucho más lejos de lo que el consenso de las conference talks admite.
- Un budget de latencia duro para la decisión más arriesgada. "El scoring de fraude responde en 50 ms o aprueba con un flag" es una constraint arquitectural que te diseña la mitad del sistema.
- Un owner accountable por caja. El modelo de las "cien startups" de Revolut es extremo, pero su traducción a C4 — ningún container sin un equipo con nombre — no cuesta nada y lo cambia todo en incident response y drift.
Sáltate (a menos que tengas el contexto de Revolut):
- Construir tu propia plataforma de event streaming. Ese ADR es downstream de tener un equipo de plataforma world-class y cientos de servicios. Con diez servicios, el messaging managed o las colas planas en Postgres ganan.
- Procesamiento de tarjetas in-house. La decisión dio frutos a millones de transacciones por semana. Por debajo de eso, es scope PCI y burden de auditoría sin upside — la sección de contexto del ADR-002 está haciendo el trabajo pesado.
No necesitas 70 millones de clientes
La disciplina también escala hacia abajo. Separar Context de Container de Component; escribir el ADR que explica una decisión path-dependent (nos saltamos Kafka, trajimos el procesamiento in-house, compramos el profile store); adjuntar un owner a cada caja — eso es lo que mantiene legible un stack de treinta servicios mientras se convierte en un stack de trescientos.
C4 + ADRs + Ownership + Drift + Conformidad es lo que Archyl te da out of the box. Revolut es simplemente cómo se ve esa disciplina compuesta durante una década a velocidad fintech — de cero a un banco de 75 mil millones de dólares sobre Java, Postgres, y un ownership inusualmente claro.
Abre tu propia arquitectura. Dibuja los sistemas (ocho, o tres). Sigue el equivalente en tu producto de las £450 de Léa a través de los containers. Escribe los tres ADRs que un senior hire preguntaría en la primera semana. Mapea un equipo a cada caja.
Estarás por delante de donde la mayoría de organizaciones de ingeniería llegan en un año.
FAQ
¿Revolut usa Kafka? No — por decisión deliberada. Revolut persiste los eventos en un event store respaldado por PostgreSQL y construyó su plataforma de streaming y messaging in-house en Kotlin (JetBrains Ktor, coroutines), encontrándola más fácil de mantener, personalizar y consultar que un despliegue de Kafka.
¿Qué base de datos usa Revolut? PostgreSQL es el backbone — incluyendo el event store que actúa como source of truth — complementado por Redis para caching y Couchbase como profile store in-memory dentro del motor de fraude Sherlock.
¿En qué lenguaje de programación está escrito Revolut? El backend es predominantemente Java (17/21), con Kotlin para la plataforma de event streaming y jOOQ para acceso SQL tipado. Corre sobre Google Cloud y Kubernetes.
¿Es Revolut un banco de verdad? Sí. Revolut opera bajo una licencia bancaria de la UE (vía el Banco de Lituania) y recibió su licencia bancaria británica completa de la PRA en marzo de 2026, tras la licencia restringida concedida en julio de 2024.
¿Cómo detecta Revolut el fraude? Con Sherlock, un sistema de machine learning in-house: modelos CatBoost puntúan cada transacción con tarjeta en menos de 50 milisegundos contra perfiles de comportamiento almacenados en Couchbase, y se reentrenan cada noche. Revolut reporta pérdidas por fraude de alrededor de 1¢ por cada $100 procesados, frente a una media de la industria de 7–8¢.
¿Quieres modelar tu propia arquitectura en C4? Empieza con Archyl. Este es el cuarto post de la serie Anatomía — lee Stripe: Anatomía de un Charge, Netflix: Anatomía de un Play y Uber: Anatomía de un Ride, o profundiza en por qué ADRs y C4 funcionan mejor juntos.