Hinweis. Dieser Artikel basiert ausschließlich auf öffentlichen Kommunikationen von Revolut — ihrem Engineering-Blog, Konferenz-Talks, Stellenausschreibungen, Jahresberichten und externen Case Studies. Es ist kein offizielles Architektur-Dokument von Revolut. Wir modellieren das, was wir öffentlich wissen, um zu zeigen, wie ein komplexer Stack mit dem C4-Modell lesbar gemacht werden kann. Wenn Details inferiert sind statt von Revolut bestätigt, sagen wir das.
Anatomie eines Transfers: Revolut in C4 mit Archyl modellieren
Es ist 19:47 an einem Freitag in Paris. Léa öffnet Revolut, tippt £450 ein, wählt ihren Londoner Vermieter aus den Kontakten und tippt auf Senden. Ihre Euro werden zum Interbanken-Kurs in Pfund konvertiert, auf Fraud und Sanktionen gescreent, in einen unveränderlichen Ledger geschrieben und auf die britische Faster-Payments-Schiene geschoben. Die Bank des Vermieters schreibt das Geld gut, bevor Léa ihr Handy wieder in die Tasche gesteckt hat.
Diese Drei-Sekunden-Reise durchquert eine Mobile App, einen API-Edge, einen Transfer-Orchestrator, eine FX-Engine, eine Financial-Crime-Pipeline mit einem Budget von unter 50 Millisekunden, einen Event Store und ein externes nationales Payment-Netzwerk — alles betrieben von einem Unternehmen, das vor elf Jahren noch nicht existierte.
Revolut in Zahlen
| Kunden | 70+ Millionen (Mai 2026), nach 50M im Nov 2024 |
| Umsatz 2025 | 6 Milliarden Dollar (+46% YoY), 2,3 Mrd. $ Gewinn vor Steuern |
| Transaktionsvolumen | £1,3 Billionen in 2025 (+65% YoY) |
| Bewertung | 75 Milliarden Dollar |
| Präsenz | 40+ Länder — 13M Kunden in UK, 6M in Spanien, 5M in Frankreich |
| Fraud-Verluste | ~1¢ pro verarbeitete $100, gegenüber einem Branchendurchschnitt von 7–8¢ |
| Core-Stack | Java 17/21 & Kotlin, PostgreSQL, GCP, Kubernetes — und berühmt-berüchtigt: kein Kafka |
Wie versteht man einen Stack, der £1,3 Billionen pro Jahr bewegt? So wie wir in dieser Serie an Stripe, Netflix und Uber herangegangen sind: gar nicht — nicht auf einmal. Man folgt einer User-Aktion über die vier C4-Ebenen, schreibt die ADRs, die die Entscheidungen erklären, denen man unterwegs begegnet, und endet mit einer Karte, wer jede Box besitzt.
Léas £450 sind unser roter Faden.
Ebene 1 — System Context: eine Bank, ein Broker, eine Börse und ein App Store
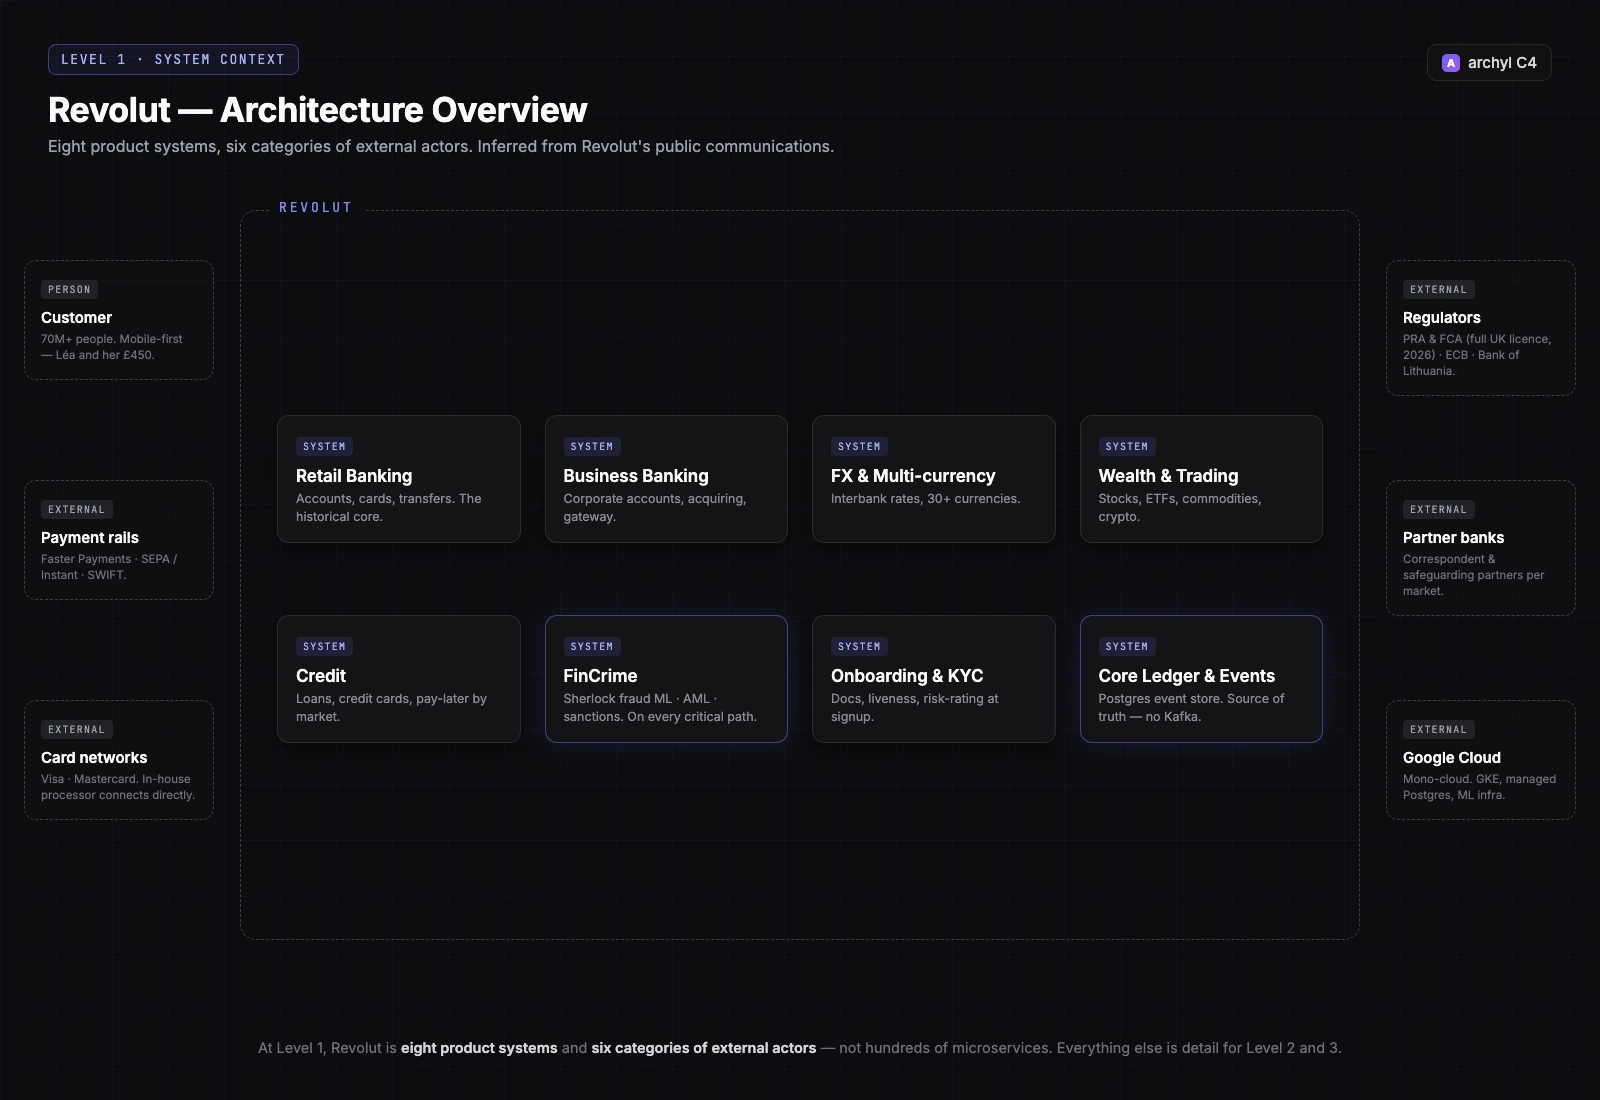
Auf der System-Context-Ebene ist Revolut nicht "eine Banking-App". Öffentliche Kommunikationen beschreiben mindestens acht Produkt-Systeme, die ein Fundament teilen:
- Retail Banking — Multi-Currency-Konten, Karten, Transfers: der historische Kern
- Business Banking — Konten, Firmenkarten und ein Merchant-Acquiring-Arm mit eigenem Payment-Gateway
- FX & Multi-Currency — die Exchange-Engine, die Revolut berühmt gemacht hat, Interbanken-Kurse über 30+ Währungen
- Wealth & Trading — Aktien, ETFs, Rohstoffe, Krypto
- Credit — Privatkredite, Kreditkarten, Pay-Later-Produkte je nach Markt
- FinCrime — Fraud-Scoring (Sherlock), AML, Sanktions-Screening, Scam-Erkennung
- Onboarding & KYC — Dokumenten-Verifizierung, Liveness-Checks, Risk-Rating bei der Registrierung
- Core Ledger & Event Backbone — die Source of Truth, in die jedes Produkt schreibt
Drumherum: Card-Networks (Visa, Mastercard), Payment-Rails (UK Faster Payments, SEPA und SEPA Instant, SWIFT für den Long Tail), Partner- und Korrespondenzbanken, Regulatoren (die PRA und FCA in UK — Revolut erhielt seine volle britische Banklizenz im März 2026, nach der eingeschränkten Lizenz vom Juli 2024; die EZB und die Bank of Lithuania in der EU), Marktdaten- und Brokerage-Partner für Wealth, und Google Cloud als zugrundeliegende Infrastruktur.
Acht Systeme, sechs Kategorien externer Akteure. Alles andere ist Detail.
Beachte, was Ebene 1 dir bereits sagt, was kein Organigramm sagt: FinCrime ist ein System, kein Feature. Es sitzt auf dem kritischen Pfad jedes Produkts — Retail-Transfers, Kartenzahlungen, Krypto-Abhebungen, Business-Payouts. Wenn ein Unternehmen sein Context-Diagramm zeichnet und eine Box Pfeile von überall bekommt, ist diese Box entweder das Kronjuwel oder der Bottleneck. Bei Revolut ist sie beides — und sie haben sie entsprechend besetzt.
ADR-001 · Ein Event-getriebenes Backbone — ohne Kafka
Status · Accepted (~2017, 2026 immer noch aktiv)
Kontext · Revoluts Backend besteht aus Hunderten unabhängiger Microservices, die sich über den Austausch von Events koordinieren. Die Industrie-Standardantwort 2017 (und wohl auch heute) war Apache Kafka. Aber Kafka bringt eine schwere operative Oberfläche mit: Broker, Partitionen, Rebalancing, Retention-Tuning — ein Vollzeit-Plattform-Thema. Revoluts Engineering-Kultur bevorzugt kleine Teams, die einfache, abfragbare Primitive besitzen.
Entscheidung · Kafka nicht einführen. Events in einem einzigen Event Store auf PostgreSQL-Basis persistieren und die Streaming- und Messaging-Layer selbst bauen — geschrieben in Kotlin auf JetBrains Ktor, mit Coroutines für hochparallele Event-Zustellung. Consumer wie Risk, PnL und Fraud-Detection lesen aus dem Store, wobei Read Replicas die Query-Last abfangen.
Konsequenzen · Das Event-Backbone ist von einem kleinen Team wartbar und — entscheidend — mit SQL abfragbar. Eine Zahlung zu debuggen ist kein Spelunking durch partitionierte Logs; es ist ein SELECT. Der Trade-off ist real: Revolut besitzt die Availability-, Ordering- und Delivery-Semantik, die Kafka ihnen out of the box gegeben hätte. Das ist eine Entscheidung, die nur so lange richtig bleibt, wie das Team, das die Plattform besitzt, exzellent bleibt.
In Archyl ist dieses ADR mit dem System Core Ledger & Event Backbone verknüpft und mit jedem Container, der dorthin publiziert. Wer fragt "warum ist in diesem Diagramm kein Kafka?" — und jeder Senior Hire fragt das — bekommt die Antwort mit einem Klick.
Die drei Sekunden, als Timeline
Bevor wir in Ebene 2 zoomen, hier Léas Transfer als Timeline. (Die Latenz-Angaben sind illustrative Größenordnungen, keine von Revolut veröffentlichten Zahlen.)
| t | Was passiert | Wo |
|---|---|---|
| 0 ms | Léa tippt auf Senden | Mobile App |
| ~10 ms | Session validiert, Request authentifiziert und geparst | API-Edge |
| ~30 ms | Balance-Check und Funds-Reservierung, transaktional | Transfer-Orchestrator + Ledger (PostgreSQL) |
| ~50 ms | EUR→GBP zum Interbanken-Kurs quotiert | FX-Engine |
| ~100 ms | Sanktions-Screening + Fraud/Scam-Scoring — das Sub-50-ms-Budget | FinCrime-Pipeline |
| ~150 ms | TransferInitiated an den Event Store angehängt; Risk, PnL, Notifications und Analytics konsumieren es |
Event-Backbone |
| ~200 ms | Zahlung an Faster Payments übermittelt | FPS-Rail-Connector |
| ~2–3 s | Empfängerbank bestätigt; Ledger finalisiert; Push-Notification feuert | Rails + Ledger + Notifications |
Acht Hops, drei davon irreversible Side Effects (Funds reservieren, an die Rail übermitteln, Ledger finalisieren). Behalte diese Struktur im Kopf — genau das muss die Container-Ebene sichtbar machen.
Ebene 2 — Container: Zoom in den Transfer-Pfad
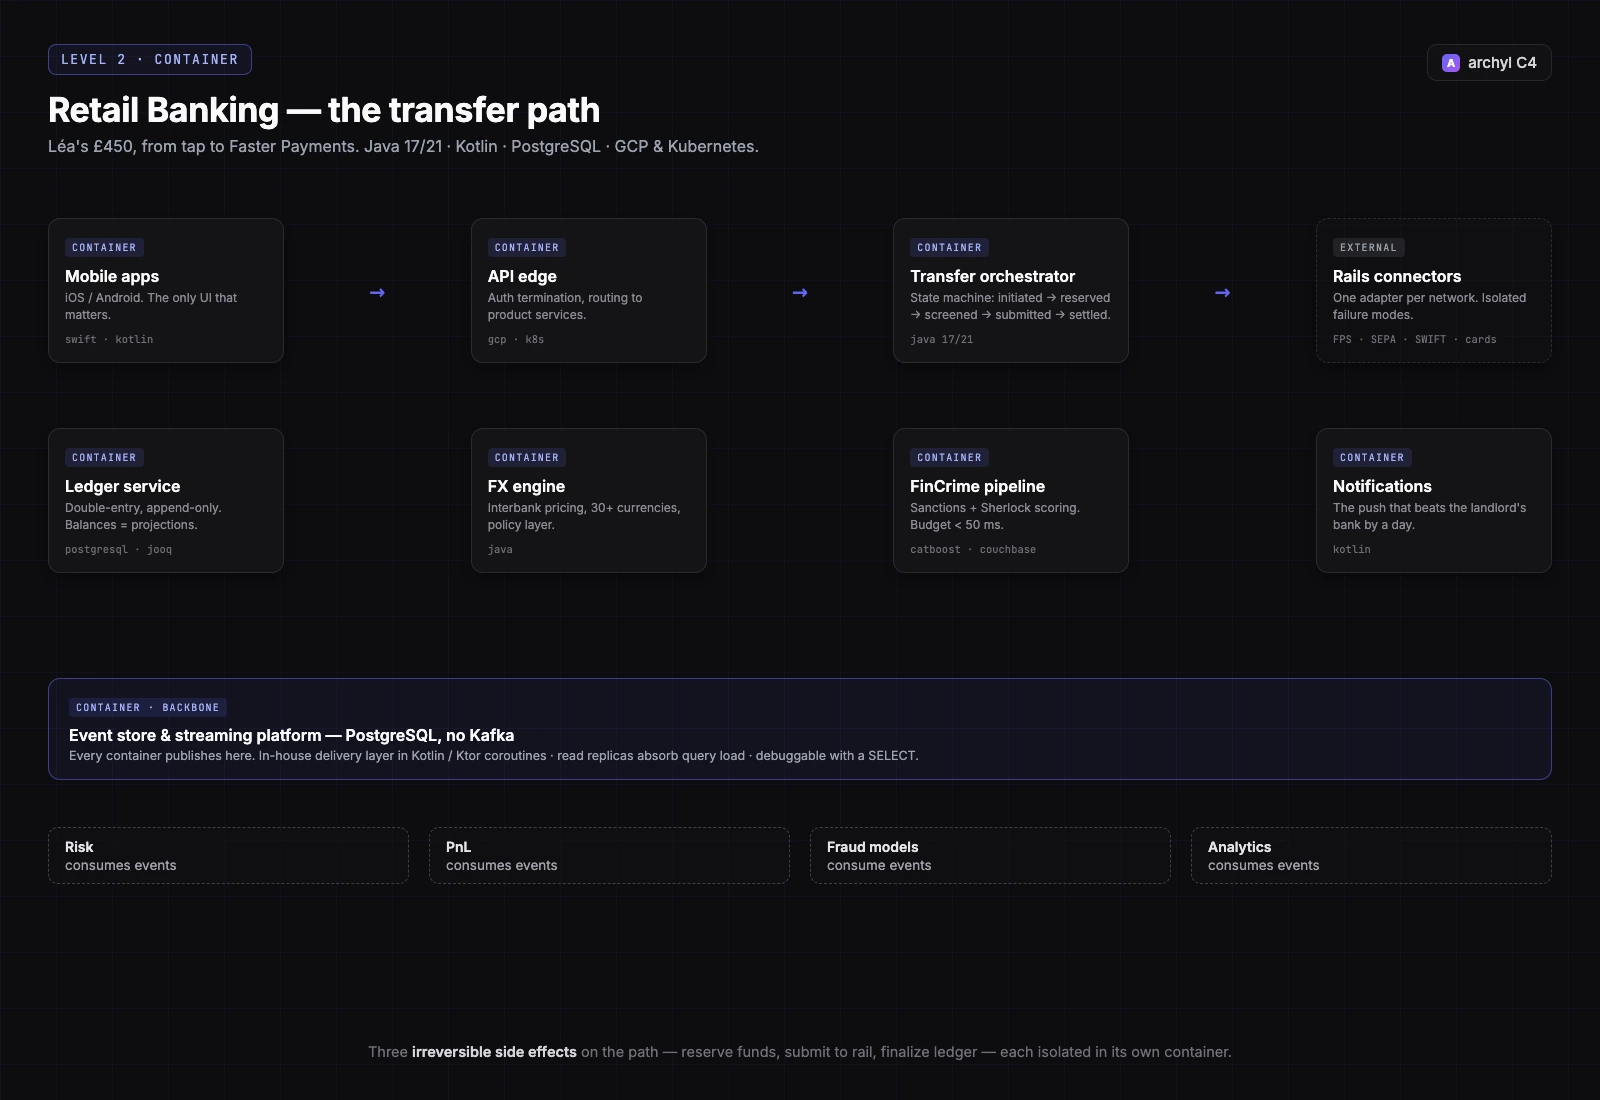
Öffne die Retail-Banking-Box und folge den £450. Öffentliche Quellen — Engineering-Posts, Talks und ein Jahrzehnt an Stellenausschreibungen — lassen uns die Container auf dem Pfad benennen:
- Mobile Apps — iOS und Android, das einzige User-Interface, das zählt; eine nennenswerte Web-Banking-Oberfläche gibt es nicht
- API-Edge — die Eingangstür auf GCP, terminiert Auth und routet zu den Produkt-Services
- Transfer-Orchestrator — ein Java-Service, der die Transfer-State-Machine besitzt:
initiated→reserved→screened→submitted→settled(oder den kompensierenden Pfad bei jedem Schritt) - Ledger-Service — doppelte Buchführung, append-only, auf PostgreSQL. Balances sind Projektionen der Event-Historie, keine mutierbaren Rows
- FX-Engine — Echtzeit-Pricing über 30+ Währungen, Interbanken-Kurs plus Policy (Wochenend-Aufschläge, planabhängige Freibeträge)
- FinCrime-Pipeline — Sanktions-Screening plus ML-Scoring; Sherlock für Kartenbetrug, dedizierte Scam-Detection-Modelle für Push Payments (wir zoomen in Ebene 3 hinein)
- Rails-Connectors — ein Adapter pro Netzwerk: Faster Payments, SEPA / SEPA Instant, SWIFT und der Card-Prozessor. Jeder spricht das Protokoll seines Netzwerks und isoliert dessen Failure Modes
- Event Store & Streaming-Plattform — das Postgres-basierte Backbone aus ADR-001, mit der Kotlin/Ktor-Delivery-Layer
- Notification-Service — die Push-Nachricht, die der Banking-App des Vermieters einen ganzen Tag voraus ist
Der Tech-Stack auf dieser Ebene, direkt aus Revoluts eigenen Stellenausschreibungen: Java 17/21 als dominante Backend-Sprache, Kotlin für die Streaming-Plattform, PostgreSQL überall, wo es zählt, Redis fürs Caching, jOOQ für typisiertes SQL, Flyway für Migrationen, Spock fürs Testing, alles auf GCP und Kubernetes, beobachtet über Grafana, Prometheus und New Relic.
Beachte, was das Diagramm offensichtlich macht: Die Rails-Connectors sind die einzigen Container, deren Ausfall Revolut nicht weg-engineeren kann — wenn Faster Payments down ist, ist das kein Revolut-Incident, aber ein Revolut-Support-Ticket. Externe Abhängigkeiten als First-Class-Container mit expliziten Relationships zu modellieren ist der Weg, dieses Risiko sichtbar zu machen, bevor das Incident Review es für dich sichtbar macht.
ADR-002 · Card Processing in-house holen
Status · Accepted (~2019, seitdem vollständig ausgerollt)
Kontext · Wie fast jedes Fintech seiner Generation startete Revolut mit einem Drittanbieter-Card-Prozessor. Der Prozessor saß auf dem kritischen Pfad jeder Kartentransaktion: Seine Ausfälle waren Revoluts Ausfälle (und machten Schlagzeilen), seine Pro-Transaktions-Gebühren skalierten mit Revoluts Wachstum, und seine Roadmap blockierte Revoluts Karten-Features.
Entscheidung · Einen eigenen Payment-Prozessor bauen und den Kartenverkehr dorthin migrieren. Die Verbindung zu den Card-Networks direkt selbst besitzen.
Konsequenzen · Revolut berichtet, wöchentlich Millionen von Zahlungen auf In-house-Systemen mit nahezu perfekter Uptime zu verarbeiten. Die Unit Economics verbesserten sich genau in dem Moment, als das Volumen explodierte, und Karten-Features shippen nach Revoluts Kalender, nicht dem eines Vendors. Der Preis: Revolut betreibt nun PCI-Scope-Infrastruktur, die die meisten Unternehmen zu Recht outsourcen, und trägt die regulatorische und Audit-Last, die damit einhergeht. Dieses ADR ergibt nur ab einem bestimmten Transaktionsvolumen Sinn — und genau dafür ist die Kontext-Sektion eines ADRs da. Kopiere die Entscheidung ohne den Kontext, und es ist eine Katastrophe.
Ebene 3 — Component: in Sherlock, dem 50-Millisekunden-Richter
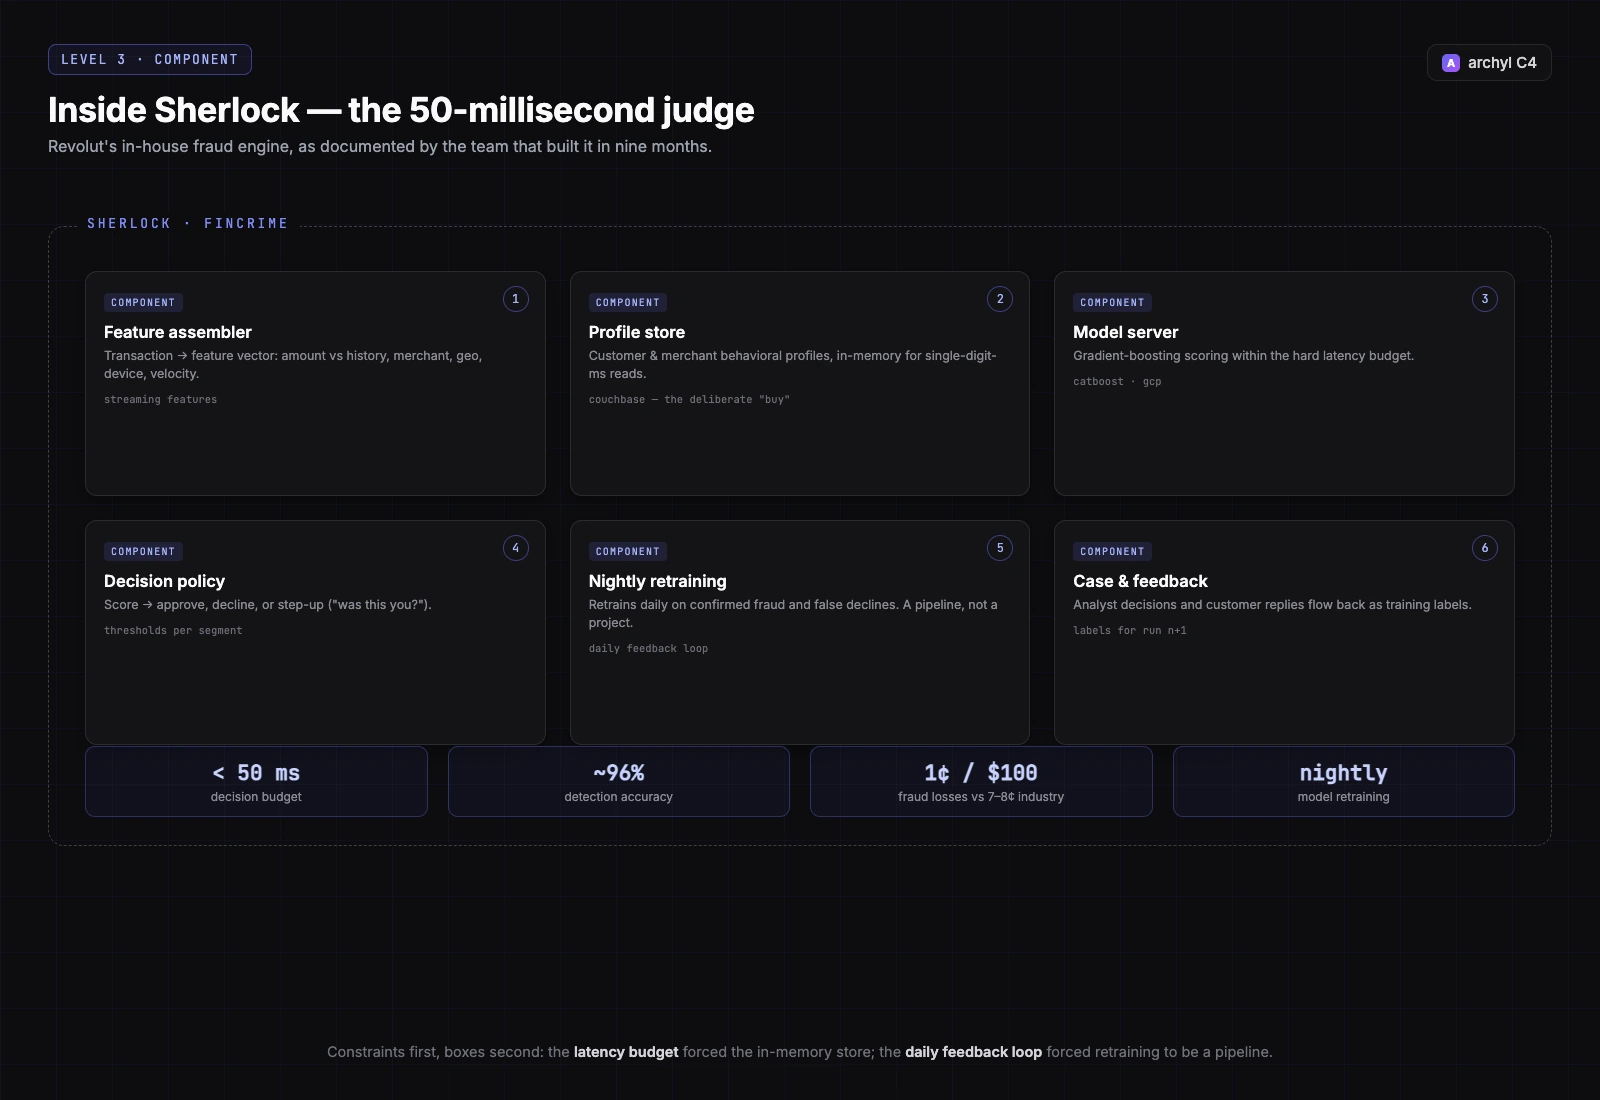
Von allem in Revoluts Stack ist die Fraud-Engine am öffentlichsten dokumentiert — das Team hat publiziert, wie sie sie in neun Monaten gebaut haben, und die Vendor-Case-Study füllt die Daten-Layer auf. Das macht sie zu unserem besten Kandidaten für einen Component-Level-Zoom, genau wie Stripes Idempotency layer im vorherigen Post.
Wenn eine Kartentransaktion (oder, über die benachbarten Scam-Modelle, ein Push Payment wie Léas) ein Urteil braucht, fließt sie durch diese Komponenten:
- Feature Assembler — verwandelt die rohe Transaktion in einen Feature-Vektor: Betrag vs. Historie, Merchant-Kategorie, Geografie, Device-Signale, Velocity-Counter
- Profile Store — Verhaltensprofile von Kunden und Merchants, gehalten in Couchbase, einer In-Memory-NoSQL-Layer, damit Lookups im einstelligen Millisekunden-Bereich bleiben
- Model Server — ein CatBoost-Gradient-Boosting-Modell scored die Transaktion; die gesamte Entscheidung hat ein Budget von unter 50 Millisekunden
- Decision Policy — Schwellenwerte verwandeln einen Score in eine Aktion: approve, decline oder Step-up (Push-Notification, die Léa fragt "warst du das?")
- Nightly-Retraining-Pipeline — jede Nacht retrainieren die Modelle auf dem bestätigten Fraud und den False Declines des Tages und schließen den Feedback-Loop täglich statt quartalsweise
- Case & Feedback Service — Analysten-Entscheidungen und Kunden-Antworten fließen als Labels für den nächsten Trainingslauf zurück
Die berichteten Ergebnisse: rund 96% Detection Accuracy und Fraud-Verluste von etwa einem Cent pro verarbeitete $100, gegenüber einem Branchendurchschnitt von sieben bis acht Cent — eine Lücke, die allein im ersten Jahr in der Größenordnung von 3M$ wert war.
Die architektonische Lektion ist nicht "nutze CatBoost". Es ist die Form: Ein hartes Latenz-Budget erzwang einen dedizierten In-Memory-Profile-Store; ein täglicher Feedback-Loop erzwang, dass Retraining eine Pipeline ist, kein Projekt. Erst die Constraints, dann die Boxen.
ADR-003 · Den Profile Store kaufen, alles andere bauen
Status · Accepted (~2018, immer noch aktiv)
Kontext · Revoluts Kultur ist auffällig build-first: In-house-Prozessor (ADR-002), In-house-Event-Streaming (ADR-001), In-house-Banking-Core. Sherlock brauchte Sub-10-ms-Reads auf Millionen von Verhaltensprofilen, mit kontinuierlich einströmenden Writes — ein gelöstes Problem im Datenbank-Markt, und eines, bei dem "selbst bauen" Latenz-Risiko genau in die eine Komponente mit dem engsten Budget des Unternehmens einführt.
Entscheidung · Kaufen: Couchbase als In-Memory-Profile-Store innerhalb von Sherlock nutzen und die Build-Kapazität des Teams auf die Teile verwenden, die differenzieren — Features, Modelle, Decision Policy und den Retraining-Loop.
Konsequenzen · Das Fraud-Team shippt Modelle, keine Storage-Engines. Und die Architektur trägt eine nützliche Lektion in sich: Selbst die build-freudigste Engineering-Kultur im europäischen Fintech kauft, wenn die Komponente undifferenziert ist und der Failure Mode unverzeihlich. Ein ADR, das sagt "wir haben das gekauft, hier ist warum, hier ist, was uns die Entscheidung überdenken ließe", ist zehn Wiki-Seiten Vendor-Evaluierung wert.
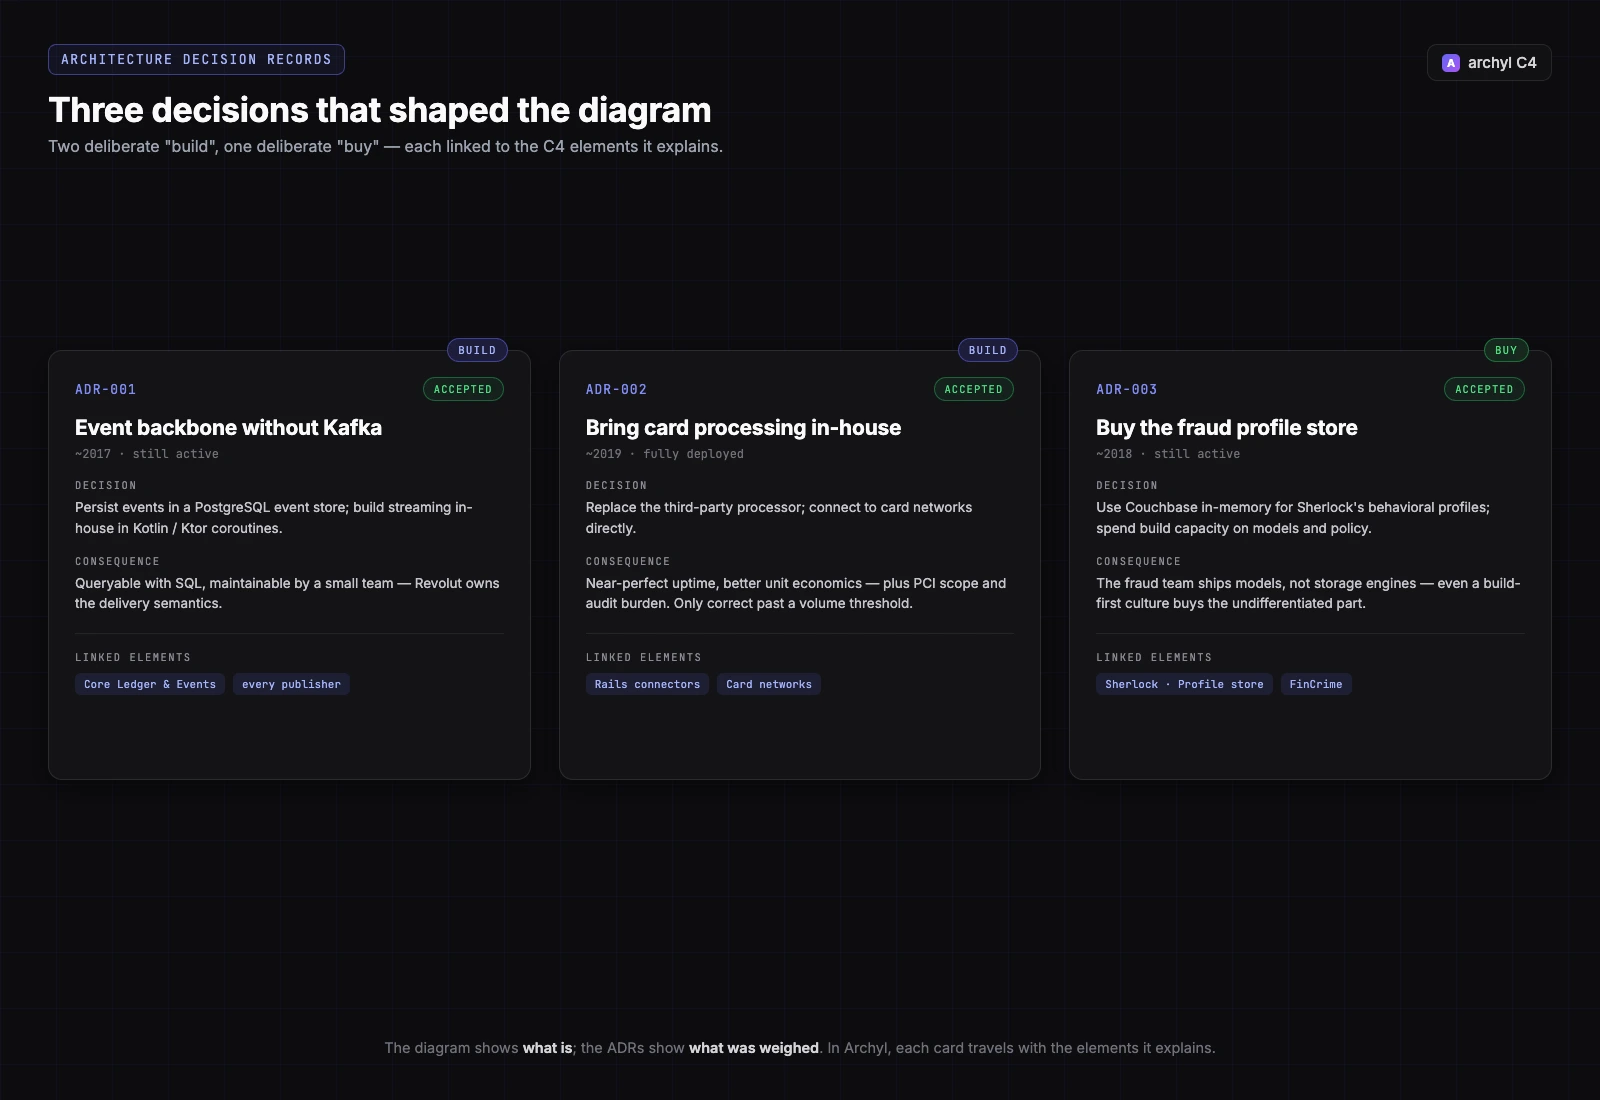
Drei Entscheidungen, drei Cards in Archyl, jede mit den C4-Elementen verknüpft, die sie formt — das Event-Backbone mit jedem publizierenden Container, In-house-Processing mit den Rails-Connectors, der Buy-vs-Build-Call mit Sherlocks Profile Store. Zwei "Build"-Entscheidungen und ein bewusstes "Buy": Das Diagramm zeigt, was ist; die ADRs zeigen, was abgewogen wurde.
Ownership: hundert Unternehmen in einem Unternehmen
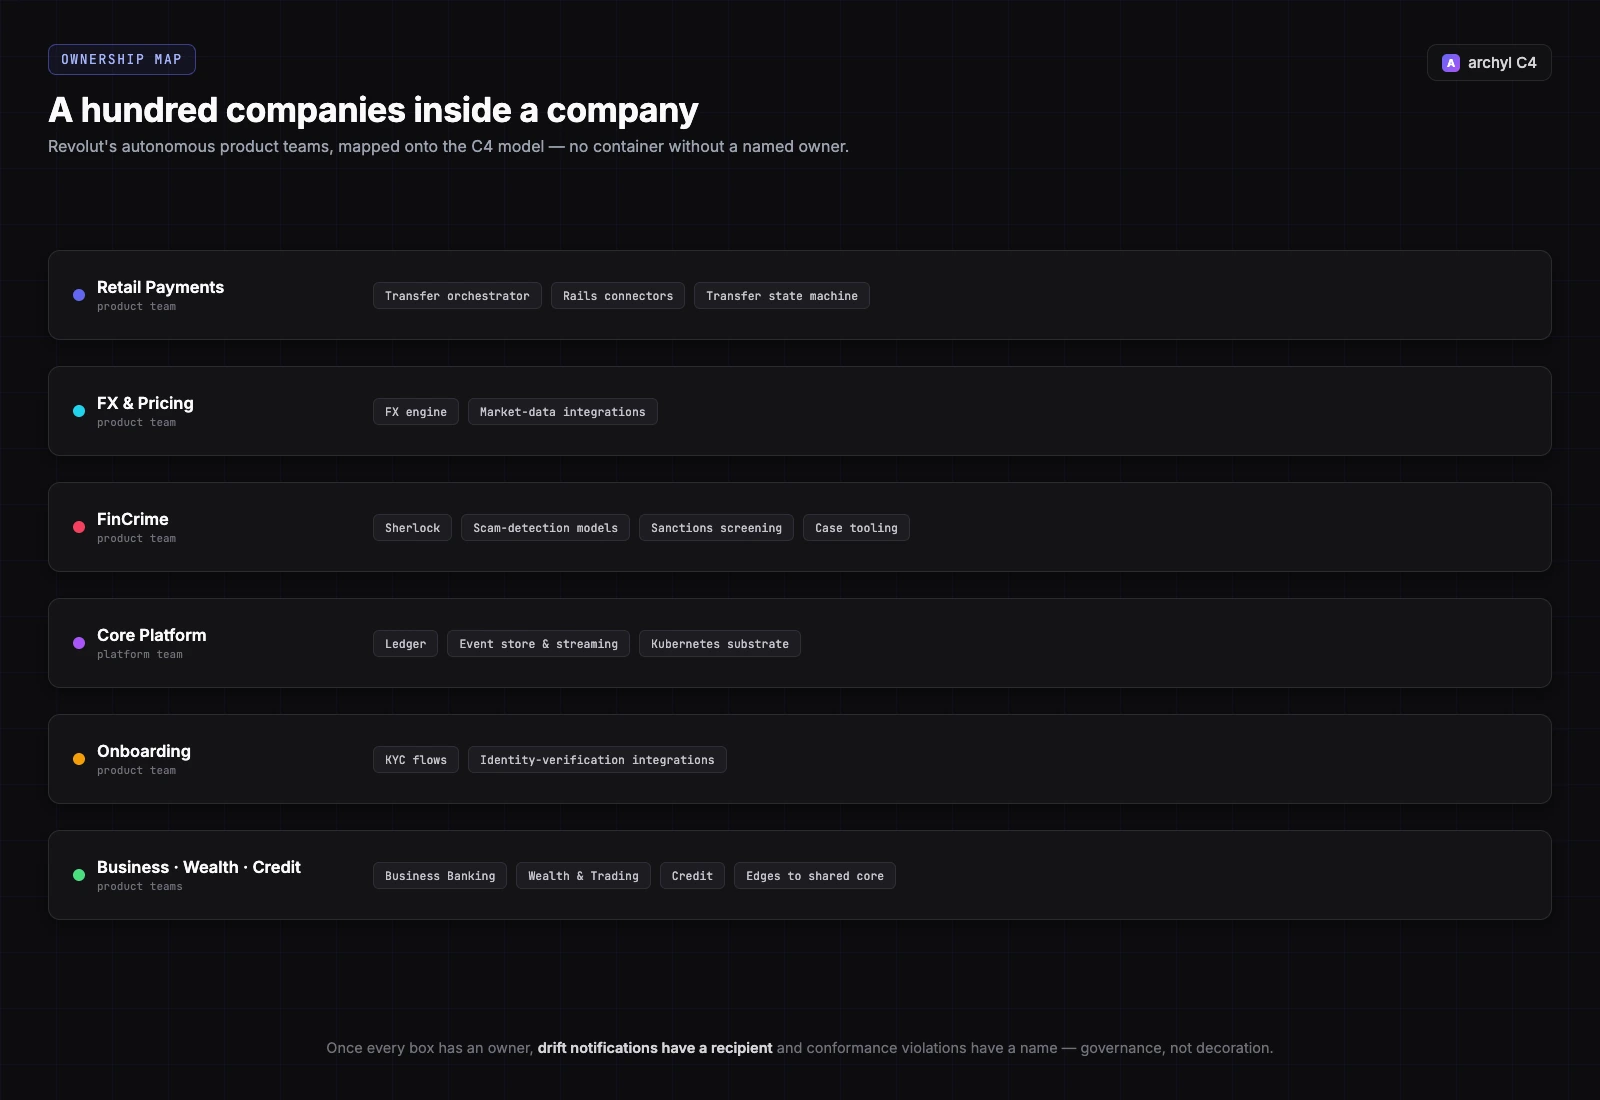
Revolut ist bekanntermaßen als autonome Produkt-Teams organisiert — die Führung spricht über das Unternehmen als "hundert Startups", jedes mit einem Owner, der end-to-end für die Metriken, Roadmap und Services eines Produkts verantwortlich ist. Das mappt direkt auf das C4-Modell:
- Retail Payments besitzt den Transfer-Orchestrator, die Rails-Connectors und die Transfer-State-Machine
- FX & Pricing besitzt die FX-Engine und ihre Marktdaten-Integrationen
- FinCrime besitzt Sherlock, die Scam-Detection-Modelle, das Sanktions-Screening und das Case-Tooling
- Core Platform besitzt den Ledger, den Event Store und die Streaming-Plattform sowie das Kubernetes-Substrat
- Onboarding besitzt die KYC-Flows und die Identity-Verification-Integrationen
- Business, Wealth, Credit besitzen jeweils ihre Produkt-Systeme und ihre Schnittstellen zum gemeinsamen Core
Sobald jeder Container einen Owner hat, hört das Modell auf, Dokumentation zu sein, und wird Governance. Ein neuer Service taucht in der Codebase auf, der nicht im Diagramm ist? Ein spezifisches Team bekommt die Drift-Notification. Ein Container versucht, den Ledger direkt zu lesen, statt Events zu konsumieren? Das ist eine Konformitätsregel-Verletzung mit einem Namen dran — und in einem Unternehmen, das seit März 2026 unter PRA-Aufsicht operiert, ist "wem gehört diese Box" eine Frage, die auch Regulatoren stellen.
In Archyl verwandeln die Ownership Map plus Drift-Detection plus der wöchentliche Team-Digest Revoluts Org-Design in eine durchsetzbare Eigenschaft der Architektur: Der Montag-Digest von Retail Payments deckt den Orchestrator und die Rails ab; der von FinCrime deckt Sherlock und die Screening-Pipeline ab. Gleiche Oberfläche, gescoped auf den Perimeter jedes Teams.
Klau das, lass das
Der Sinn davon, die Architektur eines anderen zu modellieren, ist, in der eigenen bessere Entscheidungen zu treffen. Unsere Einschätzung:
Klau das:
- Der Event-Log als Source of Truth, auf PostgreSQL. Du brauchst mit ziemlicher Sicherheit kein Kafka an Tag 1. Eine Append-only-Tabelle mit disziplinierten Consumern gibt dir Replayability, Audit und SQL-Debugbarkeit — und sie skaliert viel weiter, als der Konferenz-Talk-Konsens zugibt.
- Ein hartes Latenz-Budget für die riskanteste Entscheidung. "Fraud-Scoring antwortet in 50 ms oder es approved mit einem Flag" ist ein architektonischer Constraint, der das halbe System für dich designt.
- Ein verantwortlicher Owner pro Box. Revoluts "hundert Startups"-Modell ist extrem, aber seine C4-Übersetzung — kein Container ohne benanntes Team — kostet nichts und ändert alles an Incident Response und Drift.
Lass das (außer du hast Revoluts Kontext):
- Eine eigene Event-Streaming-Plattform bauen. Dieses ADR ist die Folge davon, ein Weltklasse-Plattform-Team und Hunderte von Services zu haben. Bei zehn Services gewinnen Managed Messaging oder schlichte Postgres-Queues.
- In-house Card Processing. Die Entscheidung hat sich bei Millionen von Transaktionen pro Woche ausgezahlt. Darunter ist es PCI-Scope und Audit-Last ohne Upside — die Kontext-Sektion von ADR-002 leistet hier die Schwerarbeit.
Du brauchst keine 70 Millionen Kunden
Die Disziplin skaliert nach unten. Context von Container von Component zu trennen; das ADR zu schreiben, das eine path-dependent Entscheidung erklärt (wir haben Kafka übersprungen, wir haben das Processing in-house geholt, wir haben den Profile Store gekauft); jeder Box einen Owner zuzuordnen — das ist es, was einen Stack von dreißig Services lesbar hält, während er zu einem Stack von dreihundert wird.
C4 + ADRs + Ownership + Drift + Konformität ist das, was Archyl dir out of the box gibt. Revolut ist einfach das, wie diese Disziplin aussieht, wenn sie ein Jahrzehnt lang mit Fintech-Geschwindigkeit aufgezinst wird — von null zu einer 75-Milliarden-Dollar-Bank auf Java, Postgres und ungewöhnlich klarer Ownership.
Öffne deine eigene Architektur. Zeichne die Systeme (acht, oder drei). Folge dem Äquivalent von Léas £450 in deinem Produkt durch die Container. Schreibe die drei ADRs, nach denen ein Senior Hire in Woche eins fragen würde. Ordne jeder Box ein Team zu.
Du wirst weiter sein als die meisten Engineering-Organisationen in einem Jahr.
FAQ
Nutzt Revolut Kafka? Nein — aus bewusster Entscheidung. Revolut persistiert Events in einem PostgreSQL-basierten Event Store und hat seine Streaming- und Messaging-Plattform selbst in Kotlin gebaut (JetBrains Ktor, Coroutines) — einfacher zu warten, anzupassen und abzufragen als ein Kafka-Deployment.
Welche Datenbank nutzt Revolut? PostgreSQL ist das Rückgrat — auch für den Event Store, der als Source of Truth dient — ergänzt durch Redis fürs Caching und Couchbase als In-Memory-Profile-Store innerhalb der Sherlock-Fraud-Engine.
In welcher Programmiersprache ist Revolut geschrieben? Das Backend ist überwiegend Java (17/21), mit Kotlin für die Event-Streaming-Plattform und jOOQ für typisierten SQL-Zugriff. Es läuft auf Google Cloud und Kubernetes.
Ist Revolut eine echte Bank? Ja. Revolut operiert unter einer EU-Banklizenz (über die Bank of Lithuania) und erhielt im März 2026 seine volle britische Banklizenz von der PRA, nach der eingeschränkten Lizenz vom Juli 2024.
Wie erkennt Revolut Fraud? Mit Sherlock, einem selbstgebauten Machine-Learning-System: CatBoost-Modelle scoren jede Kartentransaktion in unter 50 Millisekunden gegen Verhaltensprofile in Couchbase und retrainieren jede Nacht. Revolut berichtet Fraud-Verluste von etwa 1¢ pro verarbeitete $100, gegenüber einem Branchendurchschnitt von 7–8¢.
Willst du deine eigene Architektur in C4 modellieren? Starte mit Archyl. Das ist der vierte Post der Anatomie-Serie — lies Stripe: Anatomie eines Charges, Netflix: Anatomie eines Plays und Uber: Anatomie eines Rides, oder tauche ein in warum ADRs und C4 besser zusammen funktionieren.