AI 驱动的发现
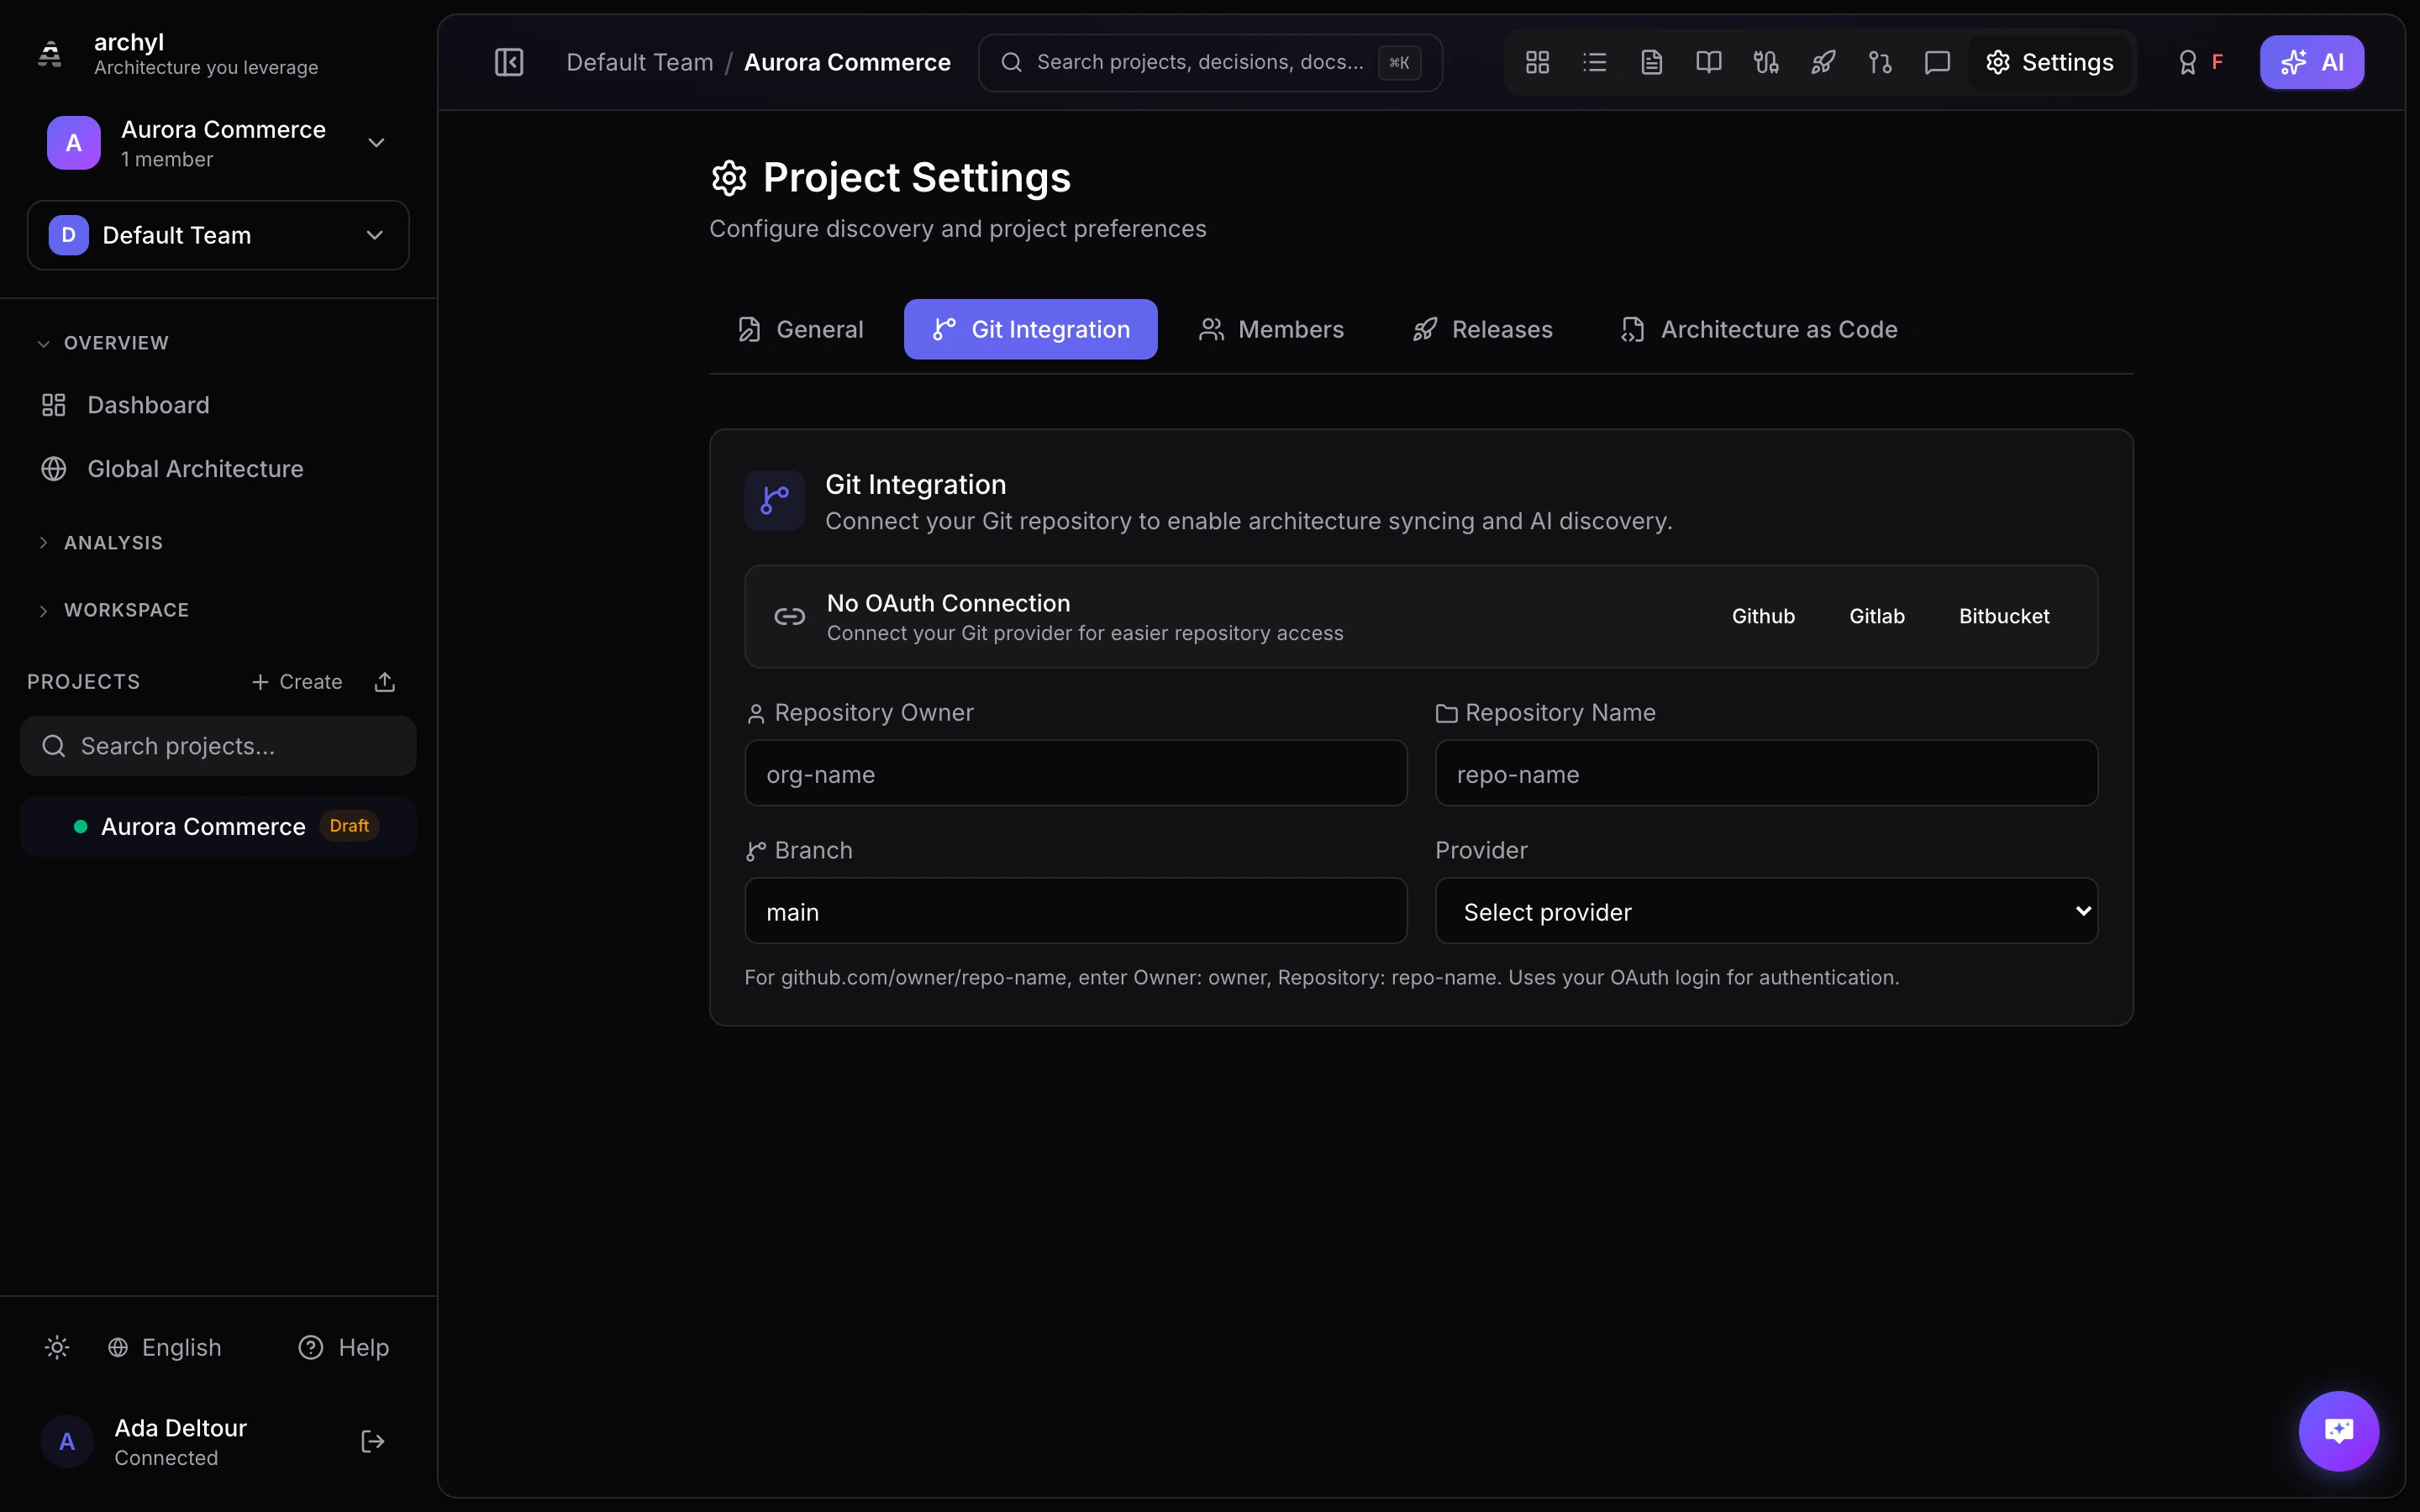
Archyl 的 AI 发现功能分析您的代码库,自动发现和记录您的软件架构。这节省了大量手动编写文档的时间,并确保架构文档与实际代码保持同步。
工作原理
1. 连接您的仓库
首先,将您的 Git 仓库连接到 Archyl:
- 前往项目设置
- 点击"连接仓库"
- 选择您的 Git 提供商(GitHub、GitLab、Bitbucket、Azure DevOps、Gitea 或自托管实例)
- 授权 Archyl 访问您的仓库
2. 开始发现
连接后,启动 AI 发现:
- 在项目中点击"开始发现"
- 选择要分析的分支
- 点击"运行发现"
3. AI 分析
AI 分多个阶段分析您的代码库:
- 结构分析 — 识别系统名称、容器和外部依赖
- 详细发现 — 将源文件分块并行分析,找出组件、代码元素和关系
- 关系优化 — 交叉比对各个容器,找出服务之间的依赖
- 并行后置分析 — 发现 ADR、文档、API 契约和包依赖
发现的元素包括:
- 系统:顶层软件系统和外部依赖
- 容器:服务、API、数据库、Web 应用、后台工作进程
- 组件:模块、包、处理器、仓储、服务
- 代码元素:带文件路径的类、接口、函数
- 关系:元素之间如何通信(uses、calls、sends to、reads from)
4. 审查与批准
发现的内容会以 待处理 状态等待审查:
- 审查每个发现的元素
- 编辑名称、描述或关系
- 批准准确的发现
- 拒绝或修改不正确的发现
对于新项目(尚无任何 C4 元素),发现的内容会被自动批准,帮助您快速上手。
增量发现
增量发现仅分析变更的文件,而不是整个仓库,以此保持 C4 模型的最新状态。这种方式更快、成本更低,并且可以在每次推送时自动运行。
增量发现的工作原理
- 代码被推送到默认分支
- Archyl 接收推送事件(通过 Webhook 或 GitHub Action)
- 从推送的提交中提取变更的文件
- 仅分析源文件(已删除的文件会被跳过)
- AI 在较小的文件集上运行
- 新元素作为待处理的发现被创建,等待审查
- 已有元素会自动去重,不会产生重复
启用增量发现
有两种方式启用增量发现:
方式 A:GitHub Webhook(零配置)
- 前往项目的 Webhook 配置 设置
- 启用 推送时发现
- 复制 Webhook URL,并将其添加到 GitHub 仓库设置中
- 选择
push事件
此后每次推送到默认分支都会自动触发增量发现。
方式 B:GitHub Action(CI/CD)
将 Archyl Incremental Discovery Action 添加到您的工作流中。完整的配置说明请参阅 GitHub Actions 集成。
name: Architecture Sync
on:
  push:
    branches: [main]

jobs:
  discovery:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 2
      - uses: archyl/archyl/.github/actions/incremental-discovery@main
        with:
          api-key: ${{ secrets.ARCHYL_API_KEY }}
          project-id: ${{ vars.ARCHYL_PROJECT_ID }}
完整发现 vs 增量发现
| 完整发现 | 增量发现 | |
|---|---|---|
| 范围 | 整个仓库 | 仅变更的文件 |
| 触发方式 | 手动(UI/API) | 自动(推送 Webhook 或 GitHub Action) |
| 速度 | 分钟级(取决于仓库大小) | 秒级到分钟级 |
| AI 成本 | 较高(分析所有文件) | 较低(仅分析差异) |
| 使用场景 | 初始设置、重大重构 | 日常代码变更 |
| 去重 | 与现有模型完整去重 | 同样去重,不会产生重复 |
结合使用完整发现与增量发现
推荐的工作流程:
- 首次连接仓库时运行完整发现
- 启用增量发现,让模型保持最新
- 在重大重构或迁移后重新运行完整发现
增量发现与完整发现一样会创建待处理的元素:变更应用到 C4 模型之前,您始终会先进行审查。
支持的技术
AI 发现支持 15 种以上的语言和框架:
编程语言
Go、TypeScript、JavaScript、Python、Java、Kotlin、Rust、C#、C/C++、Ruby、PHP、Swift、Scala
构建系统与包管理器
npm、Go modules、pip/Poetry、Maven、Gradle、Cargo、Composer、RubyGems、NuGet、CMake(find_package、FetchContent、CPM)、Conan、vcpkg
框架
React、Next.js、Vue、Angular、Express、Fastify、NestJS、Django、Flask、FastAPI、Spring Boot、ASP.NET Core、Ruby on Rails、Gin、Fiber
基础设施
Docker、Kubernetes、Terraform、Helm、Ansible、GitHub Actions、AWS CDK、Pulumi
Monorepo 支持
Archyl 会自动识别 Monorepo 结构:
- apps/、packages/、services/、libs/ 目录
- 按比例在各个服务之间抽样文件
- 每个服务映射为 C4 模型中一个独立的容器
- 识别跨服务的关系
最佳实践
从小处开始
对于大型代码库:
- 从单个服务或模块开始
- 审查并完善结果
- 逐步扩展到其他区域
定期更新
保持文档的时效性:
- 启用增量发现以自动更新
- 定期审查待处理的发现
- 在重大重构后运行完整发现
结合手动操作
AI 发现是一个起点:
- 使用 AI 完成繁重的工作
- 手动添加业务上下文(描述、ADR)
- 完善关系和描述
REST API
POST   /api/v1/discovery/start                            # Start full discovery
GET    /api/v1/discovery/jobs/:jobId                       # Get job status
POST   /api/v1/projects/:id/discovery/incremental          # Trigger incremental discovery
故障排除
发现耗时过长
- 减少分析的文件数量(在配置中调整最大文件数)
- 使用增量发现进行日常更新
- 聚焦特定分支
结果不准确
- 边使用边审查和纠正:待处理机制让您可以逐个批准或拒绝元素
- 结构越清晰的代码,结果越好
- 为已批准的元素添加描述,为后续的发现提供更多上下文
没有分析任何文件
- 检查仓库是否已连接,以及分支是否存在
- 确保源文件使用可识别的扩展名(.go、.ts、.py、.java 等)
- 确认访问令牌对该仓库具有读取权限