免责声明。 本文完全基于 Stripe 的公开沟通 — 他们的工程博客、会议演讲、开源仓库和外部案例研究。这不是一份 Stripe 官方架构文档。我们建模公开已知的内容,以说明一个复杂技术栈如何能用 C4 模型变得 readable。当某些细节是推断而非 Stripe 明确陈述时,我们会注明。
Charge 的解剖学:用 Archyl 以 C4 建模 Stripe
黑色星期五太平洋时间凌晨 3 点,一个 POST 请求打到 Stripe。二十秒后,商家已被入账,持卡人的发卡行已批准扣款,资金正排队进入 settlement,商家服务器已收到一个签名的 webhook,Stripe 的风险引擎在 100 毫秒内对该交易打了分。
那个单次请求,在 BFCM 2024 高峰每秒重复 27,395 次,会穿越十四个 Stripe 系统和至少四个外部网络,然后第零帧才到达商家的仪表板。
2025 年,Stripe 通过这个技术栈处理了 1.9 万亿美元,在黑色星期五期间维持 99.9999% 的运行时间 — 六个九,相当于一年 32 秒的停机。他们在大约一千五百万行 Ruby 上做到这一切,这些 Ruby 由他们自家定制的类型系统进行类型检查。
如何理解一个驱动半个互联网信用卡支付的技术栈?和 Netflix 一样,你不能 — 不能一次理解。这正是 C4 模型被发明用来解决的问题。
在这篇文章中,我们跟随一个用户动作 — 一次 stripe.PaymentIntents.create() 调用 — 看它穿越 Stripe 在四个 C4 层级上的架构。我们不会涵盖每个产品。我们将追踪一笔 charge,撰写解释一路上选择的 ADR,并以拥有每个盒子的团队地图作为结尾。
层级 1 — System Context:十五个产品,一万亿美元
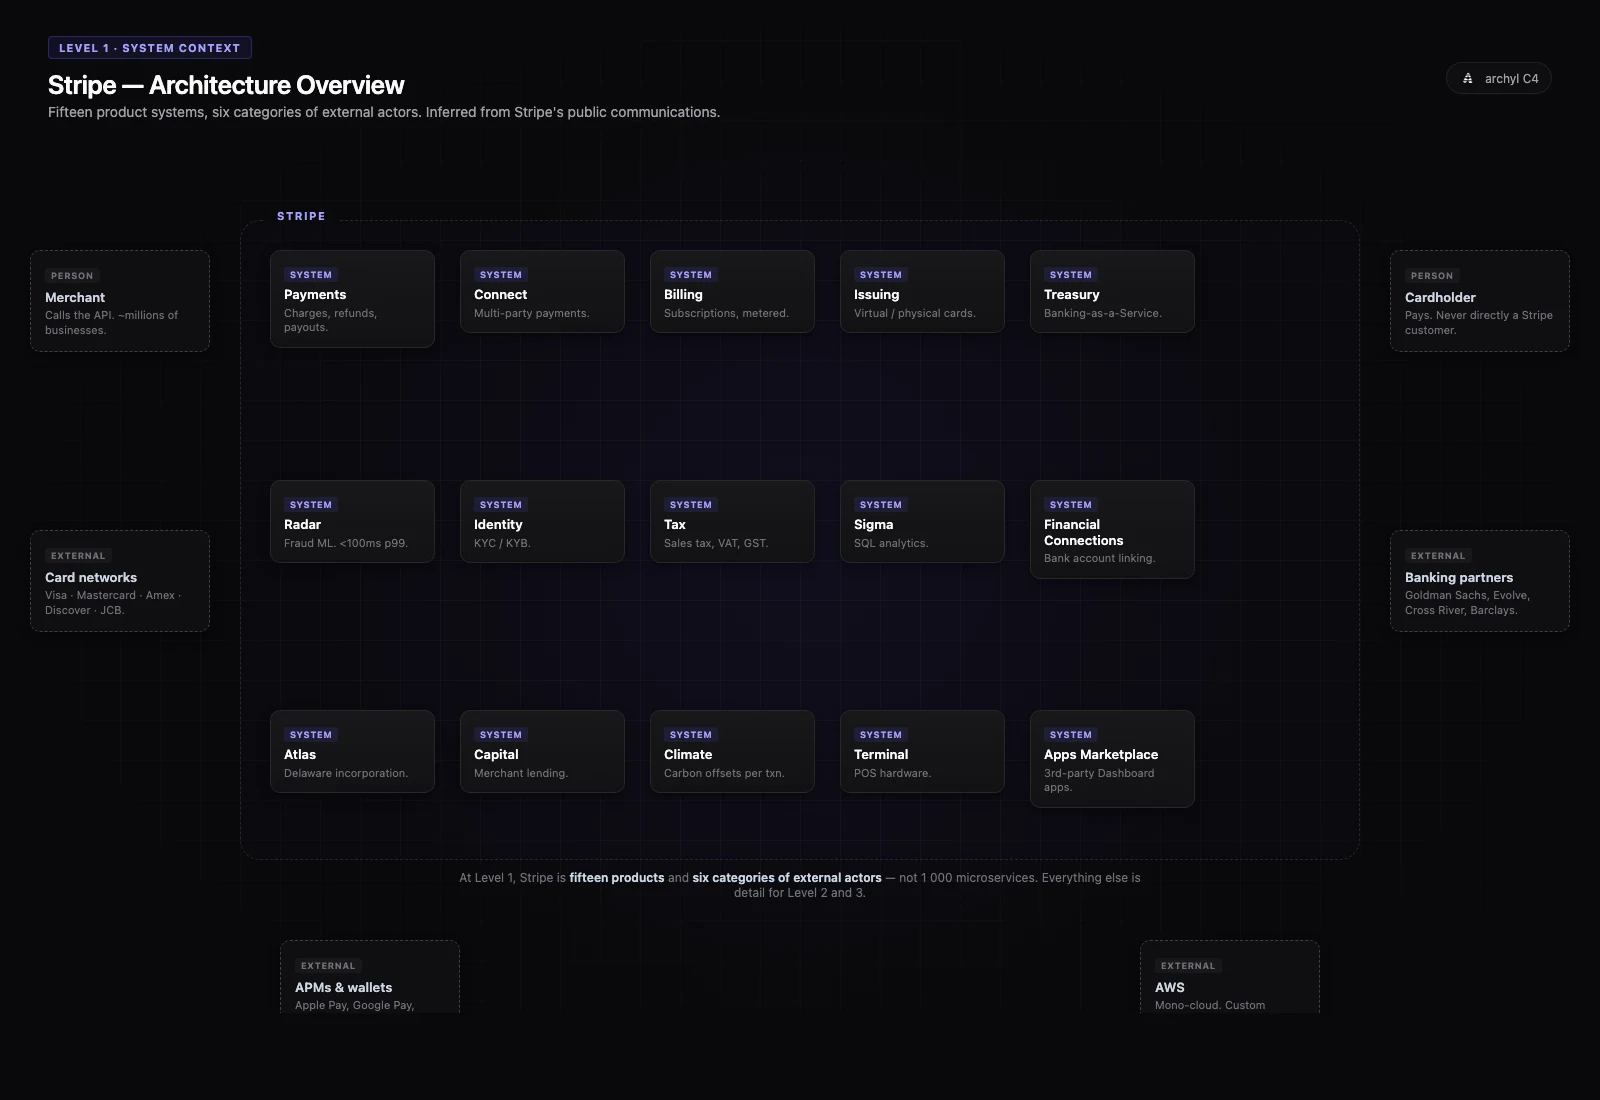
在 System Context 层级,Stripe 不是"一个支付 API"。它是十五个不同的产品系统共享一个基础:
- Payments — 历史核心:charges、payment intents、退款、payouts
- Connect — 多方支付、市场、平台
- Billing — 订阅、发票、按用量计费
- Atlas — Delaware C-Corp/LLC 公司注册
- Capital — 商家贷款
- Issuing — 虚拟和物理卡的创建
- Treasury — banking-as-a-service(Goldman Sachs 合作)
- Identity — KYC/KYB 验证
- Tax — 销售税、增值税、GST
- Climate — 每笔交易的碳抵消
- Radar — 机器学习欺诈检测(100ms 以下评分)
- Sigma — Stripe 数据上的 SQL 分析
- Terminal — POS 硬件
- Financial Connections — 银行账户连接(他们的 Plaid)
- Apps Marketplace — Dashboard 中的第三方应用
围绕它们:商家、持卡人、四个卡组织(Visa、Mastercard、Amex、Discover)加上区域性卡组织(JCB、银联)、100 多种替代支付方式(Apple Pay、Klarna、ACH、SEPA、iDEAL...)、收单和发卡银行、银行合作伙伴(Goldman Sachs、Evolve、Cross River)、税务机关、身份提供方,以及作为底层云的 AWS(单云)。
十五个系统、八类外部参与者。其余都是细节。
这就是层级 1 的礼物:在 System Context 你不需要知道 Payments 是 20 个微服务。你需要知道它存在,它和卡组织对话,Connect 与 Treasury 协作,而 AWS 支撑一切。图是一个对话起点,不是清单。
ADR-001 · 第一天就把 Idempotency keys 集成到 API
状态 · Accepted (2011 年,2026 年依然活跃)
背景 · 网络不可靠。重试一次失败 POST /charges 的商家可能会双重扣款客户。2011 年行业的回应是 "商家应该自己处理" — 把分布式系统复杂性推给每个 API 消费者。
决策 · 在每次 mutating API 调用上要求 Idempotency-Key。存储该键、请求哈希和响应。重试时,如果键匹配则重放存储的响应。把它作为 API 的一等公民发布,而不是 opt-in。
后果 · Stripe 的 idempotency 模型成了行业事实标准。IETF 的 Idempotency-Key 草案直接受其启发。每个 Stripe API 用户(无论自觉与否)都受益于一个把 POST /charges 变成可安全重试操作的契约。我们将在层级 3 深入它的工作机制。
这是塑造 Stripe API 表面最强的单一架构选择。没有它,C4 模型就必须在每个 mutating boundary 暴露重试逻辑 — 把分布式系统复杂性泄露给每个消费者。
在 Archyl 中,这就是 ADR 赢得自己位置的方式:它解释 为什么 boundary 是这个样子。
层级 2 — Container:深入 Payments core
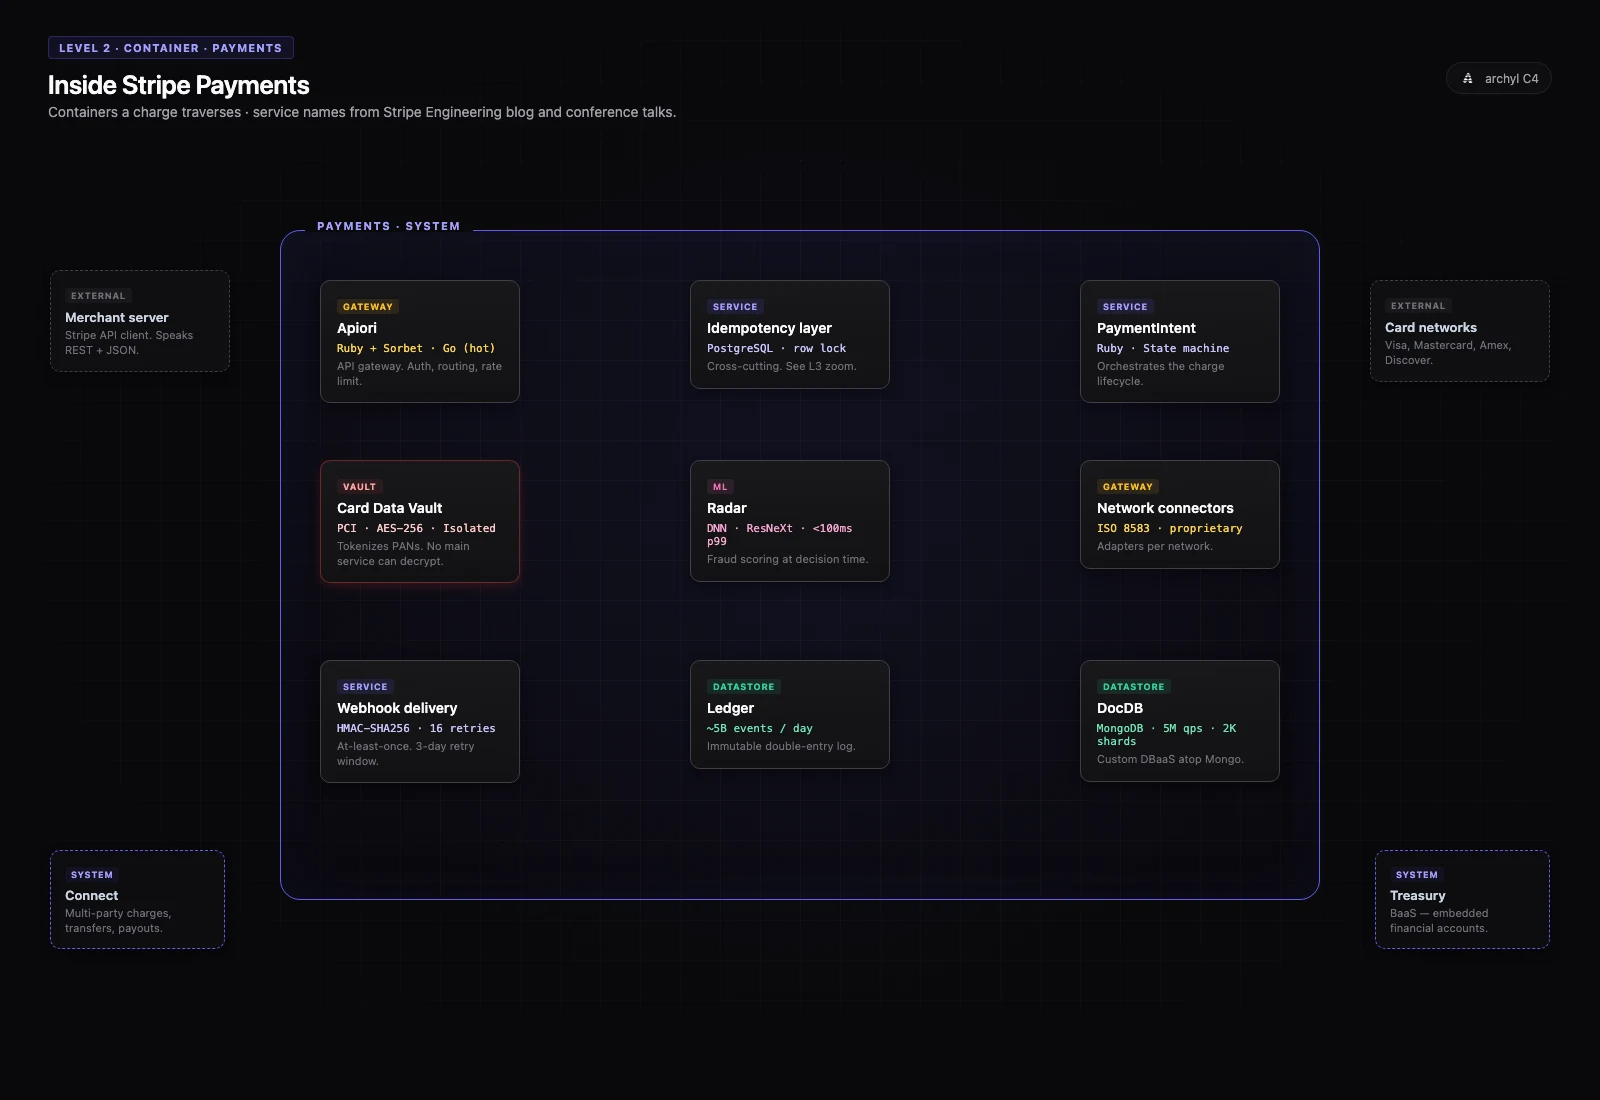
商家的 stripe.PaymentIntents.create() 落在 Payments 的边缘。我们打开盒子。
Payments 内部,公开来源至少揭示了这些 container:
- Apiori — API 网关。最初是 Ruby + Rails,热点路径代码逐步用 Go 重写,以便在 auth 和 routing 层达成 sub-150 µs 延迟。
- Idempotency layer — 坐在每个 mutating endpoint 前面的 cross-cutting concern。基于 PostgreSQL 与 row-level locking。
- PaymentIntent service — 编排状态机:
requires_payment_method→requires_confirmation→requires_action(3DS 挑战)→processing→succeeded(或requires_capture)。 - Card Data Vault — 物理隔离的 PCI 环境,AES-256 at rest,主服务无法解密 PAN。所有卡数据都通过令牌化。
- Radar — 100 ms p99 以下的欺诈评分。自 2022 年起纯 DNN,基于 ResNeXt 的架构灵感。
- Network connectors — 面向 Visa、Mastercard、Amex 等的适配器。在线缆上讲 ISO 8583 和专有协议。
- Webhook delivery service — at-least-once 投递,3 天内 16 次重试,指数退避,HMAC-SHA256 签名。
- Ledger — 不可变事件日志,每天 ~50 亿事件,每笔支付 ~100 条 ledger 条目。对账、审计、会计的 source of truth。
- DocDB — Stripe 自研的 Database-as-a-Service,构建在 MongoDB 之上。每秒 500 万次查询,5,000 多个 collection,2,000 多个 shard,PB 级金融数据。
此层级的技术栈:主导语言 Ruby + Sorbet 类型(1500 万行)、热点路径用 Go、关系型关注点(idempotency、accounts)用 PostgreSQL、高吞吐 document 工作负载用 DocDB、事件用 Apache Kafka、实时分析用 Apache Pinot、流处理用 Apache Flink。
典型的 charge 触发 Apiori → Idempotency layer → PaymentIntent service → (用 Vault 做 token) → (并行 Radar 做风险) → Network connector → Ledger → Webhook fanout。所有这些,带重试,通过 Veneur 端到端 instrumented,任何外部 egress 都通过 Smokescreen 安全路由。
ADR-002 · DocDB — 在 MongoDB 之上构建,而非重写
状态 · Accepted (~2018 年,持续投资)
背景 · 到 2018 年,Stripe 在 MongoDB 上的数据量正压垮现成产品:PB 级 collection 的 schema 迁移很危险,sharding 是运维负担,99.999% 的 uptime 要求不留维护窗口。行业本来会说 "重写到关系型 store"。
决策 · 不把数据层迁移到另一个引擎。相反,在 MongoDB 之上 构建一个自研的 Database-as-a-Service:Database Proxy、Chunk Metadata Service、把 dual-write/backfill/dual-read/cleanup 模式作为托管原语执行的 Data Movement Platform、面向出站事件的 CDC 服务。
后果 · Stripe 拿到了 MongoDB 灵活 document 模型的好处加上托管平台的运维保证:5 M QPS、99.999% 稳态 uptime、零停机迁移作为日常操作。互联网偶尔传言的"Mongo → DynamoDB"迁移?从未发生。他们反而双倍下注。
这条 ADR 是 path-dependent 架构 的极佳例子:2018 年的正确答案是延展,不是替换。
层级 3 — Component:Idempotency layer 内部
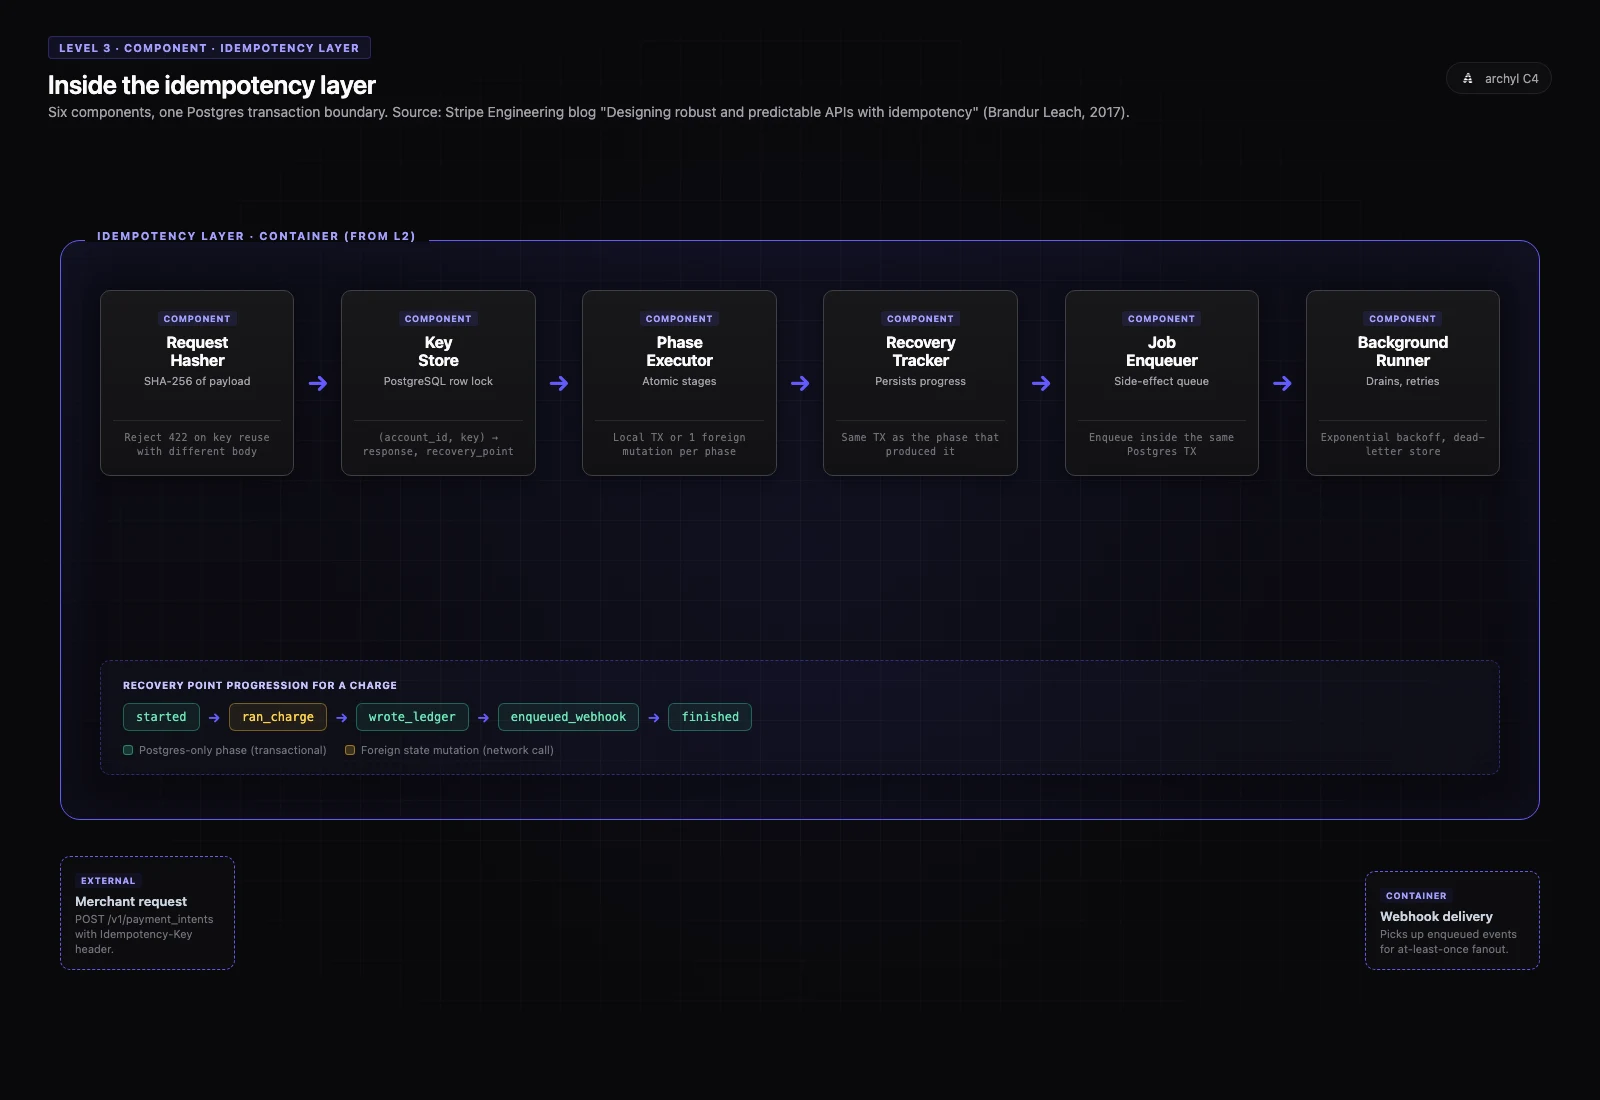
在 Stripe 技术栈的所有组件中,Idempotency layer 是公开记录最多的 — Brandur Leach 2017 年的帖子至今仍是分布式系统工程师的经典参考。
一次带 idempotency key 的 POST /charges 在该层中穿越这些组件:
- Request hasher — 计算请求载荷的确定性哈希。如果同一个 idempotency key 带不同载荷出现,API 返回 422(客户端犯了编程错误)。
- Idempotency key store — 以
(account_id, idempotency_key)为键的 PostgreSQL 表。包含request_hash、response_code、response_body、recovery_point、last_run_at、locked_at。locked_at列实现并发重试的 row-level locking。 - Phase executor — 把操作切分成由 foreign state mutations 分隔的原子阶段。每个阶段要么纯本地(只 Postgres,与 idempotency 行的事务在一起),要么是单一外部副作用(Vault tokenize、network charge、发送 webhook)。
- Recovery point tracker — 持久化当前阶段:
started→ran_charge→wrote_ledger→enqueued_webhook→finished。重试时,executor 从 recovery point 恢复。 - Job enqueuer — 对于异步副作用(emails、webhooks),把持久 job 入队到与 recovery point 更新 同一个 Postgres 事务 中。结构上原子。
- Background runner — 用自有的重试语义、指数退避和 dead-letter store 消耗 job 队列。
这个模式一旦看到就极其简单:所有本地变更与 idempotency 行更新位于同一 Postgres 事务;所有外部变更位于两个 recovery point 之间。这种形状消除了一整类困扰那些没有这种原语的分布式系统的双写 bug。
这就是 Component 级 C4 的样子:不是 "这里有些代码",而是 "这里是一连串业务上有意义的原语,每个都被 owned、每个都可替换、每个都可测量"。
ADR-003 · Sorbet — 投资类型检查器,而非重写 Ruby
状态 · Accepted (~2017 年,2019 年开源,依然为默认)
背景 · 到 2017 年,Stripe 的 Ruby + Rails 单体已经超过 1000 万行。该规模 fintech 行业的主流建议是 用类型语言重写 — Java、Go 或 Scala。估算成本是数年和数百名工程师。同时 Ruby 的 DX 是 Stripe 快速发布的竞争优势。
决策 · 不重写。为 Ruby 构建渐进式类型检查器。用 18 个月和小团队发布一个能扩展到数百万行、IDE 级、多线程的类型系统。开源它。
后果 · Sorbet 现在以 sub-second 增量延迟为 1500 万行 Stripe Ruby 做类型检查。Stripe 从未支付重写税。他们支付了 发明类型检查器税 — 一次。Sorbet 已成为 Coinbase、Shopify、GitHub 等使用的有意义的开源项目。
在 Archyl 模型中,这样的 ADR 与架构一起旅行。当你在 2026 年点开 Apiori container 看到 "Ruby + Sorbet" 时,你也看到 2017 年的决策,解释为什么不是 Java。
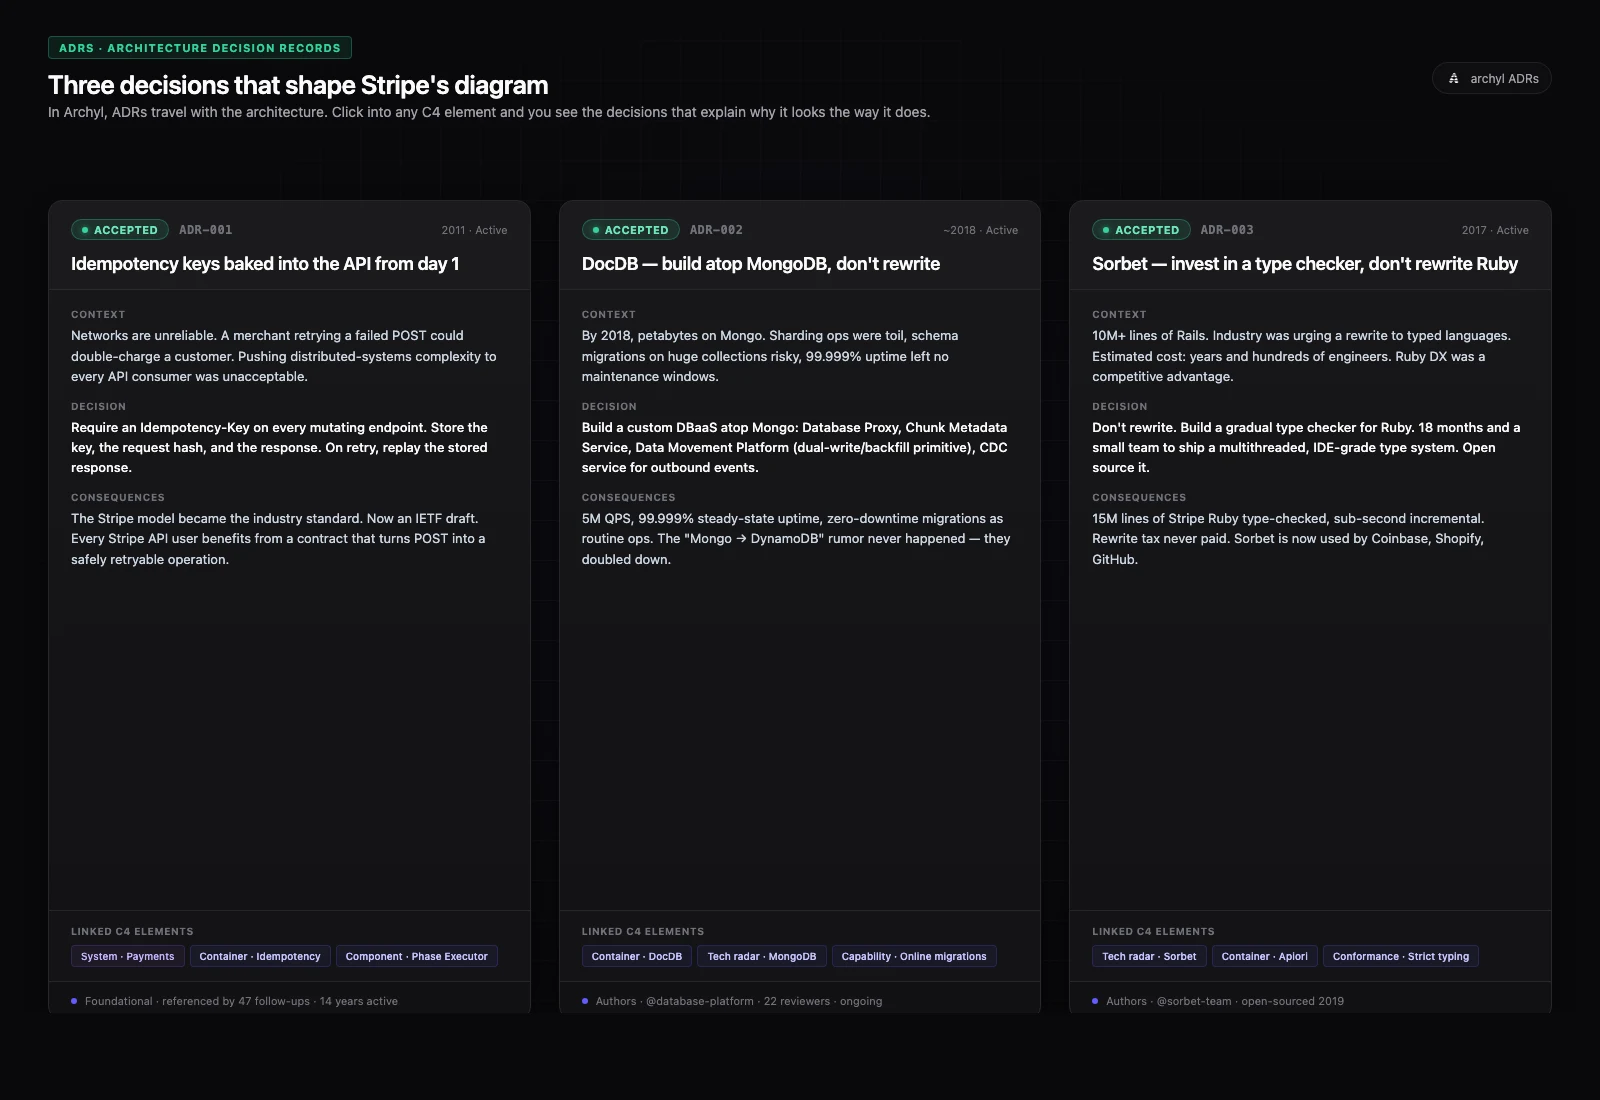
三个决策。Archyl 中的三个卡片,每个都连接到它塑造的 C4 元素 — Idempotency keys 到每个 mutating endpoint、DocDB 到数据层、Sorbet 到每个 Ruby container。图是现在;ADR 是为什么。
Ownership:把模型变成问责
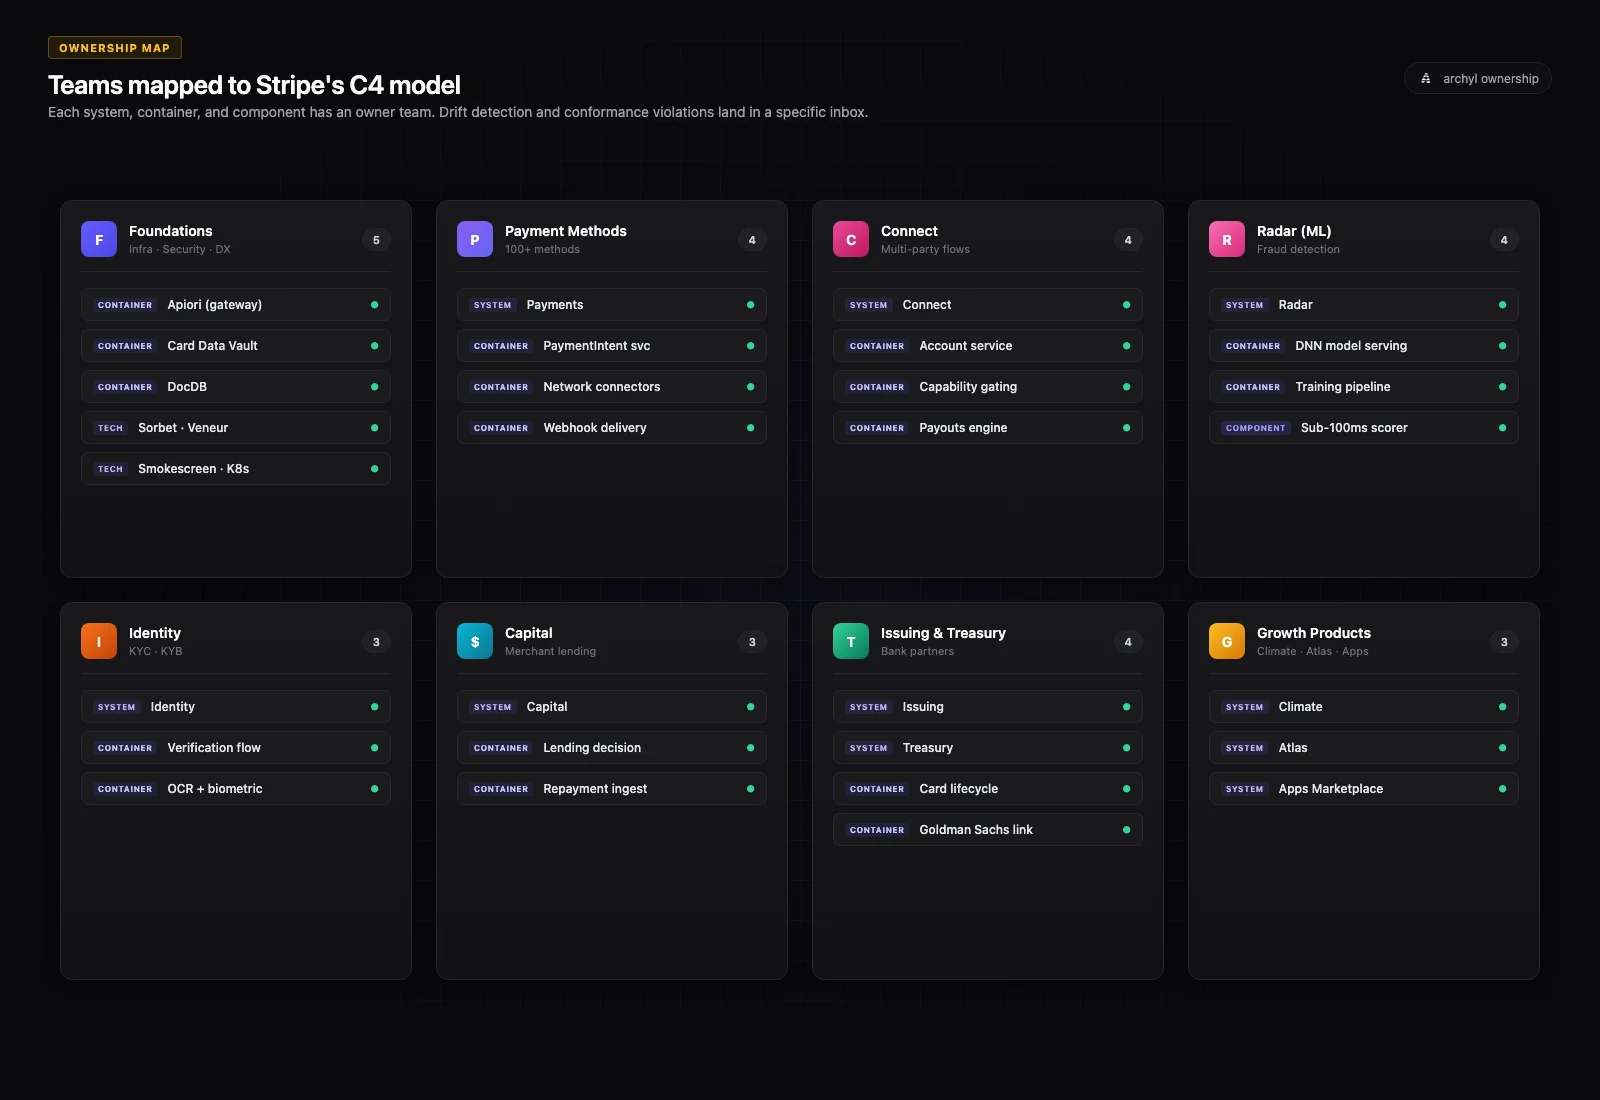
C4 模型在你将团队映射到它之前是一个静态产物。
Stripe 公开沟通其工程结构:强大的 Foundations 组(Infrastructure、Security、Data Platform、Developer Experience)、对齐到每个主要系统的产品团队(Payment Methods、Connect、Capital、Identity、Issuing、Treasury、Climate、Radar)、ML 与 observability 的横切组。
把它们落到 C4 模型上:
- Foundations 拥有 Apiori、Sorbet、Veneur、Smokescreen、Kubernetes 平台、DocDB、Card Data Vault — 每个产品赖以构建的基础
- Payment Methods 拥有 Network connectors、PaymentIntent 状态机、按方法的服务(卡、ACH、SEPA、钱包)
- Connect 拥有 Account 服务、capability gating、多方资金流、payouts
- Capital 拥有放贷决策流水线和与商家 Stripe Payments 历史的整合
- Identity 拥有 KYC/KYB 工作流和 Connect 入网的合规闸门
- Radar(ML 团队)拥有欺诈 DNN、模型服务、训练流水线
- Issuing & Treasury 拥有银行合作伙伴整合和卡生命周期
- Climate 拥有与碳抵消市场的整合
这种映射不是装饰。它是其后一切的基础。
一旦系统、container 或组件有了团队所有者,drift 检测就变得有责任:当一个新服务出现在提交里却不在图上时,某个具体团队会被询问。当合规规则被违反时(比如非 Foundations 的服务直接读 Card Data Vault),inbox 里就有一个名字。
在 Archyl 中,Ownership Map 是文档工具变成治理工具的瞬间。
Drift、合规和每周摘要
这种规模的模型会漂移。新产品上线 — 2022 年的 Climate、Treasury、Tax 的扩展、Apps Marketplace。栈在变 — Apiori 路径迁移到 Go,Pinot 替代更老的分析,Sorbet strictness 上升。
Archyl 每周计算一个 drift 分数:已记录的 C4 模型与代码中实际状态之间的差距。合规规则添加策略层 — "每个 container 都需要一个所有者团队"、"只有 Foundations 服务才能读 Card Data Vault"、"每次公开 API 变更必须引用 versioning ADR"。
对 Stripe 而言,这是 1500 万行和每秒 27,000 请求规模的 drift 检测。但规则与十个服务时相同。
而最近发布的 Team Architecture Digest,在类 Stripe 的设置中意味着:
- Foundations 周一摘要覆盖 Apiori、Vault、DocDB、K8s 平台
- Payment Methods 摘要覆盖 Network connectors、PaymentIntent service、各方法整合
- Radar 摘要覆盖欺诈 DNN、训练流水线、模型上线
- 每个摘要都被 scope 到自己团队拥有的边界内
相同的表面。不同的 scope。这就是 C4 + ownership 解锁的对称性。
你不需要处理一万亿美元
你不是 Stripe。大多数工程组织都不是。
但教训也向下扩展。把 Context 与 Container 与 Component 分开的纪律、撰写解释 path-dependent 决策的 ADR(我们在 Mongo 之上构建、我们对 Ruby 进行类型检查而不是重写)、给每个框附上 ownership — 这种纪律就是阻止五十个服务的栈感觉像一千五百万行的东西。
C4 + ADR + Ownership + Drift + 合规就是 Archyl 开箱即用提供的。Stripe 这个例子只是该模型在金融系统域上最大的合理压力测试。
打开你自己的架构。勾画十五个产品(如果只有三个就三个)。挑过去决策最令人意外的那个深入到它的 container。写三条 ADR 解释会让新人困惑的部分。给每个 container 映射一个团队。
你将走在大多数工程组织一年才能到达的位置之前。
想用 C4 建模你自己的架构?从 Archyl 开始。也可以读 为什么 ADR 和 C4 一起更好用 或 Architecture Change Requests 如何把 pull request 的严谨带到你的 C4 模型。前一个案例研究建模了 Netflix in C4 — Anatomy of a Play。