AI によるディスカバリー
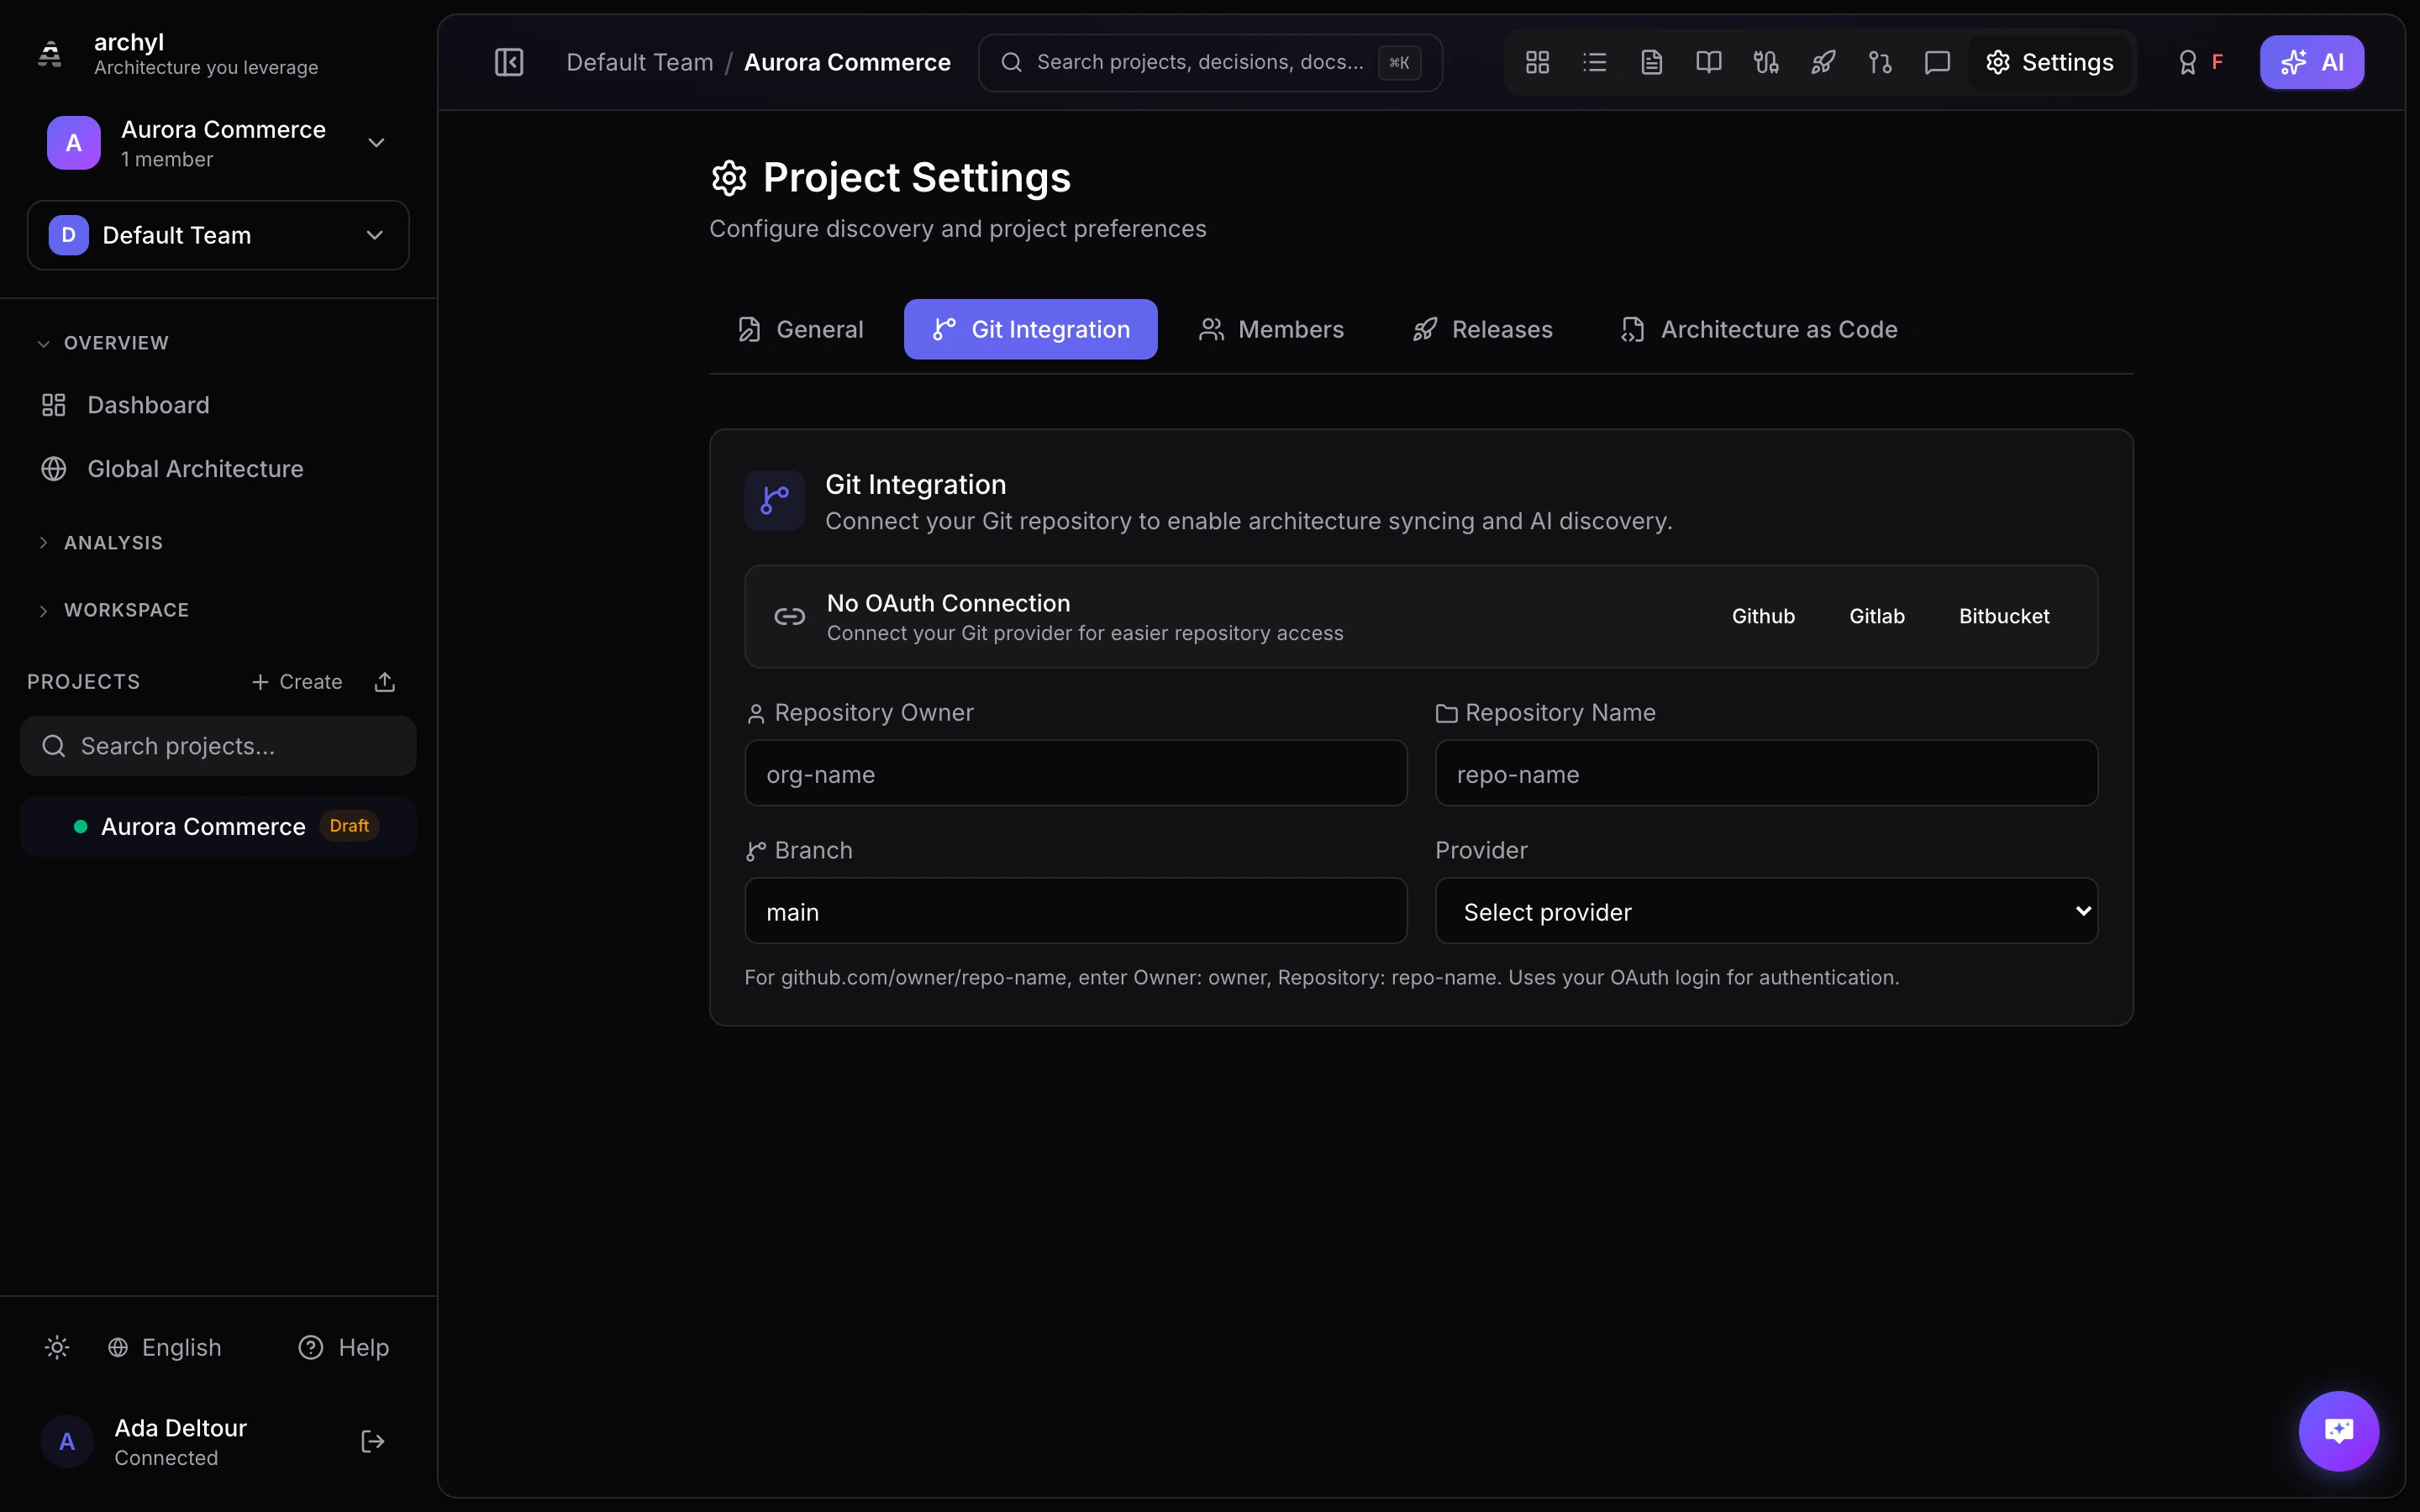
Archyl の AI ディスカバリー機能は、コードベースを分析してソフトウェアアーキテクチャを自動的に発見・ドキュメント化します。手動でのドキュメント作成にかかる時間を大幅に節約し、アーキテクチャドキュメントが実際のコードと同期した状態を維持できます。
仕組み
1. リポジトリの接続
まず、Git リポジトリを Archyl に接続します:
- プロジェクト設定に移動
- 「リポジトリを接続」をクリック
- Git プロバイダーを選択(GitHub、GitLab、Bitbucket、Azure DevOps、Gitea、またはセルフホストのインスタンス)
- Archyl にリポジトリへのアクセスを許可
2. ディスカバリーの開始
接続後、AI ディスカバリーを開始します:
- プロジェクトで「ディスカバリーを開始」をクリック
- 分析するブランチを選択
- 「ディスカバリーを実行」をクリック
3. AI 分析
AI は複数のフェーズでコードベースを分析します:
- 構造分析 — システム名、コンテナ、外部依存関係を特定
- 詳細ディスカバリー — ソースファイルを並列のチャンクで分析し、コンポーネント、コード要素、リレーションシップを検出
- 関係性の精緻化 — コンテナ同士を相互参照し、サービス間の依存関係を検出
- 並列の事後分析 — ADR、ドキュメント、API コントラクト、パッケージ依存関係を検出
発見される要素:
- システム: 最上位のソフトウェアシステムと外部依存関係
- コンテナ: サービス、API、データベース、Web アプリケーション、ワーカー
- コンポーネント: モジュール、パッケージ、ハンドラー、リポジトリ、サービス
- コード要素: ファイルパス付きのクラス、インターフェース、関数
- リレーションシップ: 要素間の通信方法(使用する、呼び出す、送信する、読み取る)
4. レビューと承認
ディスカバリーはレビューのため保留中状態に置かれます:
- 発見された各要素をレビュー
- 名前、説明、リレーションシップを編集
- 正確なディスカバリーを承認
- 不正確なものを拒否または修正
新規プロジェクト(既存の C4 要素がない場合)では、すぐに使い始められるようディスカバリーが自動的に承認されます。
インクリメンタルディスカバリー
インクリメンタルディスカバリーは、リポジトリ全体ではなく変更されたファイルのみを分析して C4 モデルを最新に保ちます。より高速で、コストが低く、プッシュごとに自動的に実行できます。
動作の仕組み
- デフォルトブランチにコードがプッシュされる
- Archyl がプッシュイベントを受信(Webhook または GitHub Action 経由)
- プッシュのコミットから変更ファイルが抽出される
- ソースファイルのみが分析される(削除されたファイルはスキップ)
- AI がより小さなファイルセットで実行される
- 新しい要素がレビュー用の保留中のディスカバリーとして作成される
- 既存の要素は自動的に重複排除される — 重複は発生しない
インクリメンタルディスカバリーの有効化
インクリメンタルディスカバリーを有効にする方法は 2 つあります:
オプション A: GitHub Webhook(設定不要)
- プロジェクトの Webhook 設定 を開く
- Discovery on Push を有効化
- Webhook URL をコピーし、GitHub リポジトリの設定に追加
pushイベントを選択
デフォルトブランチへのプッシュのたびに、インクリメンタルディスカバリーが自動的にトリガーされます。
オプション B: GitHub Action(CI/CD)
ワークフローに Archyl Incremental Discovery Action を追加します。セットアップの詳細は GitHub Actions 統合 を参照してください。
name: Architecture Sync
on:
  push:
    branches: [main]

jobs:
  discovery:
    runs-on: ubuntu-latest
    steps:
      - uses: actions/checkout@v4
        with:
          fetch-depth: 2
      - uses: archyl/archyl/.github/actions/incremental-discovery@main
        with:
          api-key: ${{ secrets.ARCHYL_API_KEY }}
          project-id: ${{ vars.ARCHYL_PROJECT_ID }}
フルディスカバリー vs インクリメンタルディスカバリー
| フルディスカバリー | インクリメンタルディスカバリー | |
|---|---|---|
| スコープ | リポジトリ全体 | 変更ファイルのみ |
| トリガー | 手動(UI/API) | 自動(プッシュ Webhook または GitHub Action) |
| 速度 | 分単位(リポジトリサイズによる) | 秒〜分 |
| AI コスト | 高い(全ファイルを分析) | 低い(diff のみを分析) |
| ユースケース | 初期セットアップ、大規模リファクタリング | 日常のコード変更 |
| 重複排除 | 既存モデルに対する完全な重複排除 | 同じ重複排除 — 重複なし |
フル + インクリメンタルの組み合わせ
推奨ワークフロー:
- リポジトリを最初に接続したときにフルディスカバリーを実行
- モデルを最新に保つためにインクリメンタルディスカバリーを有効化
- 大規模なリファクタリングや移行の後にフルディスカバリーを再実行
インクリメンタルディスカバリーも、フルディスカバリーと同様に保留中の要素を作成します。C4 モデルに変更が適用される前に、必ずレビューできます。
対応技術
AI ディスカバリーは 15 以上の言語とフレームワークに対応しています:
言語
Go、TypeScript、JavaScript、Python、Java、Kotlin、Rust、C#、C/C++、Ruby、PHP、Swift、Scala
ビルドシステムとパッケージマネージャー
npm、Go modules、pip/Poetry、Maven、Gradle、Cargo、Composer、RubyGems、NuGet、CMake(find_package、FetchContent、CPM)、Conan、vcpkg
フレームワーク
React、Next.js、Vue、Angular、Express、Fastify、NestJS、Django、Flask、FastAPI、Spring Boot、ASP.NET Core、Ruby on Rails、Gin、Fiber
インフラストラクチャ
Docker、Kubernetes、Terraform、Helm、Ansible、GitHub Actions、AWS CDK、Pulumi
モノレポ対応
Archyl はモノレポ構成を自動的に検出します:
- apps/、packages/、services/、libs/ ディレクトリ
- サービス間で比例配分したファイルサンプリング
- 各サービスは C4 モデル内の個別のコンテナにマッピング
- サービス間のリレーションシップを検出
ベストプラクティス
小さく始める
大規模なコードベースの場合:
- 単一のサービスまたはモジュールから開始
- 結果をレビューし改善
- 他の領域に段階的に拡張
定期的な更新
ドキュメントを最新に保つ:
- 自動更新のためにインクリメンタルディスカバリーを有効化
- 保留中のディスカバリーを定期的にレビュー
- 大規模なリファクタリングの後にフルディスカバリーを実行
手動との組み合わせ
AI ディスカバリーは出発点です:
- 重い作業には AI を使用
- ビジネスコンテキスト(説明、ADR)は手動で追加
- リレーションシップと説明を改善
REST API
POST   /api/v1/discovery/start                            # Start full discovery
GET    /api/v1/discovery/jobs/:jobId                       # Get job status
POST   /api/v1/projects/:id/discovery/incremental          # Trigger incremental discovery
トラブルシューティング
ディスカバリーに時間がかかる
- 分析するファイル数を減らす(設定で最大ファイル数を調整)
- 定期的な更新にはインクリメンタルディスカバリーを使用
- 特定のブランチに絞る
不正確な結果
- 随時レビューして修正 — 保留中の仕組みにより、要素ごとに承認・拒否できます
- 構造化されたコードほど良い結果が得られる
- 承認済みの要素に説明を追加すると、今後のディスカバリーのコンテキストが充実する
分析されたファイルがない
- リポジトリが接続され、ブランチが存在することを確認
- ソースファイルが認識される拡張子(.go、.ts、.py、.java など)を持っていることを確認
- アクセストークンにリポジトリの読み取り権限があることを確認