Disclaimer. Questo articolo si basa interamente sulle comunicazioni pubbliche di Stripe — il loro engineering blog, talk a conferenze, repository open source e case study esterni. Non è un documento di architettura ufficiale Stripe. Modelliamo ciò che sappiamo pubblicamente per illustrare come uno stack complesso possa essere reso leggibile con il modello C4. Quando i dettagli sono inferiti invece che affermati da Stripe, lo diciamo.
Anatomia di un Charge: modellare Stripe in C4 con Archyl
Una richiesta POST colpisce Stripe alle 3 del mattino Pacific durante il Black Friday. Venti secondi dopo il merchant è accreditato, la banca emittente del cardholder ha autorizzato l'addebito, i fondi sono in coda per il settlement, il server del merchant ha ricevuto un webhook firmato, e il motore di rischio Stripe ha valutato la transazione in meno di 100 millisecondi.
Quella singola richiesta, ripetuta 27 395 volte al secondo al picco BFCM 2024, attraversa quattordici sistemi Stripe e almeno quattro reti esterne prima che il frame zero raggiunga la dashboard del merchant.
Nel 2025, Stripe ha processato 1,9 trilioni di dollari attraverso questo stack, sostenendo 99,9999% di uptime durante il Black Friday — sei nove, equivalenti a 32 secondi di downtime in un anno. Lo hanno fatto su circa quindici milioni di righe di Ruby, type-checked dal loro stesso type system fatto in casa.
Come si comprende uno stack che fa girare i pagamenti con carta di mezzo internet? Come Netflix, non si comprende — non in un colpo solo. È esattamente il problema che il modello C4 è stato inventato per risolvere.
In questo post seguiamo una sola azione utente — una chiamata stripe.PaymentIntents.create() — e la guardiamo attraversare l'architettura di Stripe sui quattro livelli C4. Non copriremo ogni prodotto. Tracceremo un charge, scriveremo gli ADR che spiegano le scelte che incontriamo lungo il percorso, e finiremo con una mappa dei team che possiedono ogni scatola.
Livello 1 — System Context: quindici prodotti, un trilione di dollari
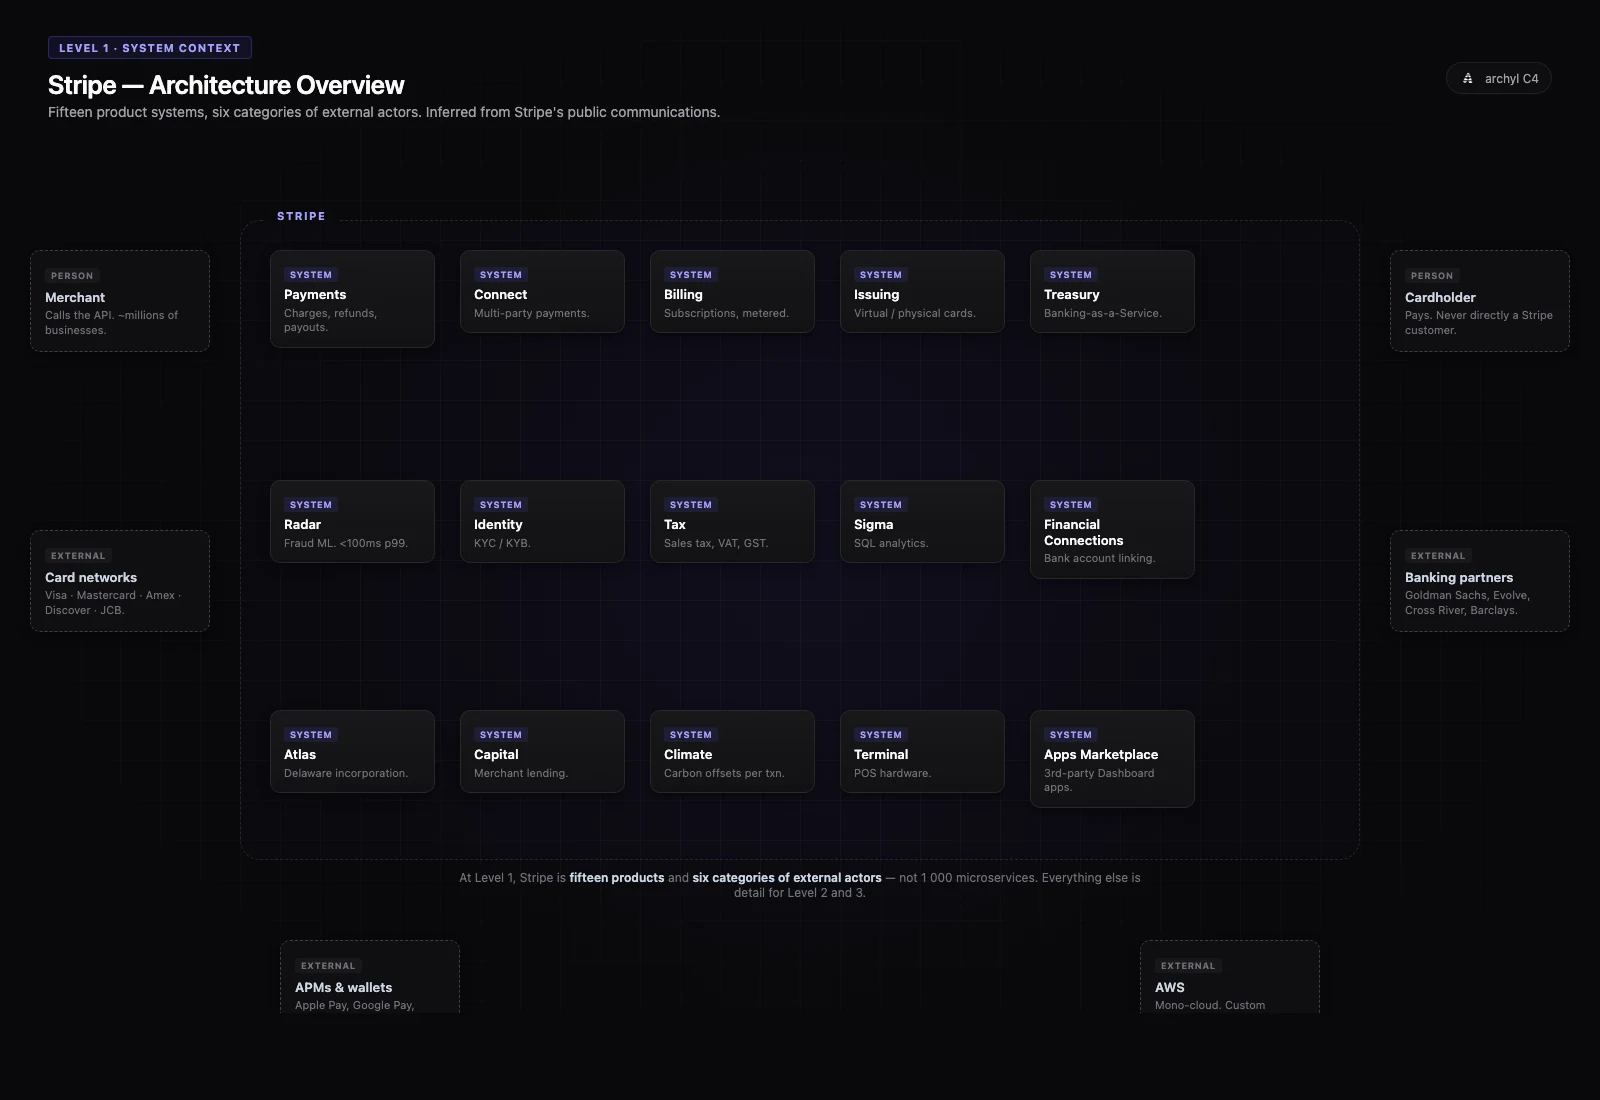
Al livello System Context, Stripe non è "un'API di pagamento". Sono quindici sistemi-prodotto distinti che condividono una fondazione:
- Payments — il cuore storico: charges, payment intents, refunds, payouts
- Connect — pagamenti multi-party, marketplace, piattaforme
- Billing — abbonamenti, fatture, billing a consumo
- Atlas — incorporazione Delaware C-Corp/LLC
- Capital — prestiti ai merchant
- Issuing — creazione di carte virtuali e fisiche
- Treasury — banking-as-a-service (partnership Goldman Sachs)
- Identity — verifica KYC/KYB
- Tax — sales tax, IVA, GST
- Climate — compensazioni di carbonio per transazione
- Radar — rilevazione frodi ML (scoring sub-100ms)
- Sigma — analytics SQL sui dati Stripe
- Terminal — hardware POS
- Financial Connections — linking di conto bancario (il loro Plaid)
- Apps Marketplace — app di terze parti nella Dashboard
Intorno: merchant, cardholder, le quattro reti di carte (Visa, Mastercard, Amex, Discover) più quelle regionali (JCB, UnionPay), 100+ metodi di pagamento alternativi (Apple Pay, Klarna, ACH, SEPA, iDEAL...), banche acquirer ed emittenti, partner bancari (Goldman Sachs, Evolve, Cross River), autorità fiscali, provider di identità, e AWS come cloud sottostante mono-cloud.
Quindici sistemi, otto categorie di attori esterni. Tutto il resto è dettaglio.
Questo è il regalo del Livello 1: nel System Context non hai bisogno di sapere che Payments sono venti microservizi. Devi sapere che esiste, che parla con le card networks, che Connect coordina con Treasury, e che AWS sostiene tutto. Il diagramma è un avviatore di conversazione, non un inventario.
ADR-001 · Idempotency keys integrate nell'API dal giorno 1
Stato · Accepted (2011, ancora attivo nel 2026)
Contesto · Le reti non sono affidabili. Un merchant che ritenta un POST /charges fallito potrebbe addebitare due volte un cliente. La risposta dell'industria nel 2011 era "il merchant dovrebbe gestirlo" — spingendo complessità di sistemi distribuiti a ogni consumatore di API.
Decisione · Richiedere Idempotency-Key su ogni chiamata API mutante. Memorizzare la chiave, l'hash della richiesta, e la risposta. Al retry, replay della risposta memorizzata se la chiave coincide. Spedirlo come parte first-class dell'API, non opt-in.
Conseguenze · Il modello di idempotenza Stripe è diventato lo standard de facto dell'industria. Il draft IETF di Idempotency-Key è direttamente ispirato ad esso. Ogni utente dell'API Stripe, sapendolo o no, beneficia di un contratto che trasforma POST /charges in un'operazione safely retryable. Faremo zoom su come funziona al Livello 3.
Questa è la singola scelta architetturale che più dà forma alla superficie API di Stripe. Senza di essa, il modello C4 dovrebbe esporre la logica di retry su ogni boundary mutante — leakando complessità di sistemi distribuiti a ogni consumatore.
In Archyl, è così che un ADR si guadagna il suo posto: spiega perché la boundary appare come appare.
Livello 2 — Container: zoom in Payments core
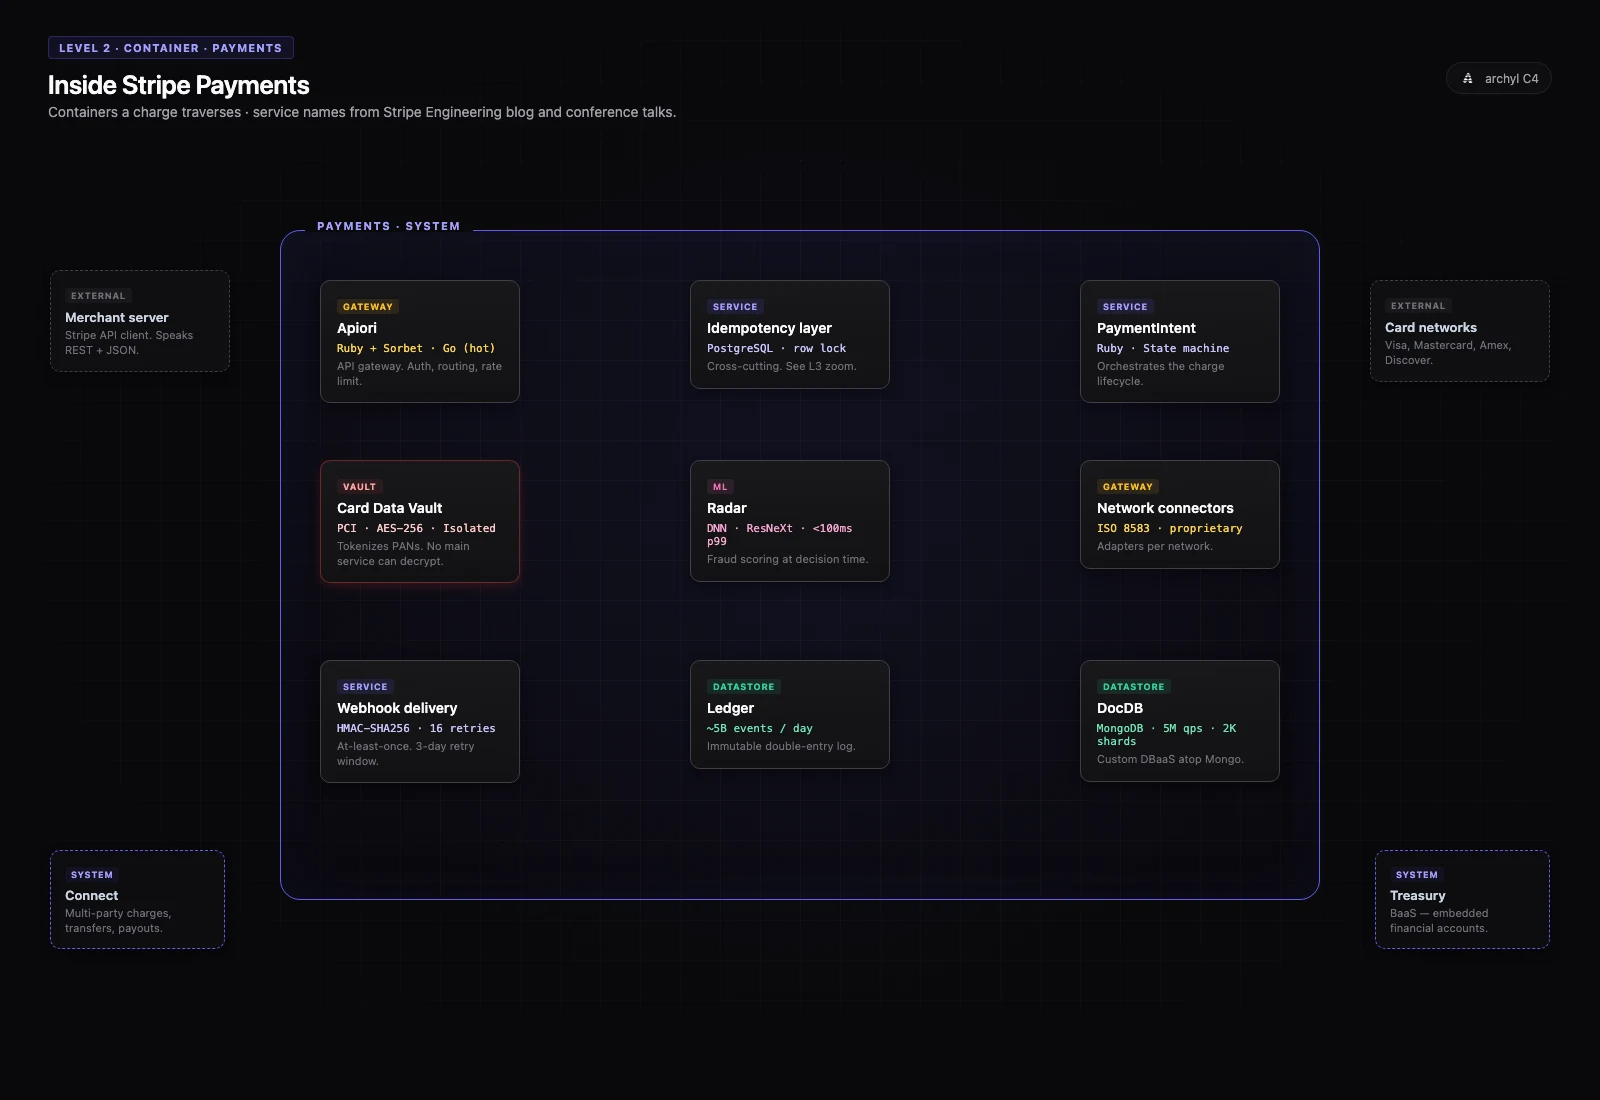
Lo stripe.PaymentIntents.create() del merchant atterra al bordo di Payments. Apriamo la scatola.
Dentro Payments, le fonti pubbliche rivelano almeno questi container:
- Apiori — l'API gateway. Originariamente Ruby + Rails, con il codice di hot-path progressivamente riscritto in Go per latenze sub-150 µs sul layer di auth e routing.
- Idempotency layer — la cross-cutting concern che si siede davanti a ogni endpoint mutante. Backed da PostgreSQL con row-level locking.
- PaymentIntent service — orchestra la state machine:
requires_payment_method→requires_confirmation→requires_action(challenge 3DS) →processing→succeeded(orequires_capture). - Card Data Vault — ambiente PCI fisicamente isolato, AES-256 at rest, nessun servizio principale può decifrare un PAN. Tutta la card data passa per tokenization.
- Radar — scoring di frode in meno di 100 ms p99. DNN puro dal 2022, architettura ispirata a ResNeXt.
- Network connectors — adapter per Visa, Mastercard, Amex, ecc. Parlano ISO 8583 e protocolli proprietari sul wire.
- Webhook delivery service — at-least-once delivery, 16 retry su 3 giorni con exponential backoff, signing HMAC-SHA256.
- Ledger — log eventi immutabile, ~5 miliardi di eventi al giorno, ~100 entries di ledger per pagamento. Source of truth per riconciliazione, audit e contabilità.
- DocDB — Database-as-a-Service custom di Stripe, costruita sopra MongoDB. 5 milioni di query al secondo, 5 000+ collection, 2 000+ shard, petabyte di dati finanziari.
Lo stack tecnologico a questo livello: Ruby con Sorbet types come linguaggio dominante (15M righe), Go sui hot path, PostgreSQL per concern relazionali (idempotenza, account), DocDB per workload document ad alto volume, Apache Kafka per event, Apache Pinot per analytics tempo reale, Apache Flink per stream processing.
Un charge tipico tocca Apiori → Idempotency layer → PaymentIntent service → (Vault per i token) → (Radar per il rischio in parallelo) → Network connector → Ledger → Webhook fanout. Tutto questo, con retry, instrumentato end-to-end via Veneur e instradato safely tramite Smokescreen per ogni egress esterno.
ADR-002 · DocDB — costruire sopra MongoDB invece di riscrivere
Stato · Accepted (~2018, investimento continuo)
Contesto · Nel 2018, il volume dati di Stripe su MongoDB stava stressando il prodotto off-the-shelf: le migrazioni di schema su collection da petabyte erano pericolose, lo sharding era toil operativo, e i requirement di uptime al 99,999% non lasciavano finestre di manutenzione. L'industria avrebbe detto "riscrivere verso uno store relazionale".
Decisione · Non migrare il layer dati a un altro engine. Invece, costruire un Database-as-a-Service custom sopra MongoDB: un Database Proxy, un Chunk Metadata Service, una Data Movement Platform che esegue il pattern dual-write/backfill/dual-read/cleanup come primitiva managed, e un servizio CDC per event in uscita.
Conseguenze · Stripe ottiene il meglio del modello document flessibile di MongoDB più le garanzie operative di una piattaforma managed: 5M QPS, 99,999% di uptime steady-state, migrazioni zero-downtime come operazione di routine. La migrazione "Mongo → DynamoDB" che il rumor di internet a volte sostiene sia avvenuta? Mai avvenuta. Hanno raddoppiato la posta.
Questa ADR è un eccellente esempio di architettura path-dependent: la risposta giusta nel 2018 era estendere, non sostituire.
Livello 3 — Component: dentro la Idempotency layer
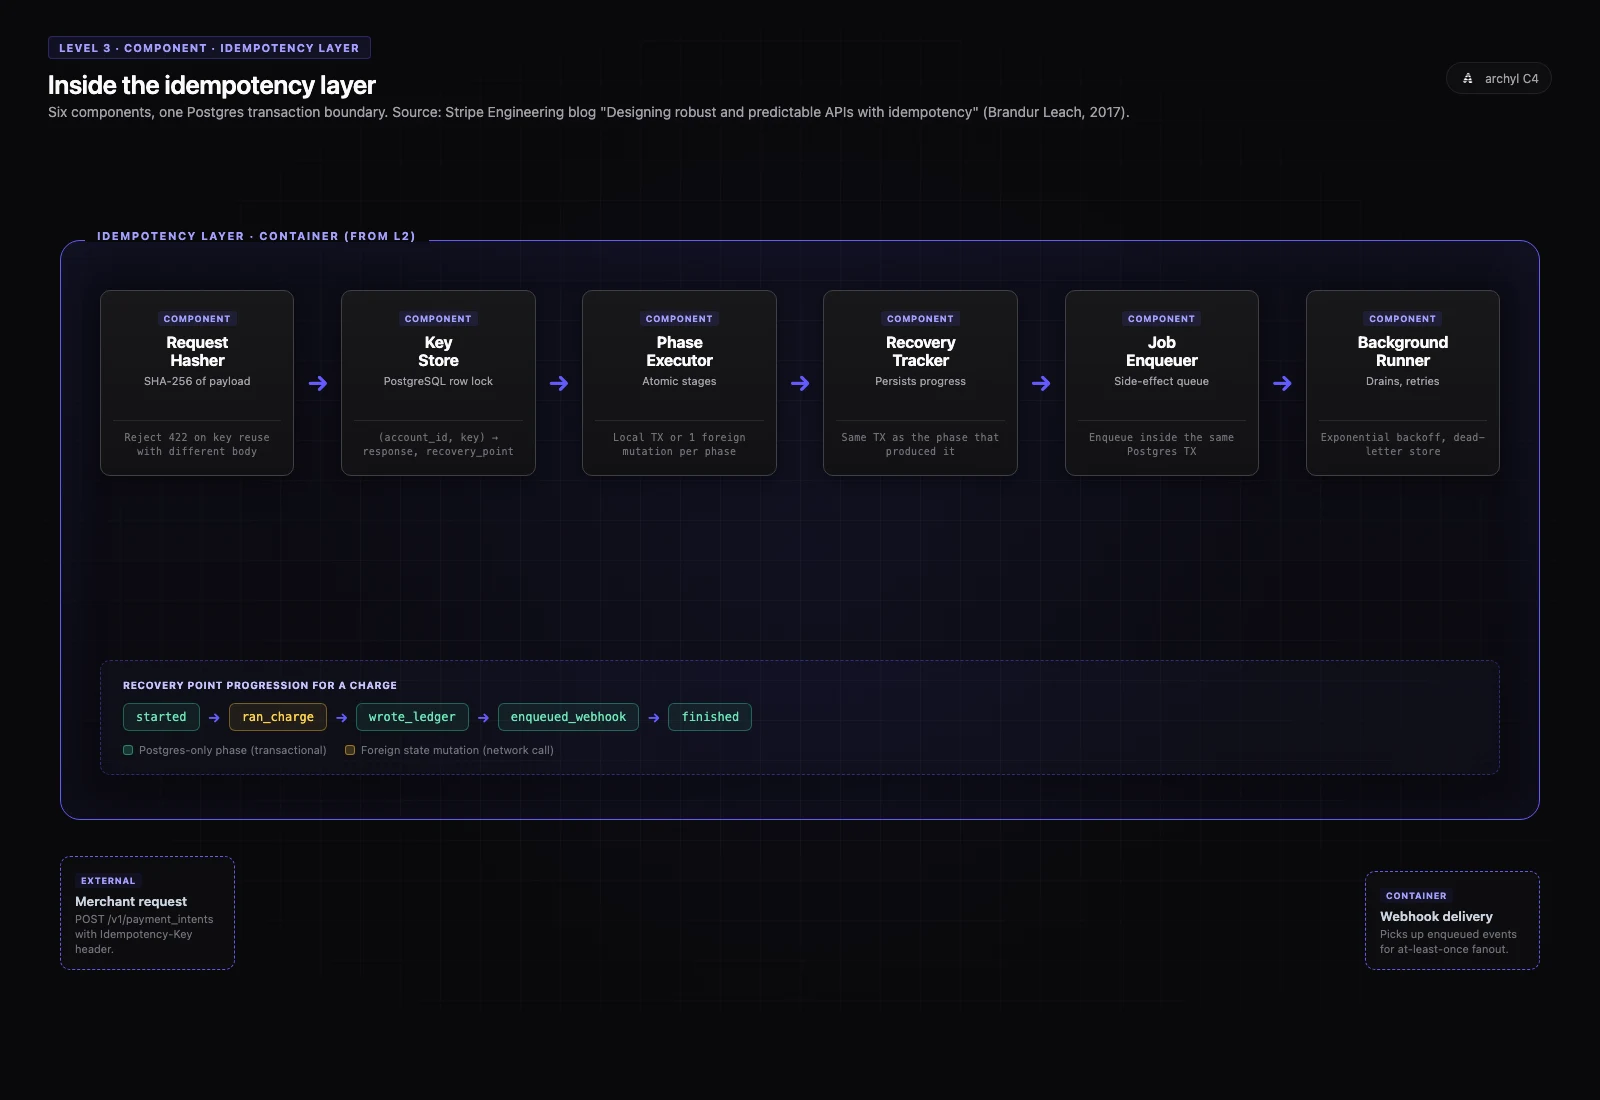
Di tutti i componenti dello stack Stripe, la Idempotency layer è il più pubblicamente documentato — il post di Brandur Leach del 2017 rimane un riferimento canonico per ingegneri di sistemi distribuiti.
Un singolo POST /charges con una idempotency key attraversa questi componenti dentro la layer:
- Request hasher — calcola un hash deterministico del payload della richiesta. Se la stessa idempotency key arriva con un payload diverso, l'API restituisce 422 (il client ha fatto un errore di programmazione).
- Idempotency key store — una tabella PostgreSQL chiave su
(account_id, idempotency_key). Includerequest_hash,response_code,response_body,recovery_point,last_run_at,locked_at. La colonnalocked_atimplementa row-level locking per retry concorrenti. - Phase executor — divide l'operazione in fasi atomiche separate da foreign state mutations. Ogni fase è o puramente locale (Postgres-only, transazionale con la riga di idempotenza) o un singolo side-effect esterno (tokenize Vault, charge rete, invio webhook).
- Recovery point tracker — persiste la fase corrente:
started→ran_charge→wrote_ledger→enqueued_webhook→finished. Al retry, l'executor riprende dal recovery point. - Job enqueuer — per side-effect asincroni (email, webhook), enqueue un job durabile nella stessa transazione Postgres dell'aggiornamento del recovery point. Atomico per costruzione.
- Background runner — drena la coda di job con la sua semantica di retry, exponential backoff, e dead-letter store.
Il pattern è brutalmente semplice una volta che lo vedi: ogni mutazione locale vive nella stessa transazione Postgres dell'aggiornamento della riga di idempotenza; ogni mutazione esterna vive tra due recovery point. Questa forma elimina un'intera classe di bug double-write che affliggono i sistemi distribuiti costruiti senza questa primitiva.
Ecco a cosa assomiglia il C4 a livello Component: non "ecco del codice", ma "ecco la catena di primitivi business-meaningful, ognuno owned, ognuno rimpiazzabile, ognuno misurabile".
ADR-003 · Sorbet — investire in un type checker, non riscrivere Ruby
Stato · Accepted (~2017, open-sourced nel 2019, ancora di default)
Contesto · Nel 2017, il monolite Ruby + Rails di Stripe era cresciuto oltre 10 milioni di righe. Il consiglio dominante dell'industria per una fintech di quella dimensione era riscrivere in un linguaggio tipato — Java, Go, o Scala. Il costo stimato era anni e centinaia di ingegneri. La DX di Ruby, nel frattempo, era il vantaggio competitivo di Stripe per shippare velocemente.
Decisione · Non riscrivere. Costruire un type checker gradual per Ruby. Prendere 18 mesi e un piccolo team per shippare un sistema di tipi multithreaded, IDE-grade, che scala a milioni di righe. Open-source.
Conseguenze · Sorbet ora type-checka 15 milioni di righe di Ruby Stripe con latenza incrementale sub-secondo. Stripe non ha mai pagato la rewrite tax. Hanno pagato la invent-a-type-checker tax — una sola volta. Sorbet è diventato un progetto open source significativo usato da Coinbase, Shopify, GitHub, e altri.
In un modello Archyl, ADR come questa viaggiano con l'architettura. Quando clicchi nel container Apiori nel 2026 e vedi "Ruby + Sorbet", vedi anche la decisione del 2017 che spiega perché non è Java.
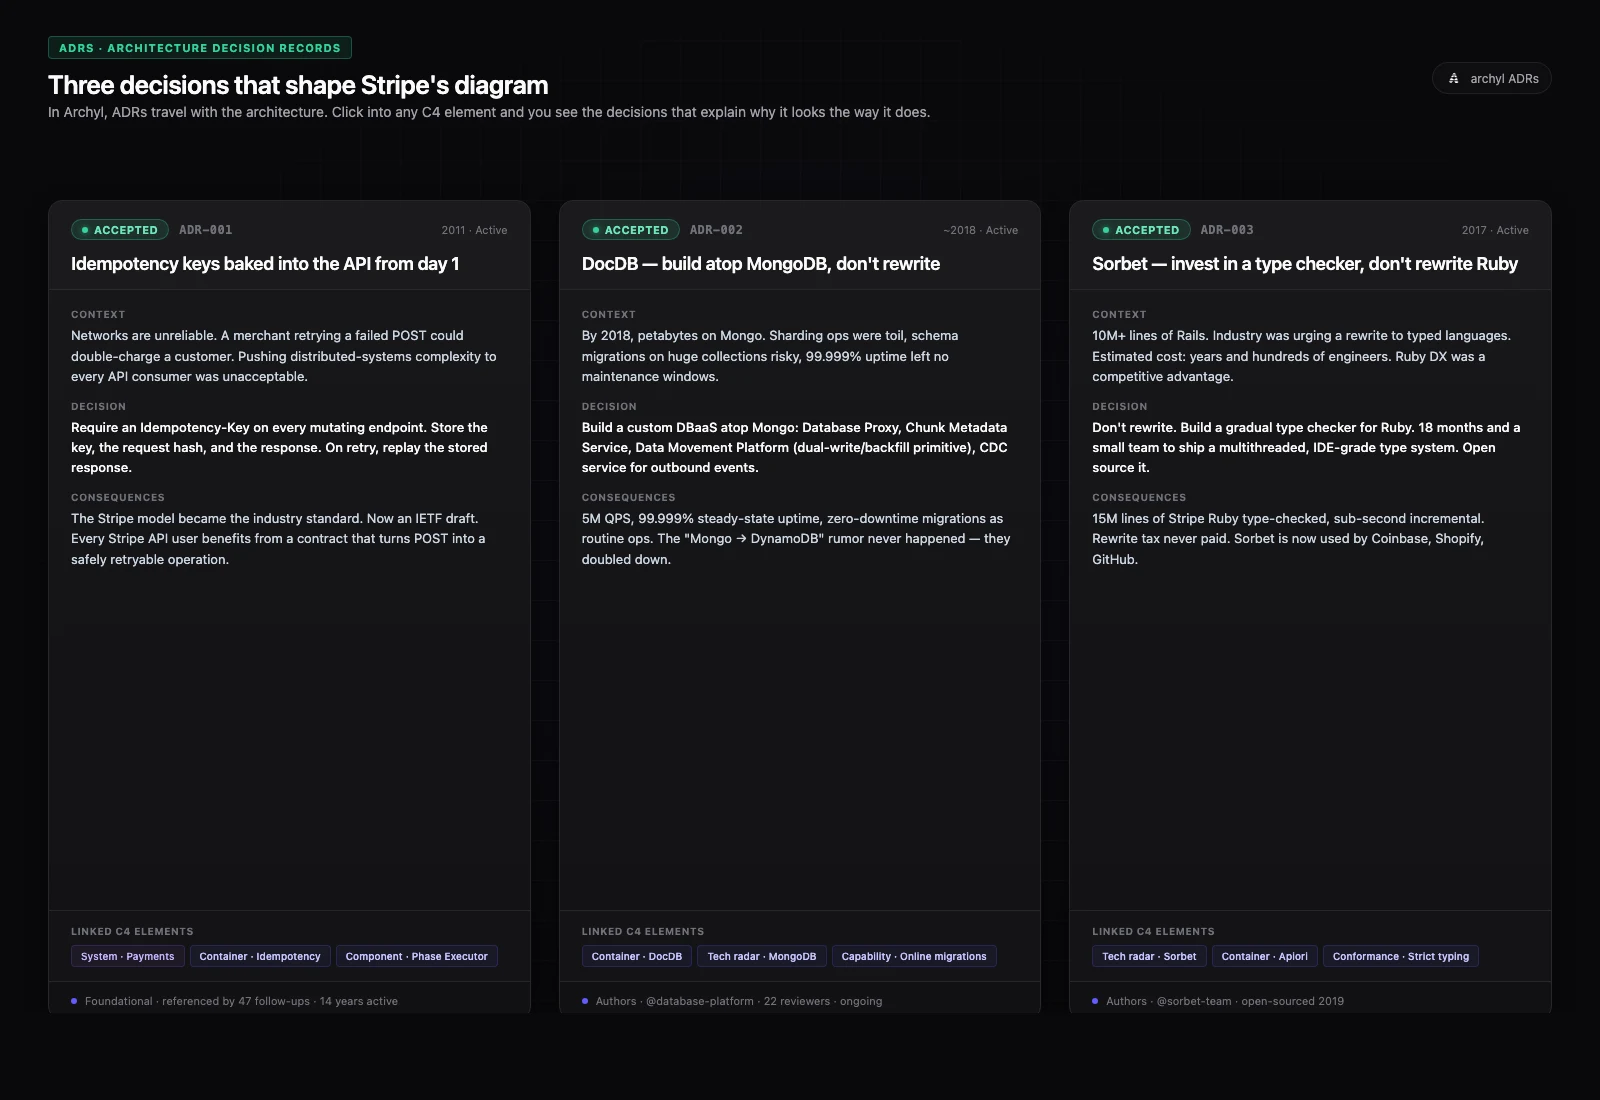
Tre decisioni. Tre card in Archyl, ognuna linkata agli elementi C4 che dà forma — Idempotency keys a ogni endpoint mutante, DocDB al layer dati, Sorbet a ogni container Ruby. Il diagramma è il presente; gli ADR sono il perché.
Ownership: trasformare un modello in accountability
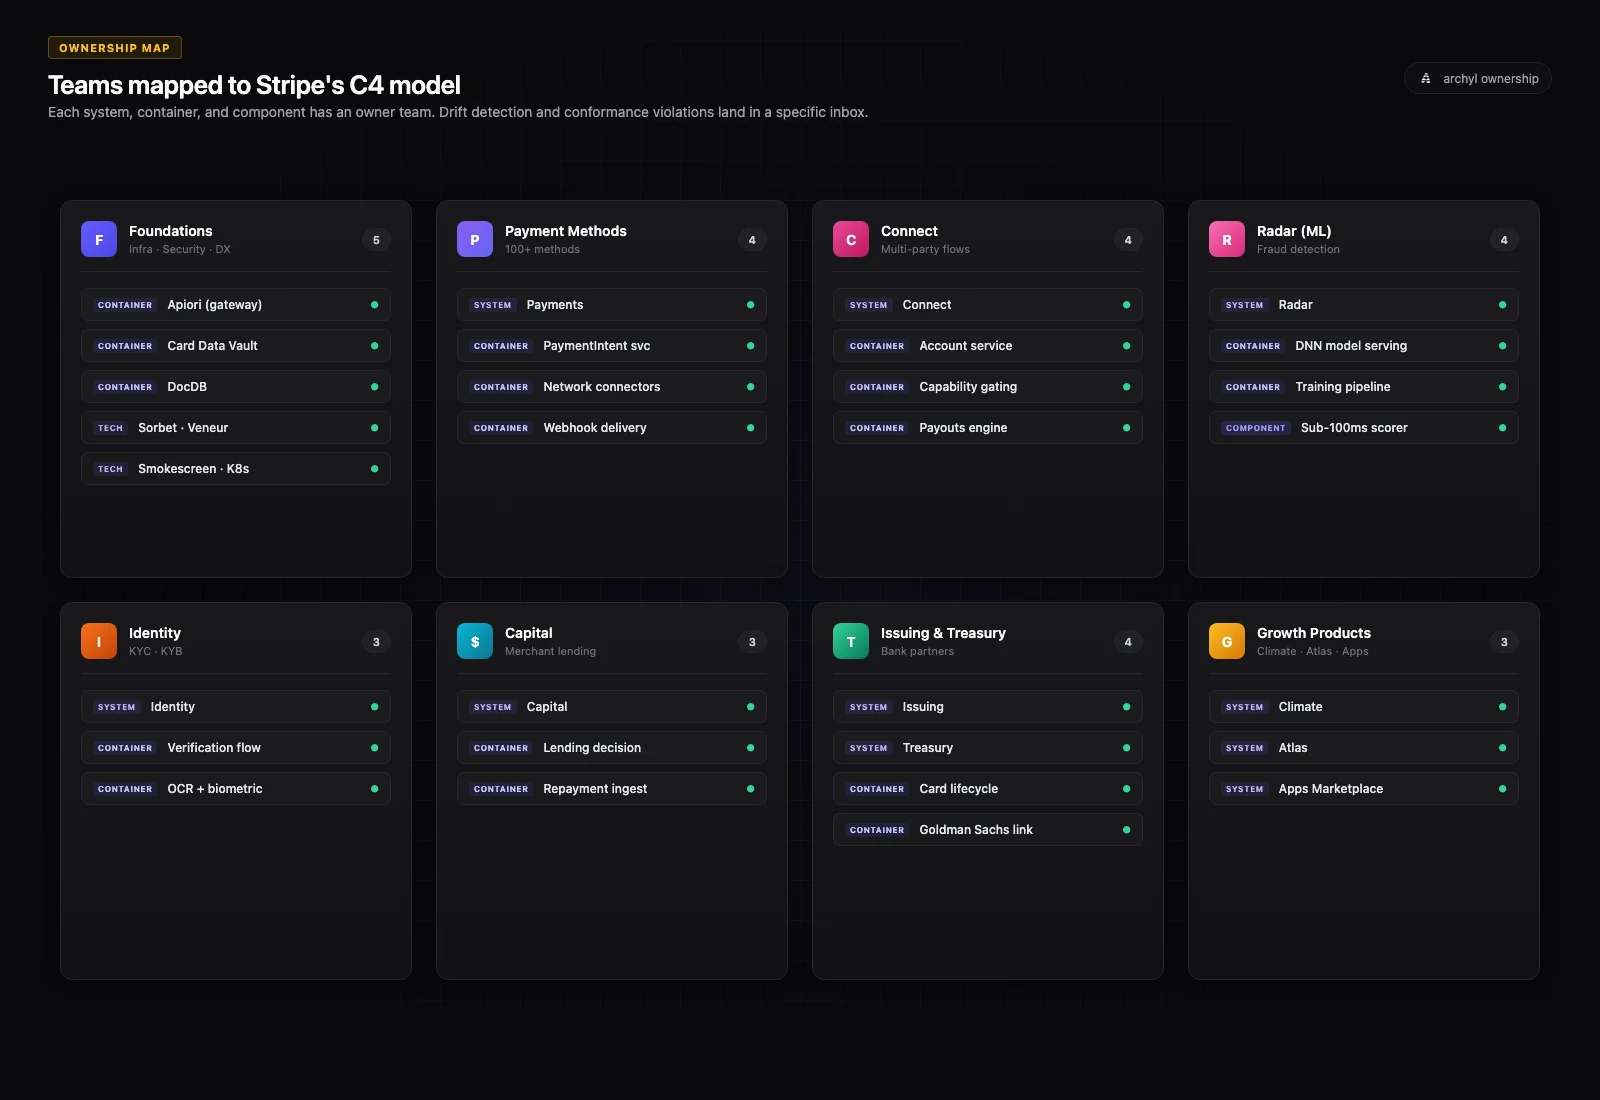
Un modello C4 è un artefatto statico finché non mappi i team su di esso.
Stripe comunica pubblicamente sulla sua struttura engineering: un gruppo Foundations forte (Infrastructure, Security, Data Platform, Developer Experience), team prodotto allineati a ogni sistema maggiore (Payment Methods, Connect, Capital, Identity, Issuing, Treasury, Climate, Radar), e gruppi cross-cutting per ML e observability.
Posiziona questi sul modello C4:
- Foundations possiede Apiori, Sorbet, Veneur, Smokescreen, la piattaforma Kubernetes, DocDB, Card Data Vault — il sostrato su cui ogni prodotto costruisce
- Payment Methods possiede i Network connectors, la state machine PaymentIntent, i servizi per-metodo (carte, ACH, SEPA, wallet)
- Connect possiede il servizio Account, capability gating, flussi multi-party, payout
- Capital possiede la pipeline di decisione di prestito e l'integrazione con la storia Payments del merchant
- Identity possiede i workflow KYC/KYB e il compliance gating per onboarding Connect
- Radar (team ML) possiede il DNN di frode, il model serving, le training pipeline
- Issuing & Treasury possiedono le integrazioni bank-partner e il card lifecycle
- Climate possiede l'integrazione con la marketplace di offsetting di carbonio
Questa mappatura non è decorativa. È il sostrato di tutto ciò che viene dopo.
Una volta che un sistema, container o componente ha un team proprietario, la rilevazione di drift diventa responsabile: quando un nuovo servizio appare nei commit e non è sul diagramma, un team specifico viene interpellato. Quando una regola di conformità viene violata (un servizio non-Foundations che cerca di leggere dal Card Data Vault direttamente, ad esempio), c'è un nome in una inbox.
In Archyl, l'Ownership Map è il momento in cui uno strumento di documentazione diventa uno strumento di governance.
Drift, conformità, e il digest settimanale
Un modello di queste dimensioni andrà in deriva. Nuovi prodotti arrivano — Climate nel 2022, Treasury, espansioni Tax, Apps Marketplace. Gli stack cambiano — path Apiori migrano a Go, Pinot rimpiazza analytics più vecchi, la strictness di Sorbet sale.
Archyl calcola un drift score settimanale: il gap tra il modello C4 documentato e ciò che è attualmente nel codice. Le regole di conformità aggiungono il layer policy — "ogni container ha bisogno di un team proprietario", "solo i servizi Foundations possono leggere Card Data Vault", "ogni cambio di API pubblica deve referenziare un ADR di versioning".
Per Stripe è rilevazione di drift alla scala di quindici milioni di righe e 27 000 richieste al secondo. Le regole sono le stesse che per dieci servizi.
E il Digest di Architettura di Team che abbiamo rilasciato di recente, in un setup tipo Stripe, vorrebbe dire:
- Il digest del lunedì di Foundations copre Apiori, il Vault, DocDB, la piattaforma K8s
- Il digest di Payment Methods copre Network connectors, il PaymentIntent service, ogni integrazione per-metodo
- Il digest di Radar copre il DNN di frode, le training pipeline, i rollout di modello
- Ogni digest scoped al perimetro posseduto dal proprio team
Stessa superficie. Scope diversi. È la simmetria che C4 + ownership sbloccano.
Non hai bisogno di processare un trilione di dollari
Non sei Stripe. La maggior parte delle organizzazioni di engineering non lo sono.
Ma la lezione scala anche verso il basso. La disciplina di separare Context da Container da Component, di scrivere l'ADR che spiega una decisione path-dependent (abbiamo costruito sopra Mongo, abbiamo type-checkato Ruby invece di riscriverlo), di attaccare l'ownership a ogni scatola — quella disciplina è ciò che impedisce a uno stack di cinquanta servizi di sembrare quindici milioni di righe.
C4 + ADR + Ownership + Drift + Conformità è ciò che Archyl ti dà out of the box. L'esempio Stripe è solo il più grande stress-test plausibile del modello nel dominio dei sistemi finanziari.
Apri la tua architettura. Schizza quindici prodotti (o tre, se ne hai tre). Scegli quello con le decisioni passate più sorprendenti e zoomma nei suoi container. Scrivi tre ADR che spiegherebbero a un nuovo cosa lo lascerebbe perplesso. Mappa un team a ogni container.
Sarai avanti rispetto a dove la maggior parte delle organizzazioni di engineering arriva in un anno.
Vuoi modellare la tua architettura in C4? Inizia con Archyl. Leggi anche perché ADR e C4 funzionano meglio insieme o come gli Architecture Change Requests portano il rigore della pull request al tuo modello C4. Il precedente case study modellava Netflix in C4 — Anatomia di un Play.