Avertissement. Cet article est entièrement basé sur les communications publiques d'Uber — leur blog d'ingénierie, conférences, dépôts open source et études de cas externes. Ce n'est pas un document d'architecture officiel d'Uber. Nous modélisons ce que nous savons publiquement pour illustrer comment une stack de quatre mille services peut être rendue lisible avec le modèle C4. Lorsque les détails sont inférés plutôt qu'énoncés par Uber, nous le précisons.
Anatomie d'une course : modéliser Uber en C4 avec Archyl
Un passager appuie sur Demander UberX à 19h23 un vendredi pluvieux à Manhattan. Huit secondes plus tard, un chauffeur à 0,4 mile a accepté la course, un ETA a été calculé et affiché, le tarif est verrouillé, le paiement est pré-autorisé et un canal temps réel basse latence est ouvert entre passager et chauffeur. Le temps qu'il relève les yeux du téléphone, la voiture est déjà en route.
Cet appui unique, répété plus de 30 millions de fois par jour dans 600+ villes, traverse des dizaines de systèmes Uber et trois réseaux externes avant que la première frame n'apparaisse sur l'écran du chauffeur.
En 2024, la stack d'Uber faisait tourner environ 4 000 microservices, servait des pics de bien plus d'un million de requêtes par seconde vers ses clients mobiles, planifiait du compute sur son propre cluster manager, persistait l'état dans sa propre couche de stockage dérivée de MySQL, indexait la planète sur sa propre grille hexagonale, orchestrait des millions de workflows de courses sur son propre moteur de machines à états et entraînait des modèles d'ETA sur sa propre plateforme ML.
Comment comprendre une stack avec autant de pièces mobiles ? Comme Stripe et Netflix, on ne le fait pas — pas d'un seul coup. C'est exactement le problème que le modèle C4 a été inventé pour résoudre.
Dans cet article, nous suivons une seule action utilisateur — une demande de course unique, du tap à l'acceptation chauffeur — et la regardons traverser l'architecture d'Uber sur les quatre niveaux C4. Nous ne couvrirons pas chaque produit ; nous tracerons une course, écrirons les ADRs qui expliquent les choix rencontrés et terminerons par une carte des équipes propriétaires de chaque boîte. En chemin, nous ferons le tour de chaque fonctionnalité Archyl pour rendre ce type de modèle — et les politiques associées — réellement maintenable.
Niveau 1 — Contexte système : trois plateformes, un Marketplace
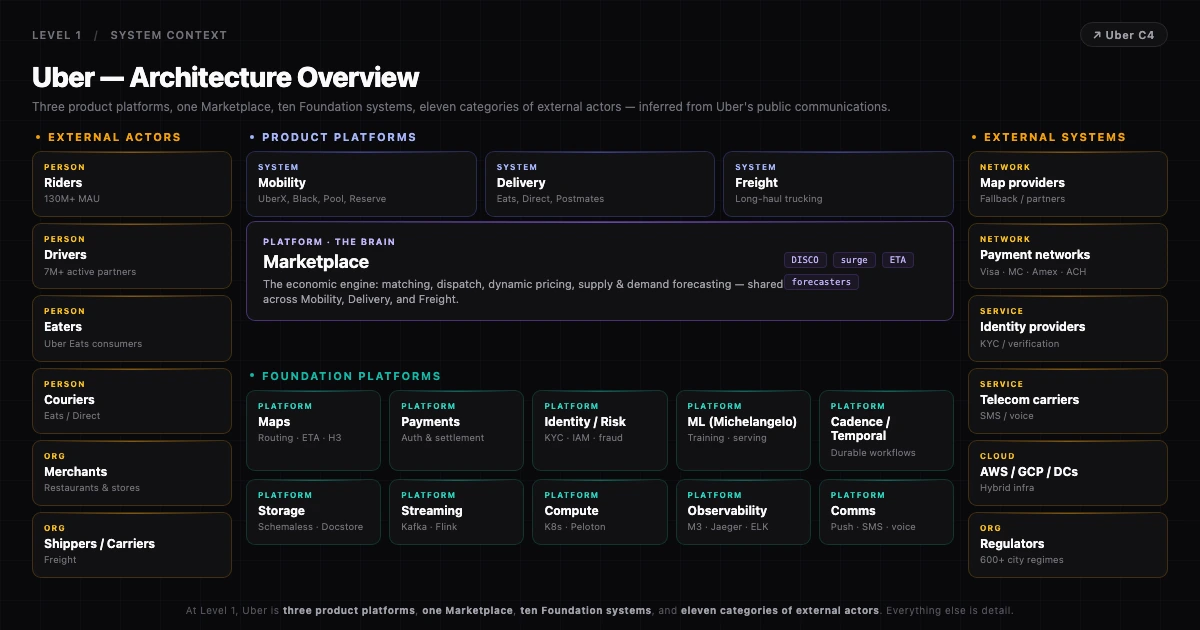
Au niveau Contexte système, Uber n'est pas « une appli VTC ». C'est trois plateformes produit posées sur un Marketplace partagé et une stack de systèmes Foundation transversaux :
- Mobility — UberX, Uber Black, Uber Pool, Uber Reserve, Comfort, SUV, Premier, partenariats taxi
- Delivery — Uber Eats (nourriture), Uber Direct (delivery-as-a-service tiers), Postmates, alcool, courses
- Freight — transport longue distance, Uber Freight Loadbuilder, outils brokers
En dessous, la plateforme Marketplace est le véritable cerveau — le moteur de matching, l'optimiseur de dispatch, le système de pricing dynamique, les forecasters offre/demande. Le Marketplace est ce qui transforme une demande en course.
Sous tout cela siègent les plateformes Foundation : Maps (routing, ETA, matrices distance/durée, trafic), Payments, Identity & Risk, Communications (push, SMS, messagerie in-app), Notifications, la plateforme ML (Michelangelo), le moteur de Workflow (Cadence/Temporal), les plateformes de Storage (Schemaless, Docstore, Cassandra, stores RocksDB), les plateformes Streaming (Kafka, uReplicator, Flink), la stack d'observabilité (M3 metrics, Jaeger tracing, ELK logs) et la plateforme Compute (historiquement Mesos + Aurora → Peloton → Kubernetes aujourd'hui).
Autour, les acteurs externes : passagers, chauffeurs, eaters, coursiers, marchands, shippers et carriers, fournisseurs cartes (les leurs + tiers en fallback), réseaux de paiement et banques acquéreuses, fournisseurs d'identité, opérateurs télécom pour SMS et voix, fournisseurs cloud (Uber tourne en hybride : datacenters propres + AWS/GCP pour des workloads spécifiques) et régulateurs au niveau ville.
Trois plateformes produit. Un Marketplace. Dix plateformes Foundation. Tout le reste, c'est du détail.
C'est le cadeau du Niveau 1 : au Contexte système, vous n'avez pas besoin de savoir que Mobility, c'est deux cents microservices. Vous devez savoir qu'il existe, qu'il parle au Marketplace, que le Marketplace parle à Maps, et que Cadence orchestre le workflow long de la course en dessous. Le diagramme est un point de départ de conversation, pas un inventaire.
Fonctionnalité Archyl en jeu. Un diagramme Contexte système dans Archyl est une vue C4 niveau 1 unique avec auto-layout, navigation click-through dans les conteneurs et overlays qui permettent de masquer/surligner des sous-ensembles (par ex. « ne montrer que les plateformes Foundation »). Les acteurs externes sont des éléments C4 de premier ordre avec leur propre type, donc ils s'affichent distinctement.
ADR-001 · Grille hexagonale H3 pour l'indexation géospatiale
Statut · Accepté (2018, open-sourcé ; toujours actif en 2026)
Contexte · Le moteur de matching du Marketplace doit répondre à « quels chauffeurs sont proches de ce passager ? » en millisecondes, à concurrence ville-entière, tout en supportant des analytics comme zones de surge, ETAs et forecasting d'offre. Les options classiques étaient les pavages rectangulaires (Z-order, geohash, cellules S2 de Google) mais les rectangles ont une faille fondamentale pour ce domaine : chaque rectangle a plus d'une distance voisin — les coins sont plus loin que les arêtes, ce qui produit des approximations de distance inégales et des requêtes « qu'y a-t-il à proximité » asymétriques.
Décision · Pavé la planète en hexagones à la place. Construire une grille hexagonale hiérarchique (H3) avec seize résolutions, du continent jusqu'à ~1 m². Chaque hexagone a six voisins équidistants, rendant les requêtes plus-proche-voisin et ring symétriques et rapides. Open-sourcer la bibliothèque pour que partenaires et ingénieurs Uber partagent la même grille.
Conséquences · H3 est devenu le primitif spatial d'Uber, partagé par Marketplace, Maps, ETA, surge et analytics. Le même H3Index est utilisé dans les hot paths de dispatch et dans les jobs offline de forecasting. C'est aussi un des projets open source les plus réussis d'Uber — utilisé par Foursquare, DoorDash, AT&T et d'innombrables startups géo. Les rares cas où les hexagones ne pavent pas proprement (les 12 ancres pentagonales de l'icosaèdre) sont documentés et évités en production.
Dans Archyl, c'est ainsi qu'un ADR gagne sa place : il explique pourquoi la frontière a cette forme. Cliquez sur n'importe quel conteneur qui touche de l'état géospatial et l'ADR H3 est à un clic.
Fonctionnalité Archyl en jeu. Les ADRs dans Archyl sont des enregistrements de premier ordre liés à des éléments C4 spécifiques. Ils apparaissent comme cartes sur les boîtes pertinentes, sont filtrables par statut (proposé, accepté, déprécié, remplacé) et sont expédiés en YAML dans git pour vivre à côté du code. Quand quelqu'un proposera de remplacer H3 en 2030, l'ADR existant remontera automatiquement en contexte associé.
Niveau 2 — Conteneur : zoom dans le chemin de dispatch du Marketplace
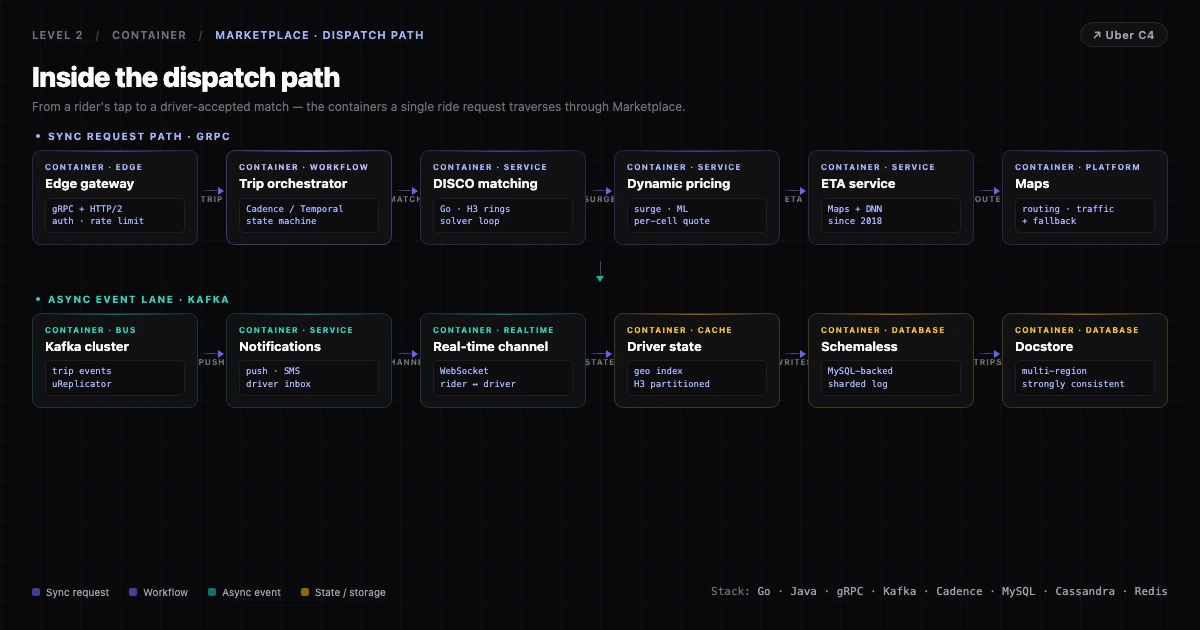
Le tap du passager arrive à l'edge de l'API. Ouvrons la boîte.
Le chemin de dispatch traverse environ les conteneurs suivants :
- Edge gateway — historiquement TChannel + Thrift IDL, aujourd'hui un edge gRPC + HTTP/2 pour les clients mobiles. Auth, rate limiting, mise en forme des requêtes et routing.
- Trip orchestrator — tourne comme un workflow Cadence/Temporal longue durée. La course est une instance de workflow avec transitions d'état déterministes : requested → matched → arriving → on-trip → completed. Retries idempotents et escalades par timer sont des primitives intégrées, pas du code ad hoc.
- Moteur de matching (DISCO) — l'optimiseur marketplace réel. Étant donné une demande passager et l'offre chauffeur live à quelques distances H3, il résout un problème d'assignation contraint à chaque tick.
- Service de pricing dynamique — combine signaux temps réel d'offre/demande pour calculer des multiplicateurs surge par cellule H3. Sort un quote tarif verrouillé au moment de la demande.
- Service ETA — alimente Maps + modèles ML pour route, trafic et prédiction d'arrivée. Les modèles ETA d'Uber sont passés au deep learning vers 2018 et ont été raffinés chaque année depuis.
- Plateforme Maps — moteur de routing in-house d'Uber, service distance-matrix et pipeline d'ingestion trafic. Fallback vers fournisseurs cartes externes pour certains marchés.
- Service Driver state — track l'état courant de chaque chauffeur (offline, online, en course), sa localisation, son comportement d'acceptation. Lectures/écritures sur localisation hot-path via géo-stores custom.
- Schemaless / Docstore — stockage MySQL sharded d'Uber. Schemaless est l'ancien ; Docstore est le successeur multi-région transactionnel. État de course, paiements, profils utilisateurs et la plupart des données de business y vivent.
- Cluster Kafka — chaque transition d'état émet un événement. Le Marketplace s'abonne pour analytics ; les services en aval s'abonnent pour fanout (notifications, fraude, comptabilité).
- Canal temps réel — une fois matché, un canal bidirectionnel basse latence entre les apps passager et chauffeur pour mises à jour de localisation et chat. Soutenu par des passerelles long-poll/WebSocket et Kafka en dessous.
La stack technique à ce niveau : Go pour la plupart des nouveaux services haut débit, Java dans le code marketplace ancien, Python dans les pipelines ML et scripts ops, Node.js sur certaines couches edge, gRPC comme protocole RPC moderne (TChannel/Thrift était le prédécesseur), Cassandra et Redis pour la latence hot-path, MySQL sous Schemaless/Docstore, Hadoop/HDFS/Hive/Presto pour le data warehouse, Spark/Flink pour le compute batch et streaming.
Une demande de course typique touche Edge gateway → Trip orchestrator (Cadence) → Moteur de matching (DISCO avec requêtes ring H3 contre Driver state) → Pricing dynamique → ETA → fanout Notifications (push au chauffeur) → callback driver-accept → canal temps réel établi. Tout ça, avec retries, instrumenté de bout en bout via Jaeger et mesuré via M3.
Fonctionnalité Archyl en jeu. Les diagrammes au niveau Conteneur montrent chaque conteneur, son type (api / service / database / message_queue / cache / worker / gateway / library / infrastructure), ses technologies (issues d'un catalogue technologique par organisation) et ses relations avec labels. Les contrats d'API peuvent être attachés à n'importe quel conteneur et rendus inline — Uber lierait le
.protogRPC pour l'orchestration de course directement au conteneur Trip orchestrator.
ADR-002 · Cadence (Temporal) — construire un moteur de workflow, ne pas empiler des microservices stateful
Statut · Accepté (~2017, open-sourcé comme Cadence ; spin-off Temporal)
Contexte · Vers 2017, Uber avait des centaines de microservices implémentant des processus métier longs et stateful — courses, commandes, flows d'inscription, onboarding chauffeur, revues de fraude. Chacun avait fait pousser sa propre machine à états ad hoc avec timers, retries, idempotence et code de récupération. Résultat : chaque équipe payait la taxe systèmes distribués et les outages venaient souvent de bugs subtils dans la logique retry/timeout.
Décision · Ne pas demander à chaque équipe d'inventer une machine à états. Construire un moteur de workflow générique avec replay déterministe, timers durables, retries automatiques, gestion de signaux et un modèle de programmation où le code workflow se lit comme de la logique métier séquentielle. Open-sourcer comme Cadence. Migrer courses, inscription, revues fraude et workflows de mouvement d'argent dessus sur plusieurs années.
Conséquences · Cadence (et son fork Temporal, désormais utilisé chez Uber et ailleurs) est maintenant le substrat de tout flow stateful longue durée chez Uber. L'abstraction « la course est un workflow » écrase des milliers de lignes de code retry custom en une poignée d'activités bien typées. Le moteur est aussi devenu un des projets de workflow open source les plus adoptés. La leçon path-dependent : quand dix équipes réimplémentent le même primitif indépendamment, construisez le primitif.
Fonctionnalité Archyl en jeu. Les décisions comme Cadence rayonnent à travers le modèle. Dans Archyl, un ADR peut lier plusieurs éléments C4 simultanément — une décision, plusieurs boîtes affectées. Chercher « workflow » à travers le modèle fait remonter chaque conteneur annoté comme consumer Cadence.
Niveau 3 — Composant : à l'intérieur du moteur de matching
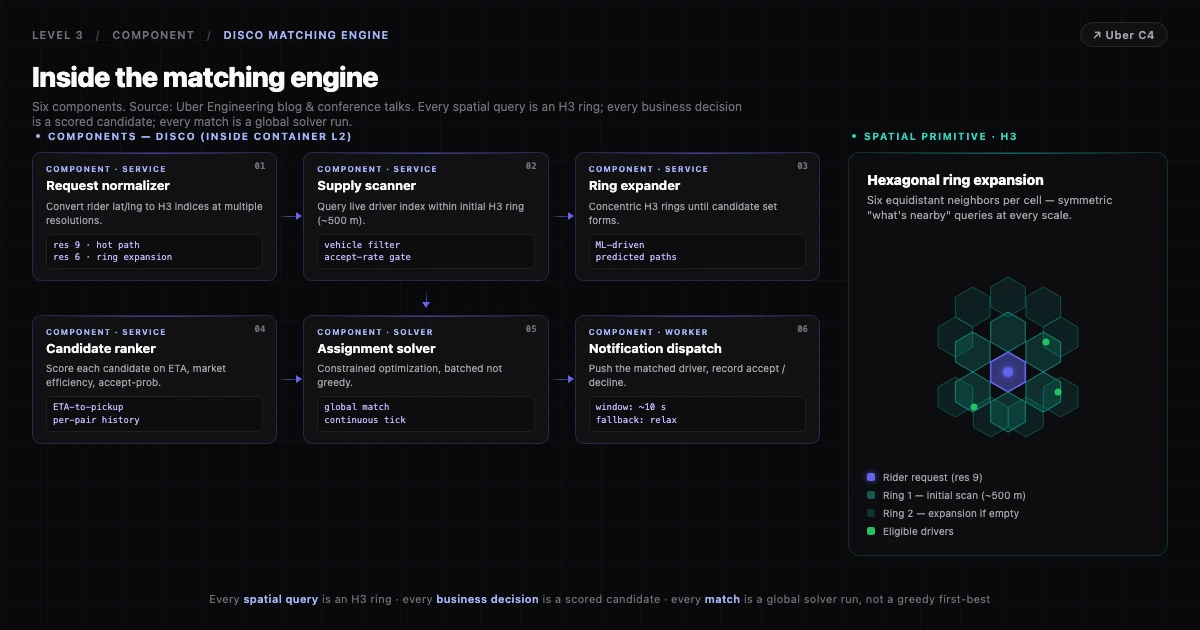
De tous les composants de la stack d'Uber, le moteur de matching — interne DISCO — est le mieux documenté en talks de conférence et posts d'ingénierie.
Une demande de course unique, une fois arrivée au moteur de matching, traverse ces composants :
- Request normalizer — convertit les coordonnées du passager en index H3 à plusieurs résolutions (typiquement res 9 pour hot-path, res 6 pour expansion en ring).
- Supply scanner — interroge l'index live driver-state pour tous les chauffeurs éligibles dans un ring H3 de départ (~500 m). Filtre par type de véhicule, taux d'acceptation chauffeur et comportement de décline récent.
- Ring expander — s'il n'y a pas de chauffeurs éligibles dans le ring intérieur, étendre vers l'extérieur en rings H3 concentriques jusqu'à former un set candidat ou atteindre une borne max-distance. Uber a publié plusieurs itérations de cette stratégie d'expansion, dont une expansion ML-driven qui prédit les trajectoires probables des chauffeurs.
- Candidate ranker — score chaque candidat sur ETA-vers-pickup, efficacité marketplace (veut-on garder ce chauffeur dans ce quartier ?) et probabilité d'acceptation historique pour cette paire passager/chauffeur.
- Assignment solver — formule le problème de matching comme une optimisation contrainte sur le pool d'offre local. Le solver tourne en continu, batchant les demandes proches plutôt que de s'engager sur un greedy first-best-match.
- Notification dispatcher — envoie au candidat matché une push notification avec une fenêtre d'acceptation courte. Enregistre acceptation/refus dans driver-state.
- Chemin de fallback — sur timeout solver ou pas de candidats éligibles, retry avec contraintes assouplies (types de véhicules plus larges, ETA plus long) ou escalade vers surge.
Le pattern est brutalement simple une fois vu : chaque requête spatiale est un ring H3 ; chaque décision métier est un candidat scoré ; chaque match est l'output d'un solver global, pas une décision locale greedy. Cette forme élimine toute une classe d'anti-patterns « le premier chauffeur attrape la course » qui plombent les systèmes de dispatch naïfs.
C'est à quoi ressemble du C4 niveau Composant : pas « voici du code », mais « voici la chaîne de primitives métier signifiantes, chacune possédée, chacune remplaçable, chacune mesurable ».
Fonctionnalité Archyl en jeu. Les diagrammes Composants montrent comment un conteneur est construit. Chaque composant a un type (controller / service / repository / handler / module / job / workflow / activity / entity), un chemin de fichier, des owners et des technologies. Les composants se composent en un User Flow — la fonctionnalité flow d'Archyl vous permet d'auteurer le parcours du passager comme une séquence ordonnée d'invocations de composants et de la rendre comme un diagramme étape par étape.
ADR-003 · Schemaless et Docstore — posséder la couche de stockage plutôt qu'acheter
Statut · Accepté (Schemaless : ~2014 ; Docstore : ~2020 et après)
Contexte · Vers 2014, le volume de courses d'Uber avait dépassé une instance PostgreSQL unique, et les options NoSQL off-the-shelf de l'époque (Cassandra, Couchbase, MongoDB) avaient des bizarreries opérationnelles qu'Uber n'était pas prêt à accepter pour les données de course et de paiement. L'état de course nécessite des écritures multi-région fortement consistantes, latence p99 basse et sharding sans downtime. La réponse de l'industrie en 2014 était « choisissez un NoSQL et vivez avec les compromis ».
Décision · Traiter MySQL comme le bedrock durable et construire dessus. Schemaless wrappe MySQL sharded avec un log append-only sans triggers, du re-sharding automatique et une API document JSON. Des années plus tard, Docstore ajoute un store de documents transactionnel multi-région fortement consistant sur le même substrat MySQL — et devient le défaut pour les nouvelles données produit.
Conséquences · Uber est resté hors du cycle boom-bust « on migre vers NewSQL »/« on revient à Postgres » qui a frappé plusieurs entreprises de taille similaire. La trajectoire est incrémentale : nouveaux workloads → Docstore ; workloads matures restent sur Schemaless jusqu'à migration. Les deux sont opérés par une petite équipe plateforme avec une expertise MySQL profonde. La rumeur qu'Uber serait passé tout-Cassandra ? Ils utilisent Cassandra, mais ce n'a jamais été le système d'enregistrement pour les courses.
Cet ADR est un excellent exemple d'architecture path-dependent : en 2014, la bonne réponse était d'étendre MySQL, pas de migrer ailleurs.
Fonctionnalité Archyl en jeu. La détection de dérive compte le plus ici. Quand un nouveau service commence à écrire dans « Schemaless » mais que le modèle C4 dit toujours « PostgreSQL », Archyl calcule un score de dérive contre la codebase et le signale chaque semaine. Les ADRs préviennent la prochaine dérive : une nouvelle équipe écrivant dans un nouveau datastore devrait déposer un ADR proposant le changement, que l'équipe plateforme peut approuver ou rejeter.
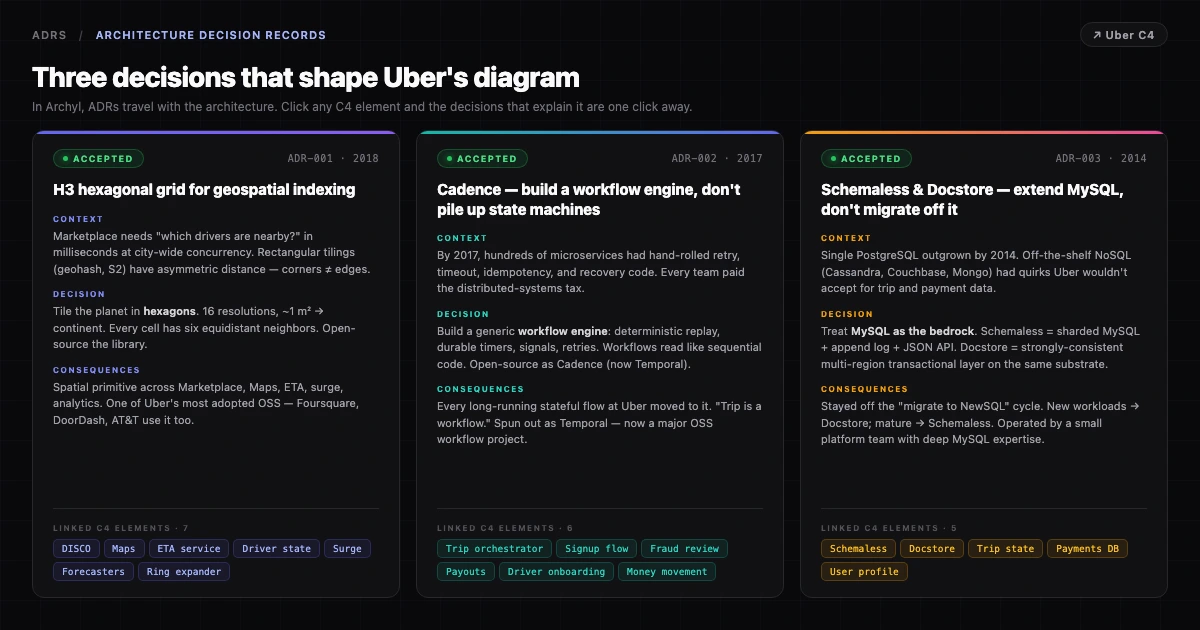
Trois décisions. Trois cartes dans Archyl, chacune liée aux éléments C4 qu'elle façonne — H3 à chaque conteneur spatial, Cadence à chaque workflow longue durée, Schemaless/Docstore à la couche de données. Le diagramme est le présent ; les ADRs sont le pourquoi.
Ownership : transformer un modèle en responsabilité
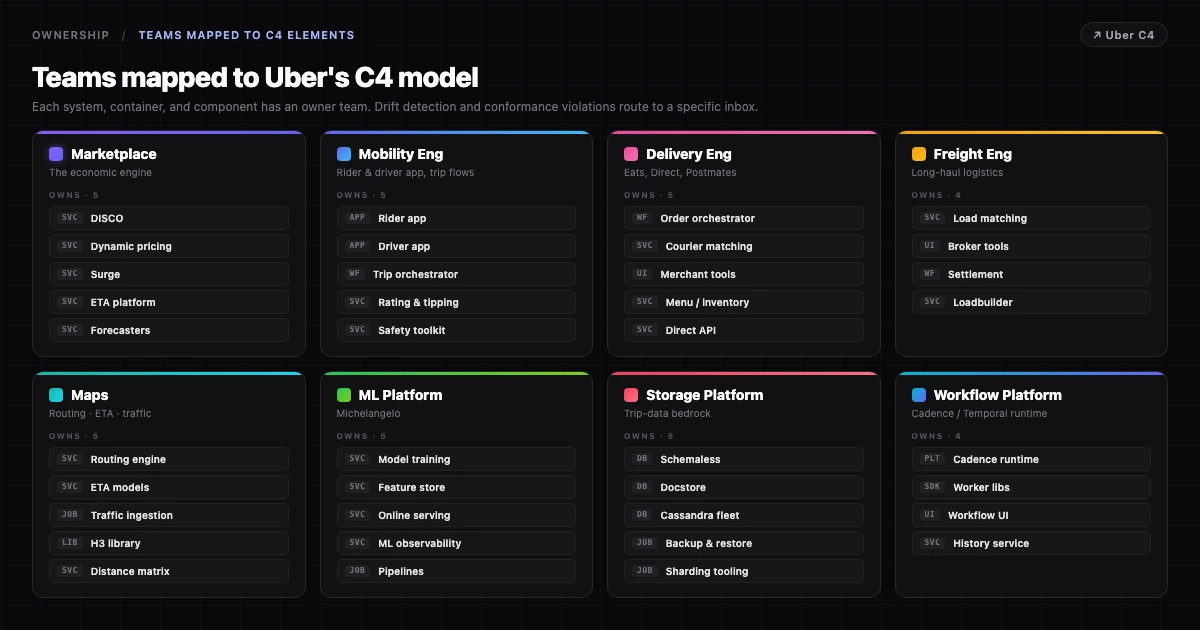
Un modèle C4 est un artefact statique tant que vous n'y mappez pas les équipes. Uber communique publiquement sur sa structure d'ingénierie : de fortes équipes Foundation (Storage, Compute, Networking, Observability, Security, ML Platform, Maps), des orgs produit alignées sur Mobility, Delivery et Freight, et une organisation Marketplace centrale qui possède le moteur économique cross-produit.
Posez-les sur le modèle C4 :
- Marketplace possède DISCO, le service de pricing dynamique, surge, la plateforme ETA et les forecasters demande/offre
- Mobility Engineering possède les apps passager et chauffeur, le trip orchestrator, les flows rating et tip, la suite safety
- Delivery Engineering possède l'orchestration de commandes Eats, le matching coursier (qui réutilise des primitives DISCO), les outils marchand et les plateformes menu/inventaire
- Freight Engineering possède les workflows spécifiques longue distance : matching de chargements, outils brokers, settlement
- Maps possède le routing, les modèles ETA, l'ingestion trafic, la bibliothèque H3
- ML Platform (Michelangelo) possède l'entraînement de modèles, les feature stores, le serving online et la stack d'observabilité ML
- Storage Platform possède Schemaless, Docstore, Cassandra, l'outillage de backup/restore
- Compute Platform possède le cluster manager ère Kubernetes et les descendants d'Aurora/Peloton
- Observability possède M3 (metrics), Jaeger (tracing), le pipeline de logs
- Security & Identity possède Risk, IAM, la plateforme de secrets et les signaux abuse/fraude partagés avec Marketplace
- Cadence/Workflow Platform possède le runtime de workflow durable utilisé par chaque produit
Une fois qu'un système, conteneur ou composant a une équipe propriétaire, la détection de dérive devient redevable. Quand un nouveau service apparaît dans les commits et n'est pas sur le diagramme, une équipe spécifique reçoit la question. Quand une règle de conformité est violée — « seuls les services Marketplace peuvent écrire dans le cache surge » — il y a un nom dans une boîte de réception.
Dans Archyl, l'Ownership Map est le moment où un outil de documentation devient un outil de gouvernance.
Fonctionnalité Archyl en jeu. Chaque élément C4 supporte
owners.teamsetowners.users. La vue Ownership Map consolide la couverture pour que vous voyiez (et corrigiez) les boîtes que personne ne possède. Les gaps de couverture sont inacceptables dans tout système de cette taille — c'est ainsi que l'astreinte escalade vers un canal Slack où personne ne répond.
Dérive, conformité et le problème des quatre mille services
Un modèle avec quatre mille microservices dérivera. Fort. Mobility ship une feature ; un nouveau microservice apparaît ; le contrat de données Marketplace évolue ; un service déprécié de 2019 est enfin retiré. Multipliez par chaque équipe, chaque trimestre.
Archyl calcule un score de dérive chaque semaine : le gap entre le modèle C4 documenté et ce qui est actuellement dans la codebase. Le nombre est borné entre 0 et 100. Un score de 12 pourrait signifier six nouveaux services pas encore dans le modèle, trois relations dans le diagramme pointant vers des endpoints supprimés et une poignée de conteneurs taggés avec des technologies qui ne correspondent plus à la stack réelle.
Les règles de conformité ajoutent la couche policy. Exemples qu'une org Marketplace pourrait écrire :
- Seuls les services Marketplace peuvent lire le cache surge
- Chaque conteneur qui manipule des PII doit porter le tag
pii:trueet référencer un ADR Identity - Toutes les API publiques doivent avoir un contrat OpenAPI ou gRPC attaché — et ce contrat doit être la source de vérité, pas l'implémentation
- Chaque conteneur a besoin d'une équipe propriétaire
- Les mutations d'état de course doivent passer par Cadence ; les écritures DB directes sont interdites
- Les nouveaux datastores nécessitent un ADR et un sign-off Storage Platform
Archyl évalue ces règles en continu. Les violations remontent sur le diagramme, dans le digest hebdomadaire de l'équipe et comme checks au commit si vous wirez le GitHub Action.
Fonctionnalités Archyl en jeu.
- Score de dérive pour le gap entre modèle et code, recalculé à chaque push
- Règles de conformité auteurées en YAML, appliquées à tous les éléments C4
- Architecture Change Requests — review style pull-request pour les changements de modèle proposés, pour que l'architecture suive la même rigueur que le code
- Architecture Insights — anomalies et recommandations remontées par IA depuis les signaux dérive + conformité
Pour une stack de la taille d'Uber, ce n'est pas optionnel. C'est la seule façon de garder le modèle honnête sans une équipe dédiée à la documentation d'architecture.
Contrats d'API, événements et le système nerveux du marketplace
Le Marketplace chez Uber est un graphe de services qui s'échangent des événements à haute vélocité. Transitions d'état de course, mises à jour de localisation chauffeur, recalculs de surge, quotes de tarifs, autorisations de paiement — chaque changement émet un événement Kafka consommé par zéro à beaucoup de services en aval. La plupart des appels synchrones service-à-service sont en gRPC.
Dans Archyl :
- Chaque conteneur peut avoir un contrat d'API attaché (HTTP/OpenAPI, gRPC, GraphQL ou AsyncAPI). La spec est rendue inline ; les consumers voient exactement ce qu'ils appellent.
- Chaque canal async peut être modélisé comme un Event Channel avec broker (Kafka), nom de topic, format de schéma (Avro, Protobuf, JSON Schema) et corps du schéma. Producers et consumers sont liés au canal.
- Les changements breaking apparaissent comme un diff sur le contrat — et si vous avez des règles de conformité exigeant un bump de version, le changement est bloqué jusqu'à satisfaction de la règle.
Pour Uber, ce sont trois mille topics et des dizaines de milliers de contrats devenant inspectables depuis le même endroit que le modèle C4. Plus de « qui consomme mes événements ? » — le modèle sait.
DORA à l'échelle Marketplace
Une fois que vous avez des éléments C4 avec owners, vous pouvez les connecter à la télémétrie de delivery. Le module DORA d'Archyl tire fréquence de déploiement, lead time des changements, taux d'échec des changements et MTTR depuis vos systèmes CI/CD et incidents — et les consolide par élément C4 et par équipe.
Pour le Trip Orchestrator de Mobility, vous verriez la cadence de déploiement et la stabilité de cette équipe séparément de Pricing. Pour Marketplace dans son ensemble, vous verriez comment la MTTR de la plateforme entière évolue. Quand la MTTR pique, drillez dans les conteneurs fautifs ; quand la fréquence de déploiement stagne, vous pouvez l'attribuer à un sous-arbre spécifique.
Fonctionnalité Archyl en jeu. Le dashboard DORA dans Archyl rend les quatre métriques avec breakdown équipe et élément et lignes de tendance, et lie les incidents aux éléments d'architecture qu'ils ont affectés. C'est ainsi que « nous avons de l'observabilité » devient « nous avons de la santé ingénieurie ».
Et puis il y a la couche IA
Une stack de 4 000 services est l'habitat naturel des agents de codage IA — Claude Code, Cursor, Windsurf, et le reste. Chaque ingénieur Uber a le même problème : « comment le service X parle-t-il au service Y, et où le multiplicateur surge est-il réellement persisté ? »
Dans Archyl, le modèle est exposé via un serveur MCP. N'importe quel agent IA sur le laptop d'un ingénieur peut demander :
- « Liste tous les services qui dépendent de la bibliothèque H3 »
- « Montre-moi le contrat d'API pour
dispatch.MatchService» - « Quels ADRs couvrent les décisions de stockage ? »
- « Génère un plan de migration de Cadence vers Temporal SDK v2 sur les services possédés »
L'agent obtient le même contexte architectural qu'un ingénieur. L'onboarding rétrécit. Les revues de code cross-équipe arrêtent d'être « qu'est-ce que ça fait, ça ? ». Le contexte qui vivait dans les têtes vit maintenant dans un modèle interrogeable.
Fonctionnalités Archyl en jeu. Serveur MCP pour agents IA, import/export en YAML archyl, Structurizr DSL, LikeC4, IcePanel JSON et format catalog Backstage — pour que les données d'architecture existantes entrent sans réécriture. Documentation projet, user flows et architecture insights complètent la surface.
La surface de fonctionnalités complète pour une organisation à cette échelle
Si vous êtes une organisation d'ingénierie taille Uber évaluant Archyl, voici la surface, mappée aux parties de votre quotidien où elle gagne sa place :
- Modèle C4 avec les quatre niveaux — Contexte système, Conteneur, Composant, Code — avec auto-layout, overlays et navigation click-through. Le truc que tout outil de diagramming réussit ; nous le réussissons et on continue.
- Découverte d'architecture par IA — pointez Archyl sur un dépôt et il découvre les éléments C4 automatiquement. Vous emmène de zéro au premier modèle en une heure, pas un trimestre.
- Architecture-as-Code —
archyl.yamlchecké dans git, parsé et validé. CI/CD-ready via GitHub Action. Même rigueur que le code. - Import multi-format — Backstage catalog (JSON), Structurizr DSL, LikeC4, IcePanel JSON, plus le YAML natif d'Archyl.
- ADRs liés aux éléments C4 avec cycle de vie complet (proposé / accepté / déprécié / remplacé).
- Documentation projet avec markdown, attachements, liaison à des éléments spécifiques — votre handbook d'architecture vivant.
- Contrats d'API pour HTTP/gRPC/GraphQL/AsyncAPI, rendus inline contre le conteneur producteur.
- Event channels avec broker, topic, schéma, producers et consumers — le côté async de l'architecture.
- Releases & environnements — déploiements versionnés liés à l'architecture, remontés sur le diagramme.
- Ownership Map avec assignations équipes et utilisateurs à chaque niveau.
- Score de dérive entre le modèle et la codebase réelle, recalculé à chaque push.
- Règles de conformité comme policy sur le modèle — auteur, évaluation et application.
- Architecture Change Requests — review style pull-request pour les changements de modèle proposés.
- Architecture Insights — anomalies, risques et recommandations remontés par IA.
- Métriques DORA consolidées par élément et par équipe, avec lignes de tendance et attribution incident.
- Architecture Team Digest — un résumé hebdomadaire par équipe scopé au périmètre possédé.
- Intégration MCP — chaque agent de codage IA de l'équipe partage le même contexte architectural.
- Reviews de PR GitHub — le bot review d'Archyl commente les PR impactant l'architecture avec contexte dérive, conformité et ADR.
- Sharing & embedding — liens publics, liens team-only, iframes embeddables pour les wikis internes.
- Export image/PDF — PNG, SVG et PDF pour présentations, docs formels et slides imprimés.
- Multi-langue — chaque surface Archyl disponible en neuf langues, y compris les docs et les prompts d'agents.
C'est la boîte à outils complète. Pour une stack comme Uber, vous utiliseriez à peu près tout. Pour une stack de cinquante services, vous utiliseriez la moitié qui correspond à votre maturité — et grandiriez vers le reste.
Vous n'avez pas besoin de quatre mille services
Vous n'êtes pas Uber. La plupart des organisations d'ingénierie ne le sont pas.
Mais la leçon descend. La discipline de séparer Contexte de Conteneur de Composant, d'écrire l'ADR qui explique une décision path-dependent (on a construit H3, on a construit Cadence, on a étendu MySQL au lieu de le remplacer), d'attacher de l'ownership à chaque boîte — cette discipline est ce qui empêche une stack de cinquante services de ressembler à quatre mille.
C4 + ADRs + Ownership + Dérive + Conformité + Contrats d'API + DORA + MCP — c'est ce qu'Archyl vous donne out of the box. L'exemple Uber est juste le plus grand stress-test plausible du modèle dans le domaine marketplace-et-logistique.
Ouvrez votre propre architecture. Esquissez dix produits (ou trois, si vous en avez trois). Choisissez celui avec les décisions passées les plus surprenantes et zoomez dans ses conteneurs. Écrivez trois ADRs expliquant ce qui dérouterait un nouvel arrivant. Mappez une équipe à chaque conteneur.
Vous serez en avance par rapport à où la plupart des organisations d'ingénierie arrivent en un an.
Vous voulez modéliser votre propre architecture en C4 ? Démarrez avec Archyl. Lisez plus sur pourquoi ADRs et C4 fonctionnent mieux ensemble ou comment les Architecture Change Requests apportent la rigueur des pull requests à votre modèle C4. Les études de cas précédentes ont modélisé Stripe en C4 — Anatomie d'une charge et Netflix en C4 — Anatomie d'un play.