Avertissement. Cet article s'appuie uniquement sur les communications publiques de Stripe — leur engineering blog, leurs présentations en conférence, leurs dépôts open source et des études de cas externes. Ce n'est pas un document d'architecture officiel Stripe. On modélise ce qu'on sait publiquement pour illustrer comment une stack complexe peut être rendue lisible avec le modèle C4. Quand certains détails sont déduits plutôt qu'affirmés par Stripe, on le précise.
Anatomie d'un Charge : modéliser Stripe en C4 avec Archyl
Une requête POST frappe Stripe à 3h du matin Pacific pendant Black Friday. Vingt secondes plus tard, le marchand est crédité, la banque émettrice du cardholder a autorisé le débit, les fonds sont en queue pour le settlement, le serveur du marchand a reçu un webhook signé, et le moteur de risque Stripe a scoré la transaction en moins de 100 millisecondes.
Cette requête unique, répétée 27 395 fois par seconde au pic du BFCM 2024, traverse quatorze systèmes Stripe et au moins quatre réseaux externes avant que la première frame n'arrive sur le dashboard du marchand.
En 2025, Stripe a traité 1,9 trillion de dollars à travers cette stack, en maintenant 99,9999% d'uptime pendant Black Friday — six neufs, l'équivalent de 32 secondes de downtime par an. Ils l'ont fait sur environ quinze millions de lignes de Ruby, type-checké par leur propre type system maison.
Comment comprend-on une stack qui fait tourner les paiements par carte de la moitié d'internet ? Comme Netflix, on ne la comprend pas — pas d'un coup. C'est exactement le problème que le modèle C4 a été inventé pour résoudre.
Dans ce post, on suit une seule action utilisateur — un appel stripe.PaymentIntents.create() — et on la regarde traverser l'architecture Stripe sur les quatre niveaux C4. On ne couvrira pas chaque produit. On va tracer un charge, écrire les ADRs qui expliquent les choix qu'on rencontre, et finir avec une carte des équipes qui ownent chaque boîte.
Niveau 1 — System Context : quinze produits, un trillion de dollars
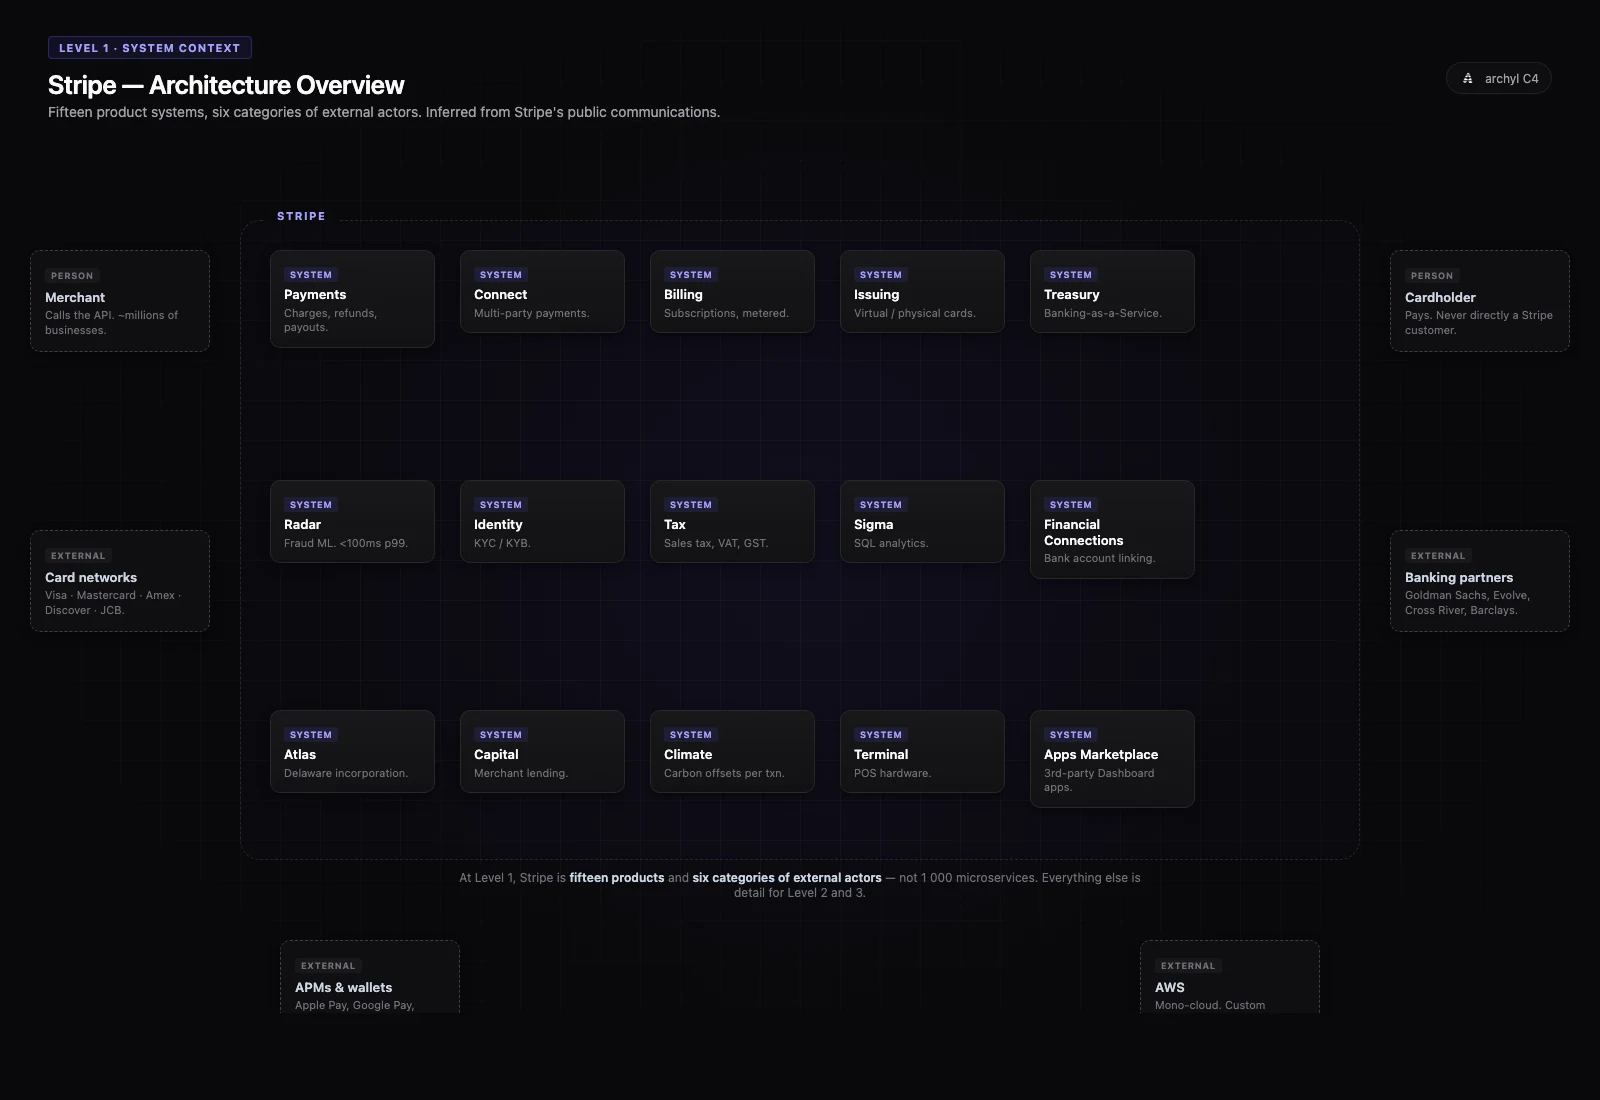
Au niveau System Context, Stripe n'est pas "une API de paiement". C'est quinze systèmes produits distincts qui partagent une fondation :
- Payments — le cœur historique : charges, payment intents, refunds, payouts
- Connect — paiements multi-parties, marketplaces, plateformes
- Billing — souscriptions, factures, billing à la consommation
- Atlas — incorporation Delaware C-Corp/LLC
- Capital — prêts marchands
- Issuing — création de cartes virtuelles et physiques
- Treasury — banking-as-a-service (partenariat Goldman Sachs)
- Identity — vérification KYC/KYB
- Tax — sales tax, TVA, GST
- Climate — compensation carbone par transaction
- Radar — détection de fraude ML (scoring sub-100ms)
- Sigma — analytics SQL sur les données Stripe
- Terminal — hardware POS
- Financial Connections — linking compte bancaire (leur Plaid)
- Apps Marketplace — apps tierces dans le Dashboard
Autour : marchands, cardholders, les quatre réseaux de cartes (Visa, Mastercard, Amex, Discover) plus les régionaux (JCB, UnionPay), 100+ méthodes de paiement alternatives (Apple Pay, Klarna, ACH, SEPA, iDEAL...), banques acquéreuses et émettrices, partenaires bancaires (Goldman Sachs, Evolve, Cross River), autorités fiscales, providers d'identité, et AWS comme cloud sous-jacent mono-cloud.
Quinze systèmes, huit catégories d'acteurs externes. Tout le reste, c'est du détail.
C'est le cadeau du Niveau 1 : au System Context, on n'a pas besoin de savoir que Payments est vingt microservices. On retient qu'il existe, qu'il parle aux card networks, que Connect coordonne avec Treasury, et qu'AWS supporte tout. Le diagramme est un démarreur de conversation, pas un inventaire.
ADR-001 · Idempotency keys intégrées dans l'API dès le jour 1
Statut · Accepted (2011, toujours actif en 2026)
Contexte · Les réseaux ne sont pas fiables. Un marchand qui retry un POST /charges raté pourrait double-charger un client. La réponse de l'industrie en 2011 : "c'est au marchand de gérer ça" — pousser la complexité distribuée à chaque consommateur d'API.
Décision · Imposer une Idempotency-Key sur chaque appel API mutant. Stocker la clé, le hash de la requête, et la réponse. En cas de retry, rejouer la réponse stockée si la clé matche. La shipper comme partie intégrante de l'API, pas un opt-in.
Conséquences · Le modèle d'idempotence Stripe est devenu le standard de fait de l'industrie. Le draft IETF Idempotency-Key s'en inspire directement. Chaque utilisateur de l'API Stripe, sciemment ou non, bénéficie d'un contrat qui transforme POST /charges en opération safely retryable. On zoomera dessus au Niveau 3.
C'est le choix architectural unique qui façonne le plus la surface API de Stripe. Sans lui, le modèle C4 devrait exposer la logique de retry sur chaque boundary mutante — leakant la complexité distribuée à chaque consommateur.
Dans Archyl, c'est comme ça qu'une ADR gagne sa place : elle explique pourquoi la boundary a la forme qu'elle a.
Niveau 2 — Container : zoom sur Payments core
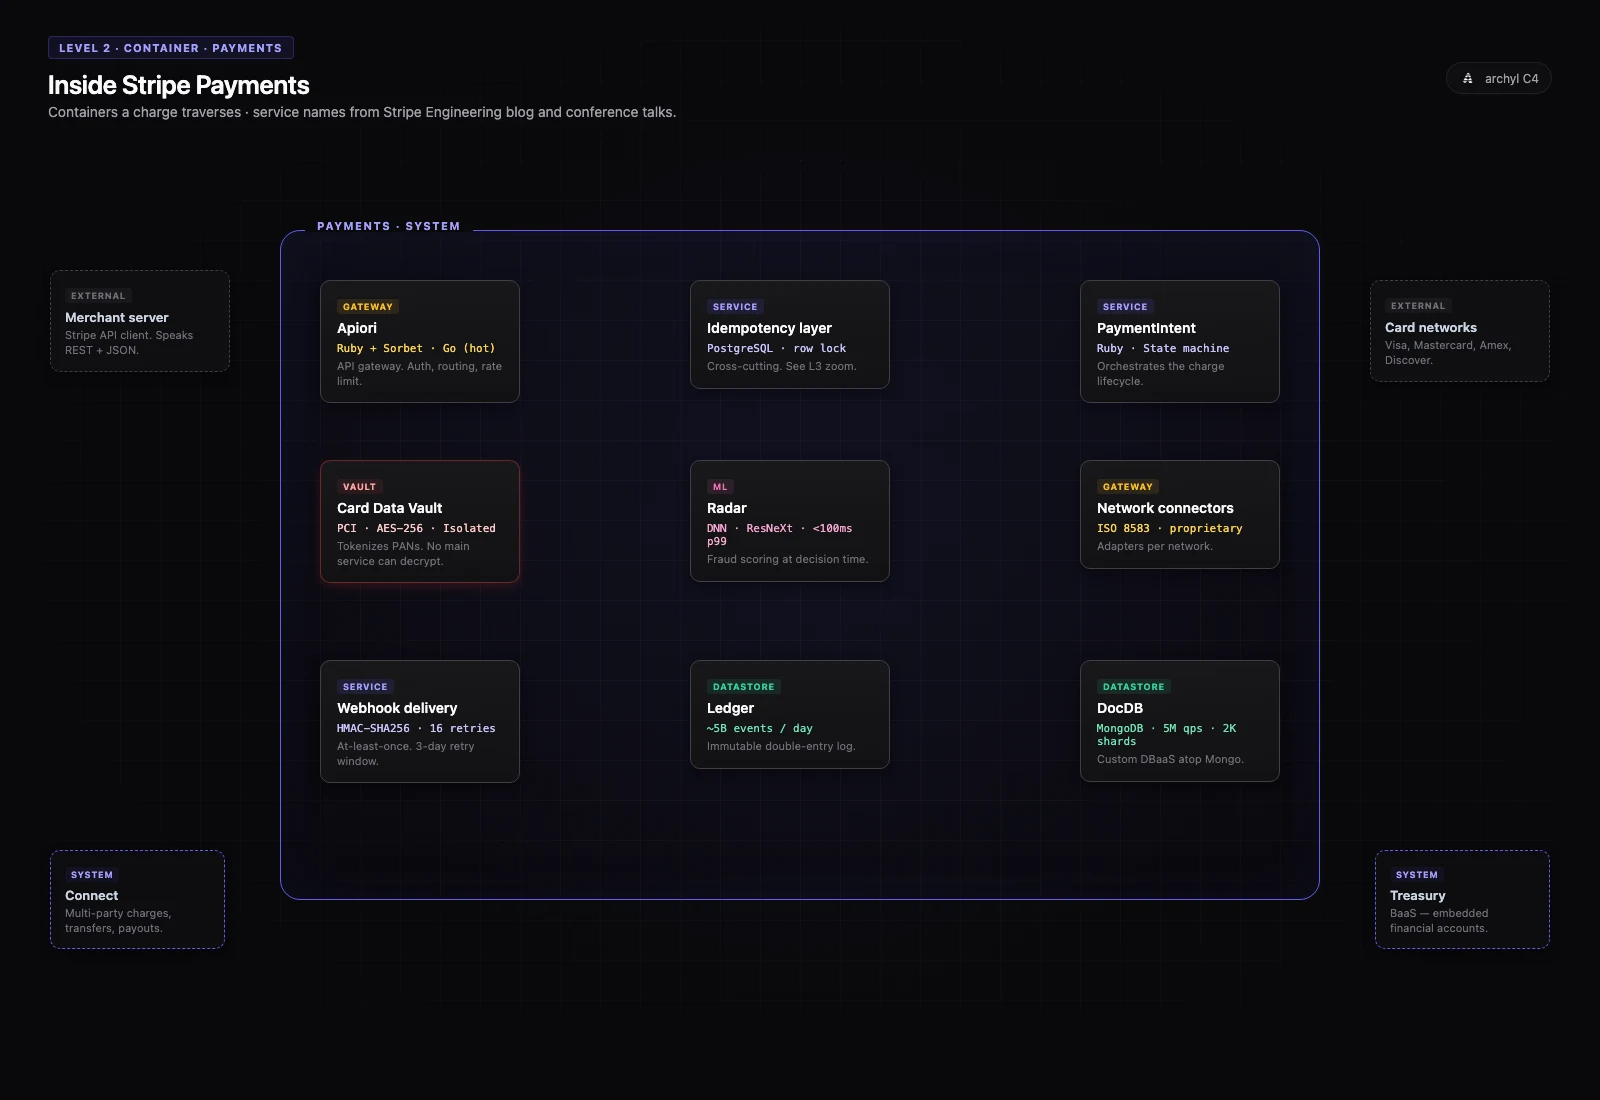
Le stripe.PaymentIntents.create() du marchand atterrit à la frontière de Payments. Ouvrons la boîte.
À l'intérieur de Payments, les sources publiques révèlent au moins ces containers :
- Apiori — l'API gateway. Initialement Ruby + Rails, avec les chemins critiques progressivement réécrits en Go pour atteindre des latences sub-150 µs sur l'auth et le routing.
- Idempotency layer — la cross-cutting concern qui s'intercale devant chaque endpoint mutant. Backed par PostgreSQL avec row-level locking.
- PaymentIntent service — orchestre la state machine :
requires_payment_method→requires_confirmation→requires_action(challenge 3DS) →processing→succeeded(ourequires_capture). - Card Data Vault — environnement PCI physiquement isolé, AES-256 at rest, aucun service principal ne peut décrypter un PAN. Toutes les card data passent par tokenization.
- Radar — scoring de fraude en moins de 100 ms p99. DNN pure depuis 2022, architecture inspirée ResNeXt.
- Network connectors — adapters par network (Visa, Mastercard, Amex...). Parlent ISO 8583 et protocoles propriétaires sur le wire.
- Webhook delivery service — at-least-once delivery, 16 retries sur 3 jours avec exponential backoff, signing HMAC-SHA256.
- Ledger — log d'événements immuable, ~5 milliards d'événements par jour, ~100 entries ledger par paiement. Source of truth pour la réconciliation, l'audit et la comptabilité.
- DocDB — Database-as-a-Service custom de Stripe, construite sur MongoDB. 5 millions de queries par seconde, 5 000+ collections, 2 000+ shards, pétaoctets de données financières.
La stack technologique à ce niveau : Ruby avec Sorbet types comme langage dominant (15M lignes), Go sur les hot paths, PostgreSQL pour les concerns relationnels (idempotence, accounts), DocDB pour les workloads document à fort volume, Apache Kafka pour les events, Apache Pinot pour l'analytics temps réel, Apache Flink pour le stream processing.
Un charge typique touche Apiori → Idempotency layer → PaymentIntent service → (Vault pour les tokens) → (Radar pour le risque en parallèle) → Network connector → Ledger → Webhook fanout. Tout ça, avec retries, instrumenté end-to-end via Veneur et routé safely à travers Smokescreen pour tout egress externe.
ADR-002 · DocDB — construire au-dessus de MongoDB plutôt que réécrire
Statut · Accepted (~2018, investissement continu)
Contexte · En 2018, le volume de données Stripe sur MongoDB tendait le produit off-the-shelf : les migrations de schéma sur des collections de pétaoctets étaient dangereuses, le sharding était de la toil opérationnelle, et les exigences d'uptime à 99,999% ne laissaient aucune fenêtre de maintenance. L'industrie aurait dit "réécrivez vers un store relationnel".
Décision · Ne pas migrer la couche data vers un autre engine. À la place, construire une Database-as-a-Service custom par-dessus MongoDB : un Database Proxy, un Chunk Metadata Service, une Data Movement Platform qui exécute le pattern dual-write/backfill/dual-read/cleanup comme primitive managée, et un service CDC pour les events sortants.
Conséquences · Stripe obtient le meilleur du modèle document flexible de MongoDB plus les garanties opérationnelles d'une plateforme managée : 5M QPS, 99,999% d'uptime steady-state, migrations zero-downtime comme opération routinière. La migration "Mongo → DynamoDB" que la rumeur internet prétend parfois avoir eu lieu ? N'a jamais eu lieu. Ils ont doublé la mise au lieu.
Cette ADR est un excellent exemple d'architecture path-dependent : la bonne réponse en 2018 était d'étendre, pas de remplacer.
Niveau 3 — Component : à l'intérieur de la couche d'idempotence
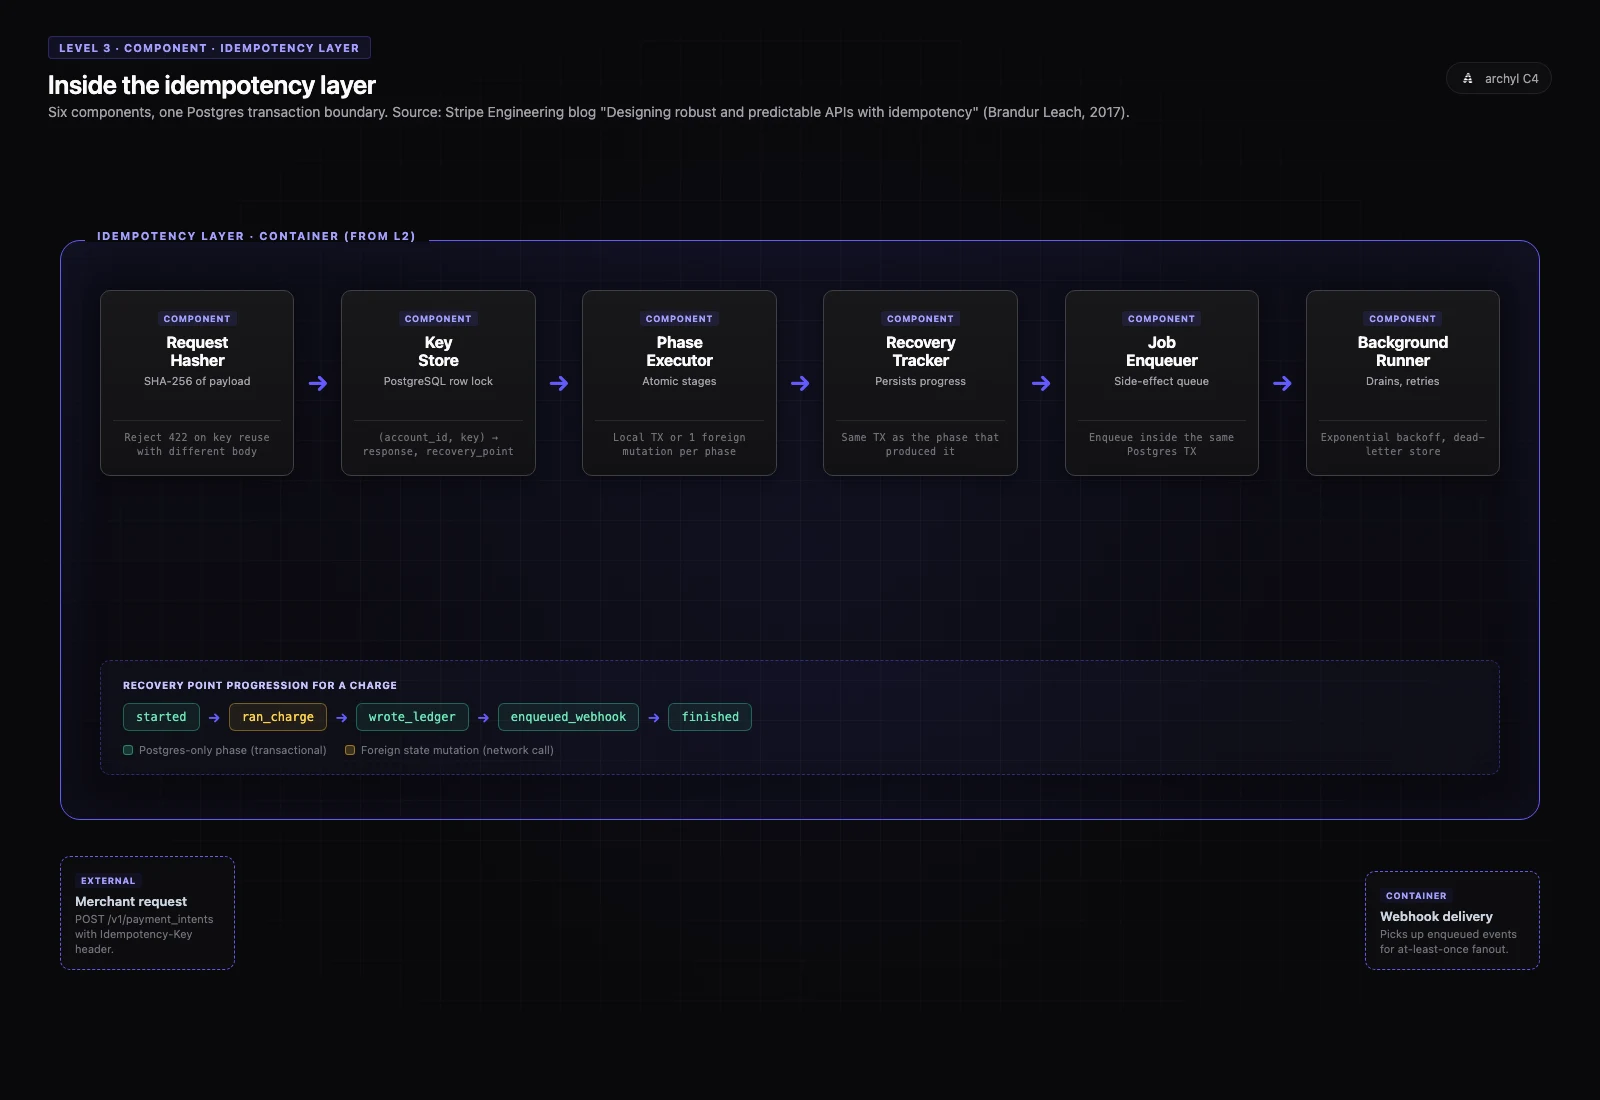
De tous les composants de la stack Stripe, la Idempotency layer est le plus publiquement documenté — le post de Brandur Leach de 2017 reste une référence canonique pour les ingénieurs de systèmes distribués.
Un seul POST /charges avec une idempotency key traverse ces composants à l'intérieur de la couche :
- Request hasher — calcule un hash déterministe du payload de la requête. Si la même idempotency key arrive avec un payload différent, l'API renvoie 422 (le client a fait une erreur de programmation).
- Idempotency key store — une table PostgreSQL clée sur
(account_id, idempotency_key). Inclutrequest_hash,response_code,response_body,recovery_point,last_run_at,locked_at. La colonnelocked_atimplémente du row-level locking pour les retries concurrents. - Phase executor — découpe l'opération en phases atomiques séparées par des foreign state mutations. Chaque phase est soit purement locale (Postgres-only, transactionnelle avec la row d'idempotence), soit un seul side-effect externe (tokenize Vault, charge réseau, envoi webhook).
- Recovery point tracker — persiste la phase courante :
started→ran_charge→wrote_ledger→enqueued_webhook→finished. En cas de retry, l'executor reprend au recovery point. - Job enqueuer — pour les side-effects asynchrones (emails, webhooks), enqueue un job durable dans la même transaction Postgres que l'update de recovery point. Atomique par construction.
- Background runner — draine la queue de jobs avec sa propre sémantique de retry, exponential backoff, et dead-letter store.
Le pattern est brutalement simple une fois qu'on le voit : toute mutation locale vit dans la même transaction Postgres que l'update de la row d'idempotence ; toute mutation externe vit entre deux recovery points. Cette forme élimine une classe entière de bugs de double-write qui plagent les systèmes distribués construits sans cette primitive.
Voilà à quoi ressemble du Niveau 3 C4 : pas « voici du code », mais « voici la chaîne de primitives métier-significatives, chacune ownée, chacune remplaçable, chacune mesurable ».
ADR-003 · Sorbet — investir dans un type checker, ne pas réécrire Ruby
Statut · Accepted (~2017, open-sourcé en 2019, toujours par défaut)
Contexte · En 2017, le monolithe Ruby + Rails de Stripe avait dépassé les 10 millions de lignes. Le conseil dominant de l'industrie pour une fintech de cette taille était de réécrire dans un langage typé — Java, Go, ou Scala. Le coût d'une telle réécriture était estimé en années et centaines d'ingénieurs. La DX Ruby, pendant ce temps, était l'avantage compétitif de Stripe pour shipper vite.
Décision · Ne pas réécrire. Construire un type checker gradual pour Ruby. Prendre 18 mois et une petite équipe pour shipper un type system multithreadé, IDE-grade, qui scale à des millions de lignes. L'open-sourcer.
Conséquences · Sorbet type-checke maintenant 15 millions de lignes de Ruby Stripe avec une latence incrémentale sub-seconde. Stripe n'a jamais payé la rewrite tax. Ils ont payé la invent-a-type-checker tax — une seule fois. Sorbet est devenu un projet open-source significatif utilisé par Coinbase, Shopify, GitHub, et d'autres.
Dans un modèle Archyl, des ADRs comme celle-ci voyagent avec l'architecture. Quand vous cliquez dans le container Apiori en 2026 et voyez "Ruby + Sorbet", vous voyez aussi la décision de 2017 qui explique pourquoi ce n'est pas Java.
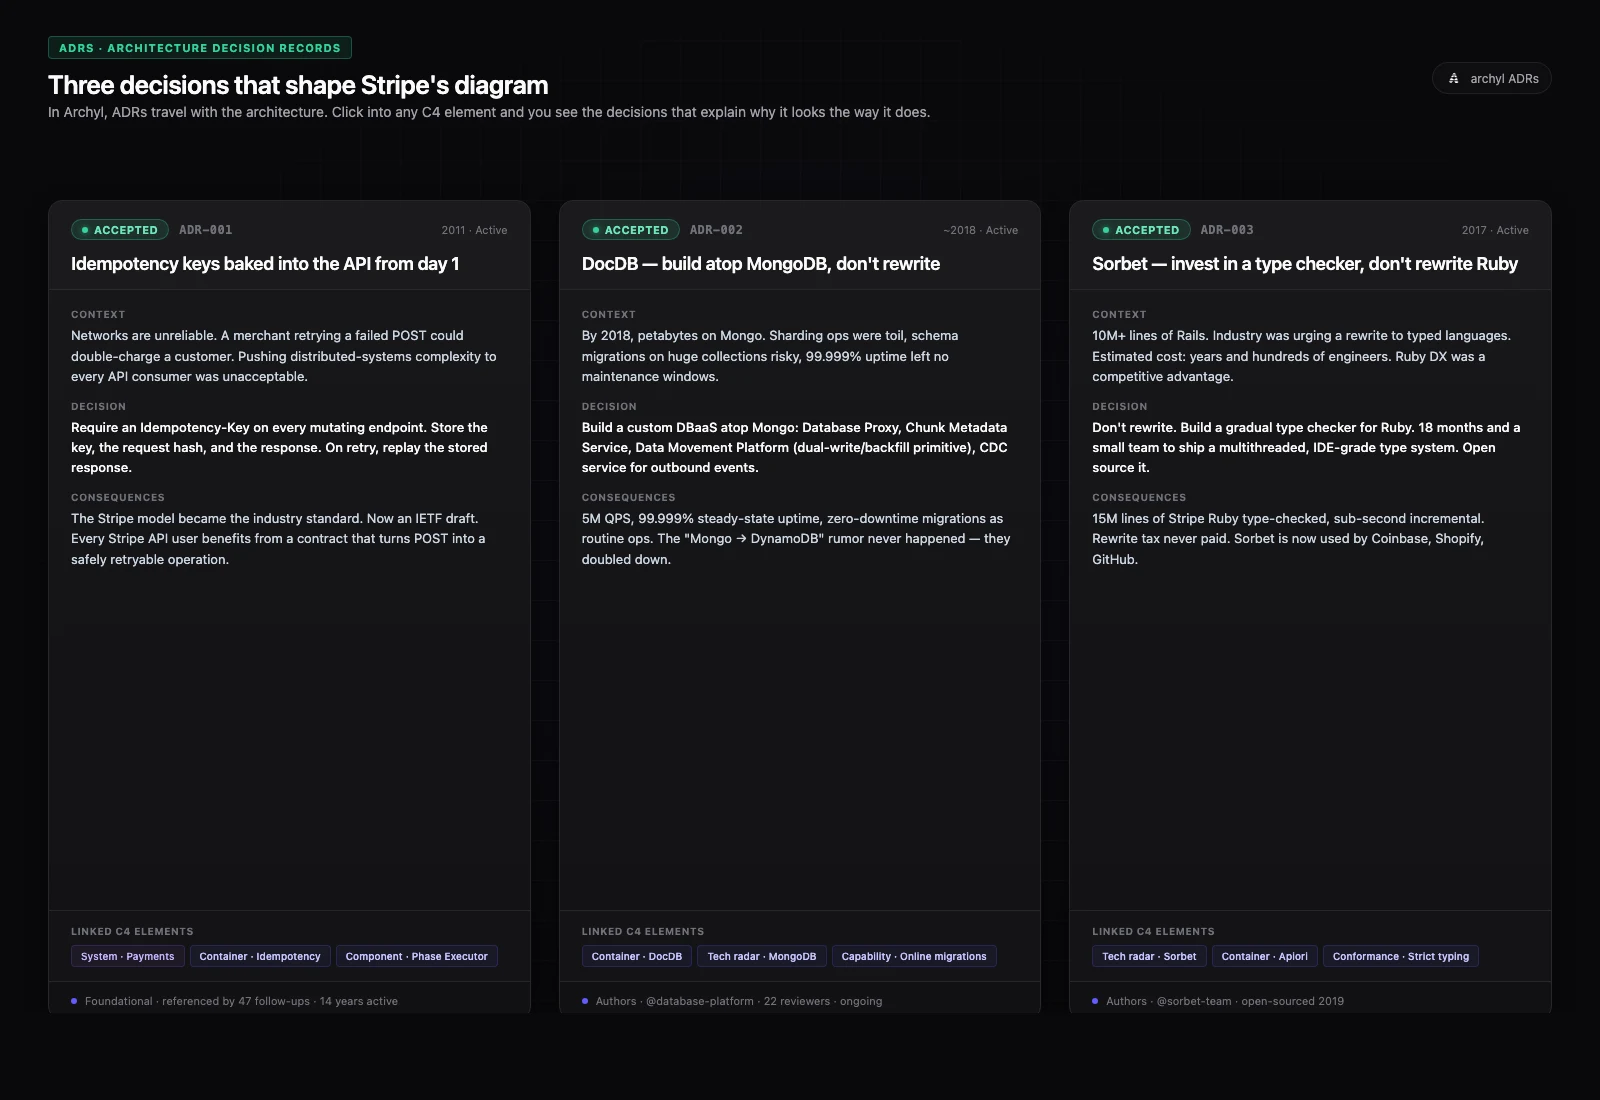
Trois décisions. Trois cards dans Archyl, chacune liée aux éléments C4 qu'elle façonne — Idempotency keys à chaque endpoint mutant, DocDB à la couche data, Sorbet à chaque container Ruby. Le diagramme est le présent ; les ADRs sont le pourquoi.
Ownership : transformer un modèle en responsabilité
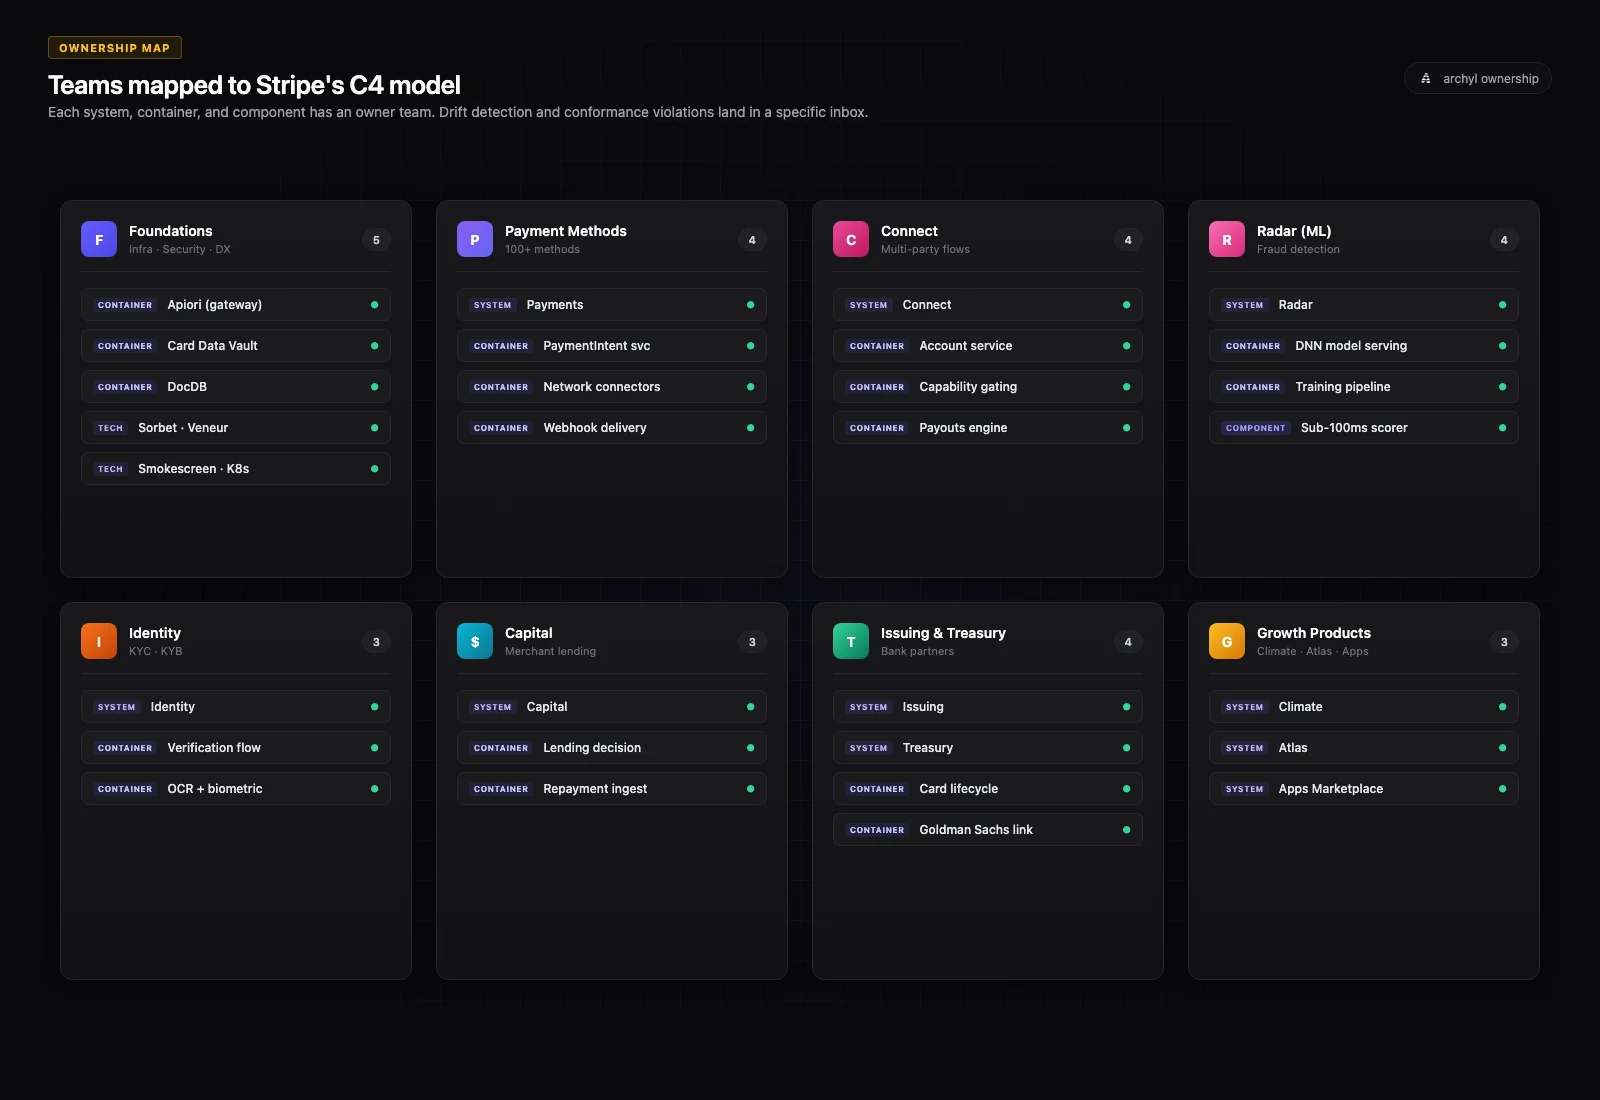
Un modèle C4 reste un artefact statique tant qu'on ne mappe pas les équipes dessus.
Stripe communique publiquement sur sa structure engineering : un groupe Foundations fort (Infrastructure, Security, Data Platform, Developer Experience), des équipes produits alignées sur chaque système majeur (Payment Methods, Connect, Capital, Identity, Issuing, Treasury, Climate, Radar), et des groupes cross-cutting pour le ML et l'observability.
Posez-les sur le modèle C4 :
- Foundations owne Apiori, Sorbet, Veneur, Smokescreen, la plateforme Kubernetes, DocDB, Card Data Vault — le substrat sur lequel chaque produit construit
- Payment Methods owne les Network connectors, la state machine PaymentIntent, les services par-méthode (cartes, ACH, SEPA, wallets)
- Connect owne le service Account, le capability gating, les flux multi-parties, les payouts
- Capital owne le pipeline de décision de prêt et l'intégration avec l'historique Payments du marchand
- Identity owne les workflows KYC/KYB et le compliance gating pour l'onboarding Connect
- Radar (équipe ML) owne le DNN de fraude, le model serving, les training pipelines
- Issuing & Treasury ownent les intégrations partenaires bancaires et le card lifecycle
- Climate owne l'intégration avec la marketplace de compensation carbone
Ce mapping n'est pas décoratif. C'est le substrat de tout ce qui suit.
Une fois qu'un système, container ou composant a une équipe propriétaire, la détection de drift devient responsable : quand un nouveau service apparaît dans les commits sans être sur le diagramme, une équipe spécifique est interpellée. Quand une règle de conformité est violée (un service non-Foundations qui essaie de lire directement depuis le Card Data Vault, par exemple), il y a un nom dans une inbox.
Dans Archyl, la Ownership Map est le moment où un outil de doc devient un outil de gouvernance.
Drift, conformité, et le récap hebdomadaire
Un modèle de cette taille va dériver. De nouveaux produits arrivent — Climate en 2022, Treasury, expansions Tax, Apps Marketplace. Les stacks bougent — des chemins Apiori migrent vers Go, Pinot remplace de l'analytics plus ancien, la strictness Sorbet se renforce.
Archyl calcule un score de drift hebdomadaire : l'écart entre le modèle C4 documenté et ce qui est actuellement dans le code. Les règles de conformité ajoutent la couche policy — « chaque container doit avoir une équipe propriétaire », « seuls les services Foundations peuvent lire le Card Data Vault », « chaque changement d'API publique doit référencer une ADR de versioning ».
Pour Stripe, c'est de la détection de drift à l'échelle de quinze millions de lignes et 27 000 requêtes par seconde. Les règles sont les mêmes que pour dix services.
Et le Récap d'architecture d'équipe qu'on a livré récemment, dans un setup à la Stripe, voudrait dire :
- Le récap du lundi de Foundations couvre Apiori, le Vault, DocDB, la plateforme K8s
- Le récap de Payment Methods couvre les Network connectors, le PaymentIntent service, chaque intégration par-méthode
- Le récap de Radar couvre le DNN de fraude, les training pipelines, les rollouts de modèles
- Chaque récap scopé au périmètre owné par son équipe
Même surface. Périmètres différents. C'est la symétrie que C4 + ownership débloquent.
Vous n'avez pas besoin de traiter un trillion de dollars
Vous n'êtes pas Stripe. La majorité des organisations d'ingénierie ne le sont pas.
Mais la leçon scale aussi vers le bas. La discipline de séparer Context, Container et Component, d'écrire l'ADR qui explique une décision path-dependent (on a construit par-dessus Mongo, on a type-checké Ruby au lieu de réécrire), d'attacher l'ownership à chaque boîte — cette discipline est ce qui empêche une stack de cinquante services de donner l'impression de quinze millions de lignes.
C4 + ADRs + Ownership + Drift + Conformité est ce qu'Archyl vous donne d'office. L'exemple Stripe est juste le plus gros stress-test plausible du modèle dans le domaine des systèmes financiers.
Ouvrez votre propre architecture. Esquissez quinze produits (ou trois, si vous en avez trois). Choisissez celui avec les décisions passées les plus surprenantes et zoomez dans ses containers. Écrivez trois ADRs qui expliqueraient à un nouveau ce qui le ferait s'arracher les cheveux. Mappez une équipe à chaque container.
Vous serez en avance sur la majorité des organisations d'ingénierie.
Vous voulez modéliser votre propre architecture en C4 ? Démarrez avec Archyl. Lisez aussi pourquoi ADRs et C4 fonctionnent mieux ensemble ou comment les Architecture Change Requests apportent la rigueur des pull requests à votre modèle C4. La précédente case study modélisait Netflix en C4 — Anatomy of a Play.