Aviso. Este artículo se basa íntegramente en las comunicaciones públicas de Stripe — su engineering blog, charlas de conferencias, repos open source y casos de estudio externos. No es un documento oficial de arquitectura de Stripe. Modelamos lo que sabemos públicamente para ilustrar cómo un stack complejo puede hacerse legible con el modelo C4. Cuando los detalles son inferidos en vez de afirmados por Stripe, lo decimos.
Anatomía de un Charge: modelando Stripe en C4 con Archyl
Una request POST llega a Stripe a las 3 de la madrugada Pacific durante Black Friday. Veinte segundos después, el merchant está acreditado, el banco emisor del cardholder ha autorizado el cargo, los fondos están en cola para el settlement, el servidor del merchant ha recibido un webhook firmado, y el motor de riesgo de Stripe ha puntuado la transacción en menos de 100 milisegundos.
Esa única request, repetida 27 395 veces por segundo en el peak de BFCM 2024, atraviesa catorce sistemas de Stripe y al menos cuatro redes externas antes de que el frame zero llegue siquiera al dashboard del merchant.
En 2025, Stripe procesó 1,9 trillones de dólares a través de este stack, sosteniendo 99,9999% de uptime durante Black Friday — seis nueves, equivalente a 32 segundos de downtime al año. Lo hicieron sobre aproximadamente quince millones de líneas de Ruby, type-checked por su propio sistema de tipos hecho en casa.
¿Cómo entiendes un stack que hace correr los pagos por tarjeta de medio internet? Como Netflix, no lo entiendes — no de un golpe. Justamente ese es el problema que el modelo C4 fue inventado para resolver.
En este post seguimos una sola acción de usuario — una llamada stripe.PaymentIntents.create() — y la vemos atravesar la arquitectura de Stripe a través de los cuatro niveles C4. No cubriremos cada producto. Trazaremos un charge, escribiremos los ADRs que explican las elecciones que encontramos en el camino, y terminaremos con un mapa de los equipos que poseen cada caja.
Nivel 1 — System Context: quince productos, un trillón de dólares
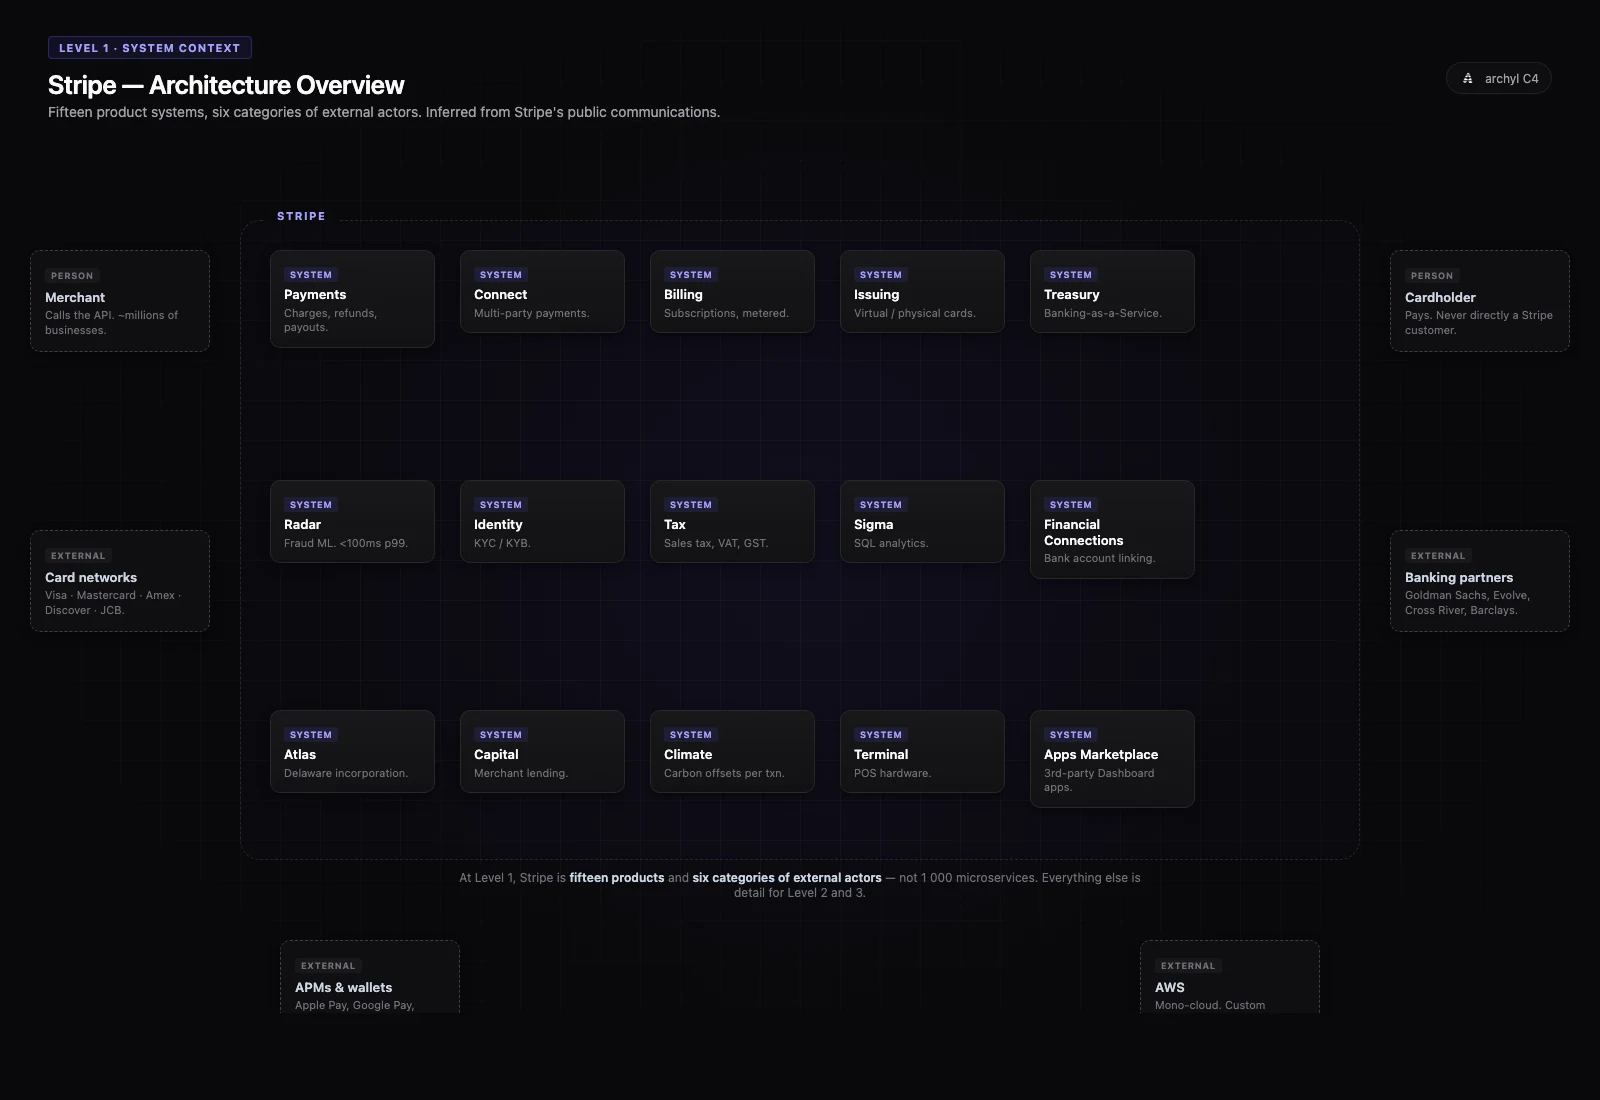
En el nivel System Context, Stripe no es "una API de pagos". Son quince sistemas-producto distintos compartiendo una base:
- Payments — el núcleo histórico: charges, payment intents, refunds, payouts
- Connect — pagos multi-parte, marketplaces, plataformas
- Billing — subscripciones, facturas, billing por consumo
- Atlas — incorporación Delaware C-Corp/LLC
- Capital — préstamos a merchants
- Issuing — creación de tarjetas virtuales y físicas
- Treasury — banking-as-a-service (partnership Goldman Sachs)
- Identity — verificación KYC/KYB
- Tax — sales tax, IVA, GST
- Climate — compensaciones de carbono por transacción
- Radar — detección de fraude ML (scoring sub-100ms)
- Sigma — analytics SQL sobre los datos de Stripe
- Terminal — hardware POS
- Financial Connections — linking de cuenta bancaria (su Plaid)
- Apps Marketplace — apps de terceros en el Dashboard
Alrededor: merchants, cardholders, las cuatro redes de tarjetas (Visa, Mastercard, Amex, Discover) más las regionales (JCB, UnionPay), 100+ métodos de pago alternativos (Apple Pay, Klarna, ACH, SEPA, iDEAL...), bancos adquirentes y emisores, partners bancarios (Goldman Sachs, Evolve, Cross River), autoridades fiscales, providers de identidad, y AWS como cloud subyacente mono-cloud.
Quince sistemas, ocho categorías de actores externos. Todo lo demás es detalle.
Este es el regalo del Nivel 1: en System Context no necesitas saber que Payments son veinte microservicios. Necesitas saber que existe, que habla con las card networks, que Connect coordina con Treasury, y que AWS sostiene todo. El diagrama es un iniciador de conversación, no un inventario.
ADR-001 · Idempotency keys integradas en la API desde el día 1
Estado · Accepted (2011, todavía activo en 2026)
Contexto · Las redes no son fiables. Un merchant que reintenta un POST /charges fallido podría doble-cargar a un cliente. La respuesta de la industria en 2011 fue "el merchant debería gestionar eso" — empujando complejidad de sistemas distribuidos a cada consumidor de API.
Decisión · Requerir Idempotency-Key en cada llamada API mutante. Almacenar la clave, el hash de la request, y la respuesta. En reintento, replay la respuesta almacenada si la clave coincide. Shippearlo como parte first-class de la API, no opt-in.
Consecuencias · El modelo de idempotencia de Stripe se volvió el estándar de facto de la industria. El draft IETF de Idempotency-Key está directamente inspirado en él. Cada usuario de la API de Stripe, sepa o no, se beneficia de un contrato que convierte POST /charges en una operación safely retryable. Haremos zoom en cómo funciona en el Nivel 3.
Esta es la elección arquitectural única que más da forma a la superficie API de Stripe. Sin ella, el modelo C4 tendría que exponer lógica de retry en cada boundary mutante — leakeando complejidad de sistemas distribuidos a cada consumidor.
En Archyl, así es como un ADR gana su lugar: explica por qué la boundary se ve como se ve.
Nivel 2 — Container: zoom en Payments core
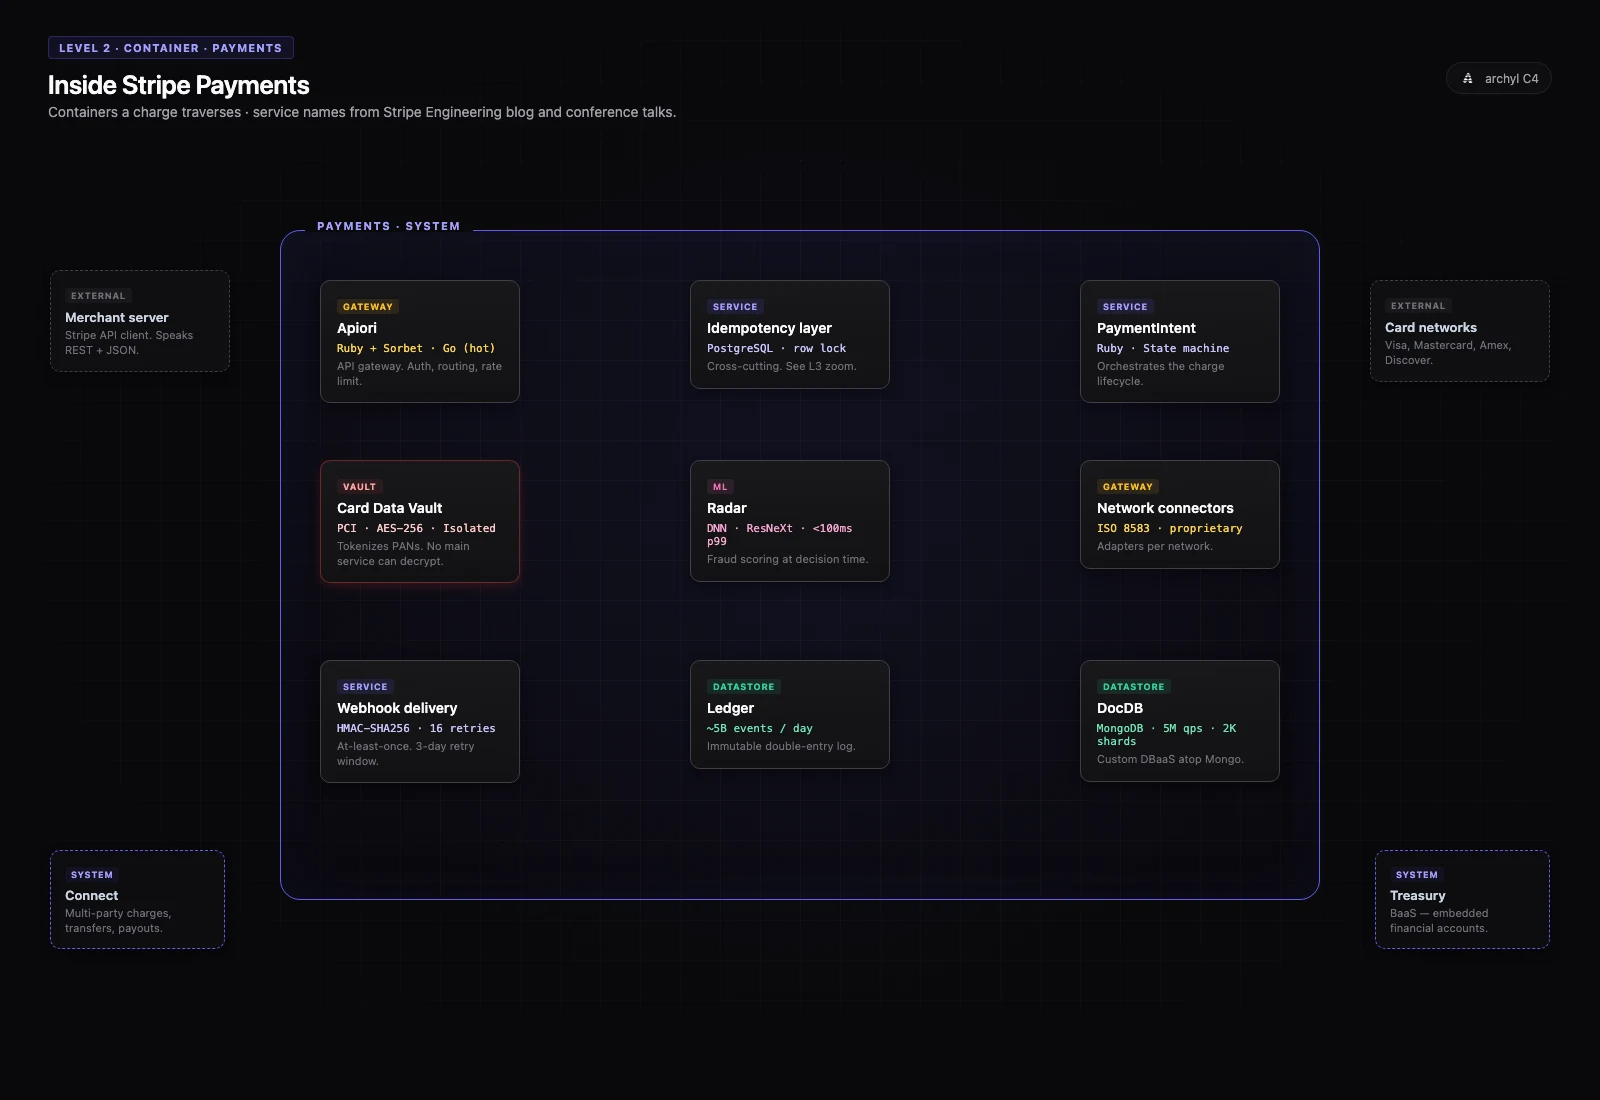
El stripe.PaymentIntents.create() del merchant aterriza al borde de Payments. Abramos la caja.
Dentro de Payments, las fuentes públicas revelan al menos estos containers:
- Apiori — el API gateway. Originalmente Ruby + Rails, con el código de hot-path progresivamente reescrito en Go para latencias sub-150 µs en la capa de auth y routing.
- Idempotency layer — la cross-cutting concern que se sienta delante de cada endpoint mutante. Backed por PostgreSQL con row-level locking.
- PaymentIntent service — orquesta la state machine:
requires_payment_method→requires_confirmation→requires_action(challenge 3DS) →processing→succeeded(orequires_capture). - Card Data Vault — entorno PCI físicamente aislado, AES-256 at rest, ningún servicio principal puede descifrar un PAN. Toda la card data fluye por tokenization.
- Radar — scoring de fraude en menos de 100 ms p99. DNN puro desde 2022, arquitectura inspirada en ResNeXt.
- Network connectors — adapters para Visa, Mastercard, Amex, etc. Hablan ISO 8583 y protocolos propietarios en el wire.
- Webhook delivery service — at-least-once delivery, 16 reintentos sobre 3 días con exponential backoff, signing HMAC-SHA256.
- Ledger — log de eventos inmutable, ~5 mil millones de eventos por día, ~100 entradas de ledger por pago. Source of truth para reconciliación, auditoría y contabilidad.
- DocDB — Database-as-a-Service custom de Stripe, construida encima de MongoDB. 5 millones de queries por segundo, 5 000+ collections, 2 000+ shards, petabytes de datos financieros.
El stack tecnológico a este nivel: Ruby con Sorbet types como lenguaje dominante (15M líneas), Go en hot paths, PostgreSQL para concerns relacionales (idempotencia, accounts), DocDB para workloads document de alto volumen, Apache Kafka para events, Apache Pinot para analytics tiempo real, Apache Flink para stream processing.
Un charge típico toca Apiori → Idempotency layer → PaymentIntent service → (Vault para tokens) → (Radar para riesgo en paralelo) → Network connector → Ledger → Webhook fanout. Todo eso, con reintentos, instrumentado end-to-end vía Veneur y enrutado de forma segura a través de Smokescreen para cualquier egress externo.
ADR-002 · DocDB — construir encima de MongoDB en vez de reescribir
Estado · Accepted (~2018, inversión continua)
Contexto · Para 2018, el volumen de datos de Stripe en MongoDB estaba estresando el producto off-the-shelf: las migraciones de schema en collections de petabytes eran peligrosas, el sharding era trabajo operacional, y los requirements de uptime de 99,999% no dejaban ventanas de mantenimiento. La industria habría dicho "reescribir hacia un store relacional".
Decisión · No migrar la capa de datos a otro engine. En su lugar, construir un Database-as-a-Service custom encima de MongoDB: un Database Proxy, un Chunk Metadata Service, una Data Movement Platform que ejecuta el patrón dual-write/backfill/dual-read/cleanup como primitiva managed, y un servicio CDC para events salientes.
Consecuencias · Stripe obtiene lo mejor del modelo flexible de MongoDB más las garantías operacionales de una plataforma managed: 5M QPS, 99,999% de uptime steady-state, migraciones zero-downtime como operación rutinaria. La migración "Mongo → DynamoDB" que el rumor de internet a veces afirma haber pasado nunca pasó. Doblaron la apuesta.
Este ADR es un excelente ejemplo de arquitectura path-dependent: la respuesta correcta en 2018 era extender, no reemplazar.
Nivel 3 — Component: dentro de la capa de idempotencia
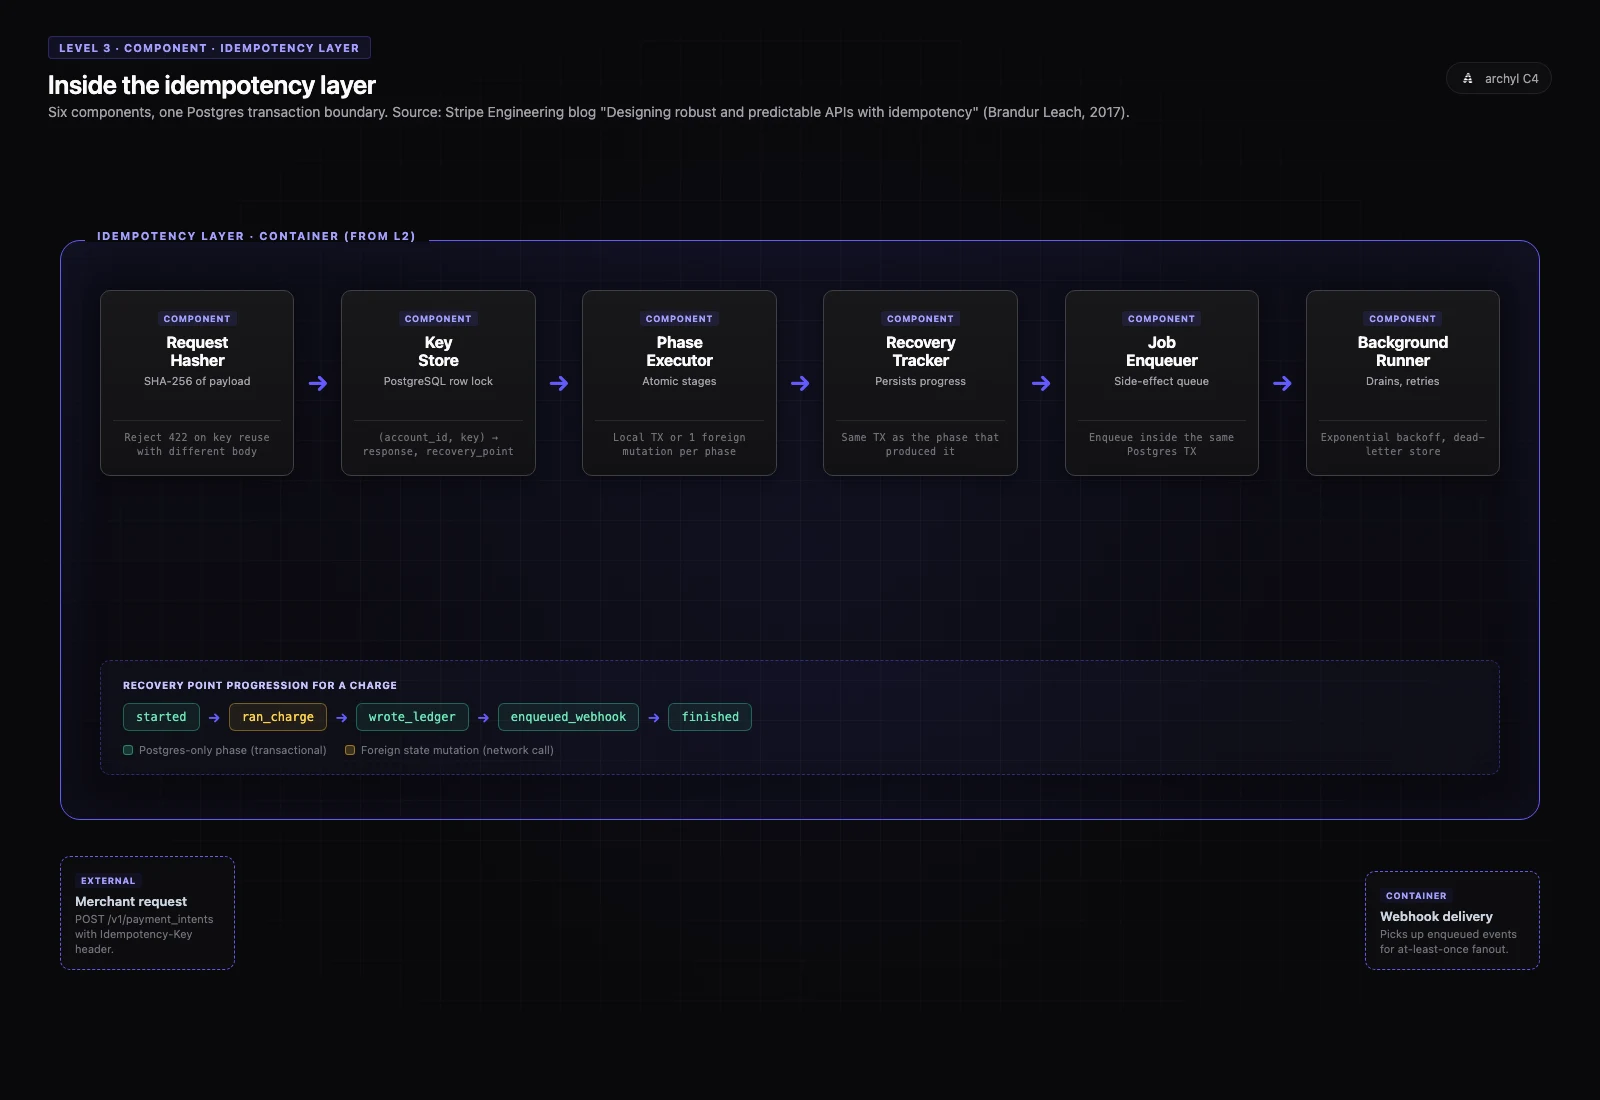
De todos los componentes del stack de Stripe, la Idempotency layer es la más públicamente documentada — el post de 2017 de Brandur Leach sigue siendo una referencia canónica para ingenieros de sistemas distribuidos.
Un solo POST /charges con una idempotency key atraviesa estos componentes dentro de la capa:
- Request hasher — calcula un hash determinista del payload de la request. Si la misma idempotency key llega con un payload diferente, la API devuelve 422 (el cliente cometió un error de programación).
- Idempotency key store — una tabla PostgreSQL con clave en
(account_id, idempotency_key). Incluyerequest_hash,response_code,response_body,recovery_point,last_run_at,locked_at. La columnalocked_atimplementa row-level locking para reintentos concurrentes. - Phase executor — divide la operación en fases atómicas separadas por foreign state mutations. Cada fase es o puramente local (Postgres-only, transaccional con la fila de idempotencia) o un solo side-effect externo (tokenize Vault, charge red, envío webhook).
- Recovery point tracker — persiste la fase actual:
started→ran_charge→wrote_ledger→enqueued_webhook→finished. En reintento, el executor reanuda en el recovery point. - Job enqueuer — para side-effects asíncronos (emails, webhooks), enqueue un job durable en la misma transacción Postgres que la actualización del recovery point. Atómico por construcción.
- Background runner — drena la cola de jobs con su propia semántica de retry, exponential backoff, y dead-letter store.
El patrón es brutalmente simple una vez que lo ves: toda mutación local vive en la misma transacción Postgres que la actualización de la fila de idempotencia; toda mutación externa vive entre dos recovery points. Esa forma elimina toda una clase de bugs de double-write que plagan los sistemas distribuidos construidos sin esta primitiva.
Esto es lo que Component-level C4 parece: no "aquí hay algo de código", sino "aquí está la cadena de primitivas business-meaningful, cada una owned, cada una reemplazable, cada una medible".
ADR-003 · Sorbet — invertir en un type checker, no reescribir Ruby
Estado · Accepted (~2017, open-sourced en 2019, todavía por defecto)
Contexto · Para 2017, el monolito Ruby + Rails de Stripe había crecido más allá de 10 millones de líneas. El consejo dominante de la industria para una fintech de ese tamaño era reescribir en un lenguaje tipado — Java, Go, o Scala. El coste estimado era años y cientos de ingenieros. La DX de Ruby, mientras tanto, era la ventaja competitiva de Stripe para shippear rápido.
Decisión · No reescribir. Construir un type checker gradual para Ruby. Tomar 18 meses y un equipo pequeño para shippear un sistema de tipos multithreaded, IDE-grade, que escale a millones de líneas. Open-source.
Consecuencias · Sorbet ahora type-checkea 15 millones de líneas de Ruby de Stripe con latencia incremental sub-segundo. Stripe nunca pagó la rewrite tax. Pagaron la invent-a-type-checker tax — una sola vez. Sorbet se ha convertido en un proyecto open source significativo usado por Coinbase, Shopify, GitHub, y otros.
En un modelo Archyl, ADRs como esta viajan con la arquitectura. Cuando haces clic en el container Apiori en 2026 y ves "Ruby + Sorbet", también ves la decisión de 2017 que explica por qué no es Java.
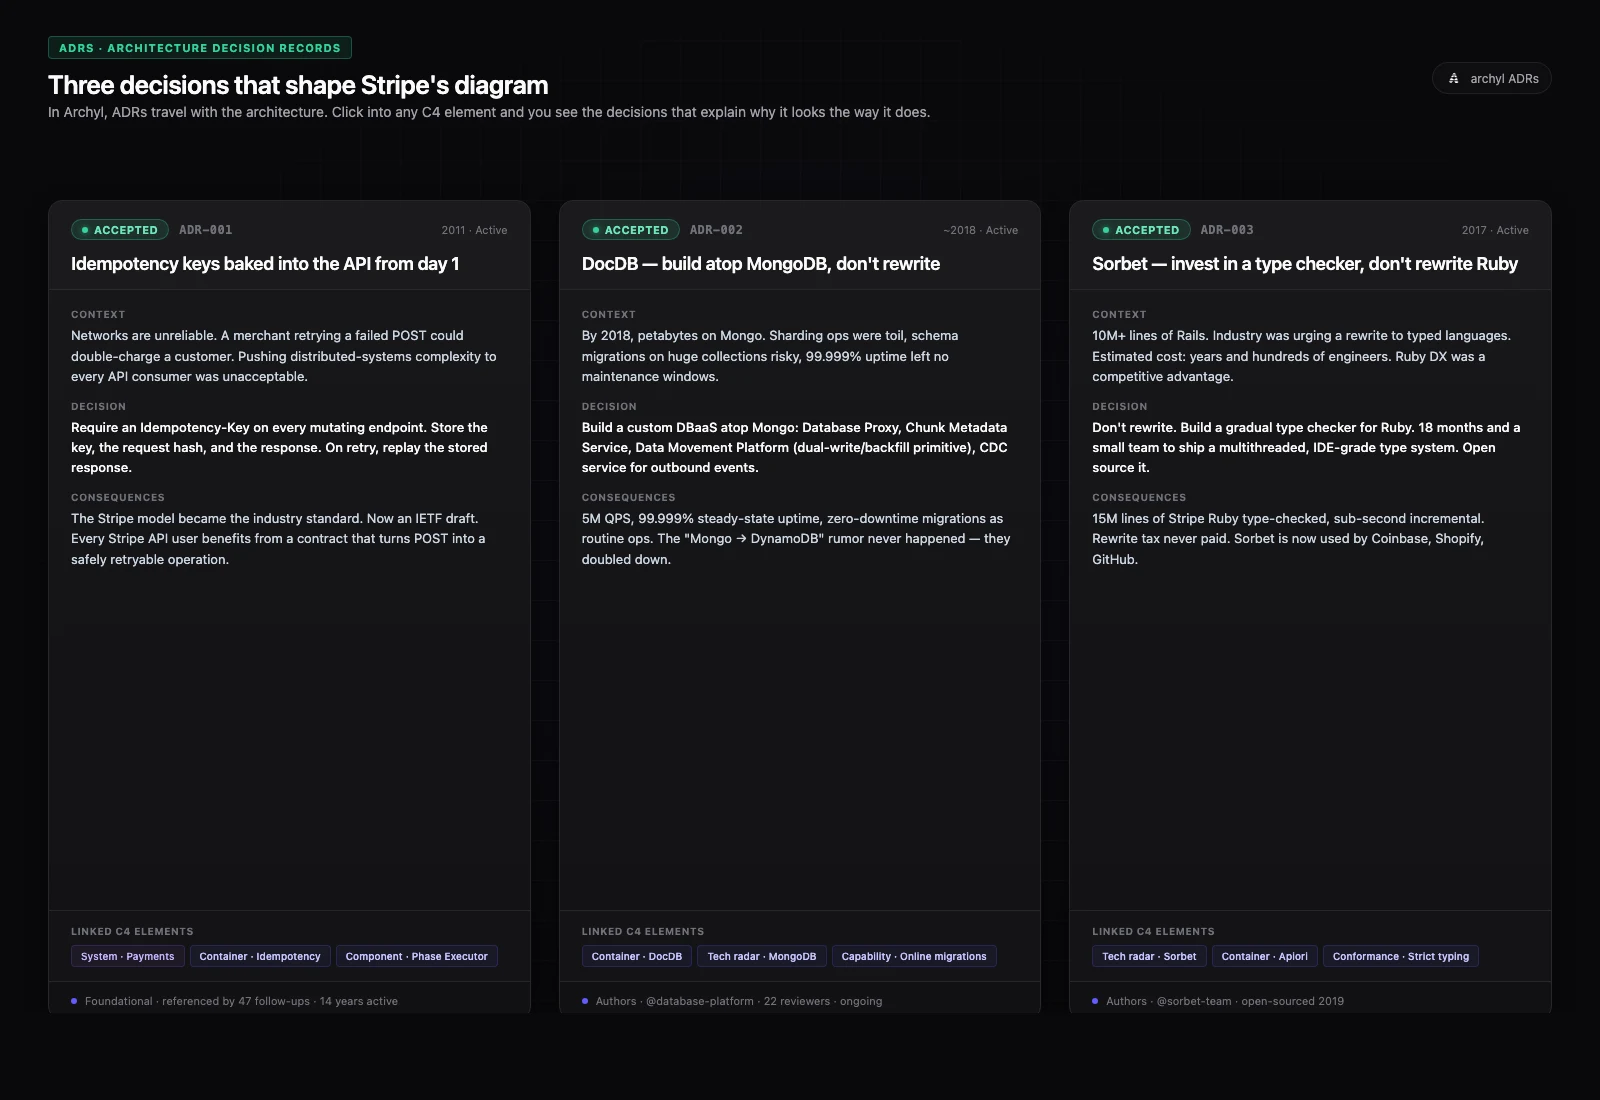
Tres decisiones. Tres cards en Archyl, cada una linkada a los elementos C4 que da forma — Idempotency keys a cada endpoint mutante, DocDB a la capa de datos, Sorbet a cada container Ruby. El diagrama es el presente; los ADRs son el porqué.
Ownership: convertir un modelo en accountability
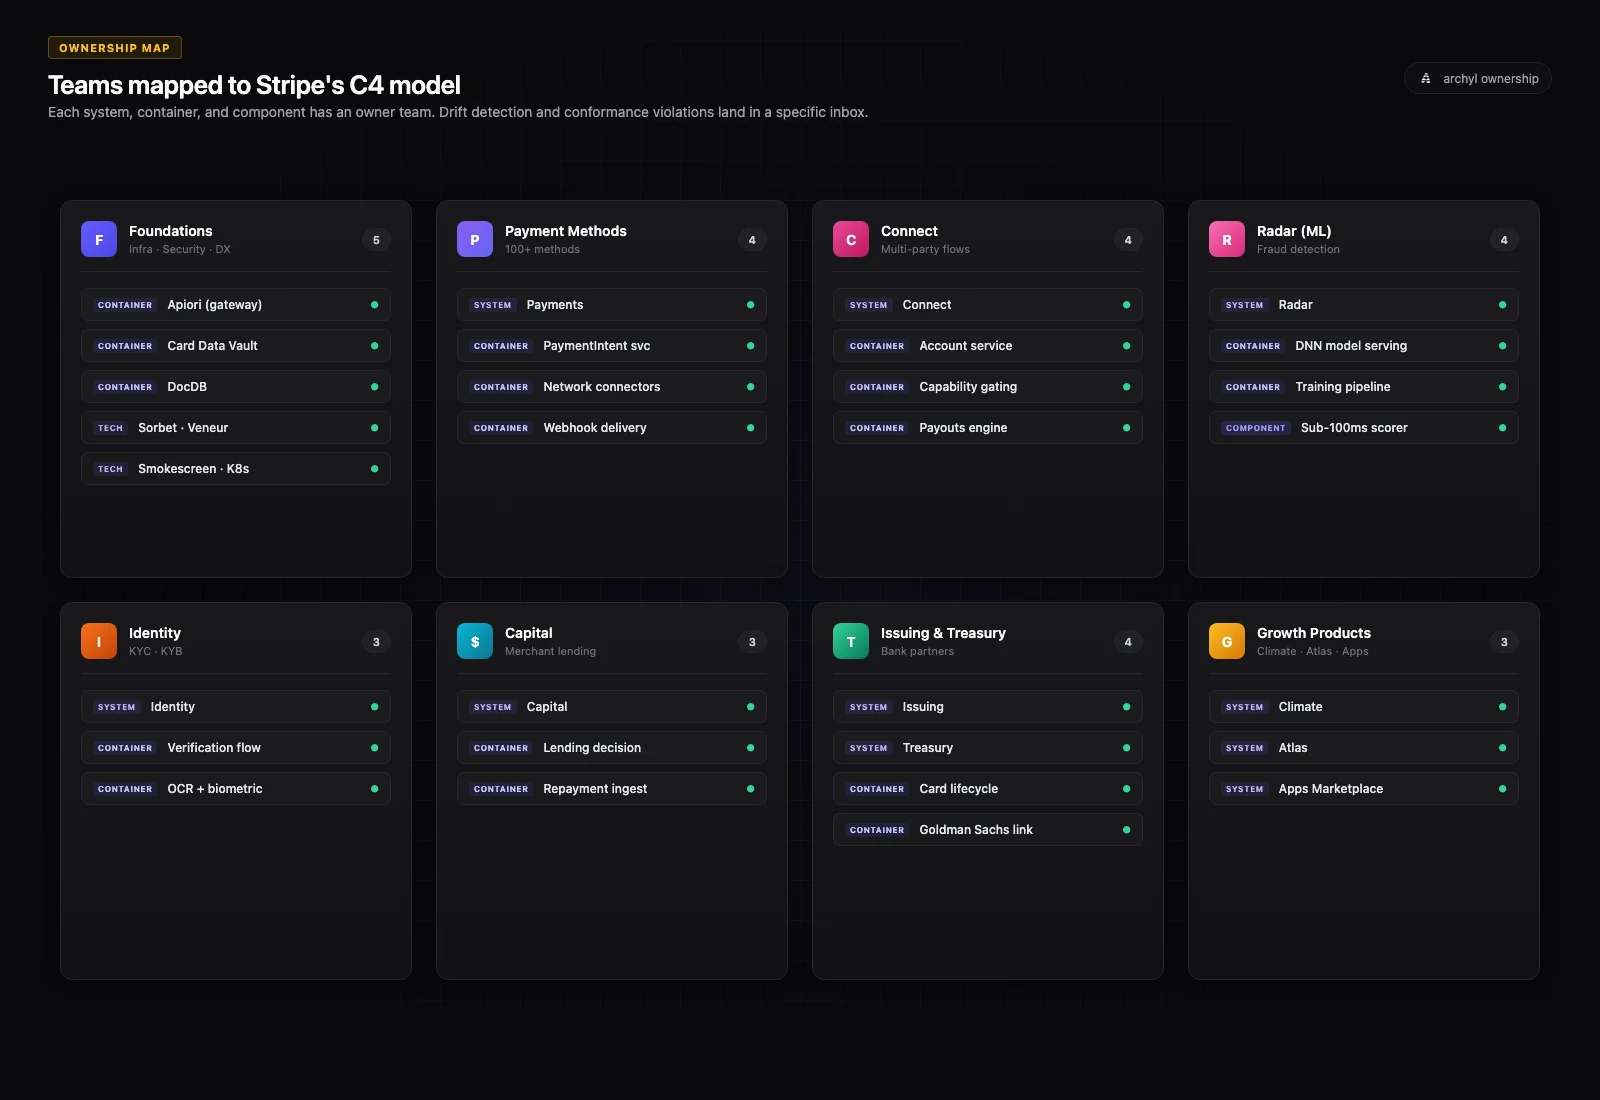
Un modelo C4 es un artefacto estático hasta que mapeas equipos a él.
Stripe comunica públicamente sobre su estructura engineering: un grupo Foundations fuerte (Infrastructure, Security, Data Platform, Developer Experience), equipos producto alineados a cada sistema mayor (Payment Methods, Connect, Capital, Identity, Issuing, Treasury, Climate, Radar), y grupos cross-cutting para ML y observability.
Pónlos sobre el modelo C4:
- Foundations posee Apiori, Sorbet, Veneur, Smokescreen, la plataforma Kubernetes, DocDB, Card Data Vault — el sustrato sobre el que cada producto construye
- Payment Methods posee los Network connectors, la state machine PaymentIntent, los servicios por-método (cards, ACH, SEPA, wallets)
- Connect posee el servicio Account, capability gating, flujos multi-parte, payouts
- Capital posee el pipeline de decisión de préstamo y la integración con la historia Payments del merchant
- Identity posee los workflows KYC/KYB y el compliance gating para onboarding Connect
- Radar (equipo ML) posee el DNN de fraude, el model serving, los training pipelines
- Issuing & Treasury poseen las integraciones bank-partner y el card lifecycle
- Climate posee la integración con la marketplace de offsetting de carbono
Este mapeo no es decoración. Es el sustrato de todo lo que viene después.
Una vez que un sistema, container o componente tiene una equipo propietaria, la detección de drift se vuelve responsable: cuando un nuevo servicio aparece en commits y no está en el diagrama, una equipo específica es interpelada. Cuando una regla de conformidad es violada (un servicio non-Foundations intentando leer del Card Data Vault directamente, por ejemplo), hay un nombre en una inbox.
En Archyl, el Ownership Map es el momento en que una herramienta de doc se vuelve una herramienta de gobernanza.
Drift, conformidad, y el resumen semanal
Un modelo de este tamaño va a derivar. Nuevos productos llegan — Climate en 2022, Treasury, expansiones Tax, Apps Marketplace. Los stacks cambian — caminos de Apiori migran a Go, Pinot reemplaza analytics más viejo, la strictness de Sorbet sube.
Archyl computa un score de drift semanal: la brecha entre el modelo C4 documentado y lo que está actualmente en el código. Las reglas de conformidad añaden la capa policy — "cada container necesita una equipo propietaria", "solo los servicios Foundations pueden leer Card Data Vault", "cada cambio de API pública debe referenciar un ADR de versioning".
Para Stripe es detección de drift a la escala de quince millones de líneas y 27 000 requests por segundo. Las reglas son las mismas que para diez servicios.
Y el Resumen de Arquitectura de Equipo que lanzamos recientemente, en un setup tipo Stripe, significaría:
- El resumen del lunes de Foundations cubre Apiori, el Vault, DocDB, la plataforma K8s
- El resumen de Payment Methods cubre Network connectors, el PaymentIntent service, cada integración por-método
- El resumen de Radar cubre el DNN de fraude, los training pipelines, los rollouts de modelo
- Cada resumen scoped al perímetro propio de su equipo
Misma superficie. Diferentes scopes. Esa es la simetría que C4 + ownership desbloquean.
No necesitas procesar un trillón de dólares
No eres Stripe. La mayoría de organizaciones de ingeniería no lo son.
Pero la lección escala también hacia abajo. La disciplina de separar Context de Container de Component, de escribir el ADR que explica una decisión path-dependent (construimos encima de Mongo, type-checkeamos Ruby en vez de reescribirlo), de adjuntar ownership a cada caja — esa disciplina es lo que evita que un stack de cincuenta servicios se sienta como quince millones de líneas.
C4 + ADRs + Ownership + Drift + Conformidad es lo que Archyl te da out of the box. El ejemplo Stripe es solo el más grande stress-test plausible del modelo en el dominio de los sistemas financieros.
Abre tu propia arquitectura. Esquematiza quince productos (o tres, si tienes tres). Elige el con las decisiones pasadas más sorprendentes y zoomea en sus containers. Escribe tres ADRs explicando lo que sorprendería a un nuevo. Mapea una equipo a cada container.
Estarás por delante de donde la mayoría de organizaciones de ingeniería llegan en un año.
¿Quieres modelar tu propia arquitectura en C4? Empieza con Archyl. Lee también por qué ADRs y C4 funcionan mejor juntos o cómo los Architecture Change Requests aportan rigor de pull request a tu modelo C4. El case study anterior modelaba Netflix en C4 — Anatomía de un Play.