Hinweis. Dieser Artikel basiert ausschließlich auf öffentlichen Kommunikationen von Stripe — ihrem Engineering-Blog, Konferenz-Talks, Open-Source-Repositories und externen Case Studies. Es ist kein offizielles Architektur-Dokument von Stripe. Wir modellieren das, was wir öffentlich wissen, um zu zeigen, wie ein komplexer Stack mit dem C4-Modell lesbar gemacht werden kann. Wenn Details inferiert sind statt von Stripe bestätigt, sagen wir das.
Anatomie eines Charges: Stripe in C4 mit Archyl modellieren
Eine POST-Request trifft Stripe um 3 Uhr morgens Pacific während Black Friday. Zwanzig Sekunden später ist der Merchant gutgeschrieben, die Issuing-Bank des Cardholders hat den Charge autorisiert, die Funds sind in der Queue für Settlement, der Merchant-Server hat einen signierten Webhook bekommen, und Stripes Risk-Engine hat die Transaktion in unter 100 Millisekunden bewertet.
Diese eine Request, 27 395 mal pro Sekunde im BFCM-2024-Peak wiederholt, durchquert vierzehn Stripe-Systeme und mindestens vier externe Netzwerke, bevor Frame Null je das Dashboard des Merchants trifft.
2025 hat Stripe 1,9 Billionen Dollar durch diesen Stack verarbeitet und während Black Friday 99,9999% Uptime gehalten — sechs Neunen, äquivalent zu 32 Sekunden Downtime pro Jahr. Sie haben das auf etwa fünfzehn Millionen Zeilen Ruby gemacht, type-checked von ihrem eigenen selbstgebauten Type-System.
Wie versteht man einen Stack, der die Kreditkarten-Zahlungen des halben Internets betreibt? Wie Netflix versteht man ihn nicht — nicht auf einmal. Genau das ist das Problem, das das C4-Modell erfunden wurde, um zu lösen.
In diesem Post folgen wir einer einzigen User-Aktion — einem stripe.PaymentIntents.create()-Aufruf — und sehen zu, wie sie Stripes Architektur über die vier C4-Ebenen durchquert. Wir werden nicht jedes Produkt abdecken. Wir verfolgen einen Charge, schreiben die ADRs, die die Entscheidungen erklären, die wir auf dem Weg treffen, und enden mit einer Karte der Teams, die jede Box besitzen.
Ebene 1 — System Context: fünfzehn Produkte, eine Billion Dollar
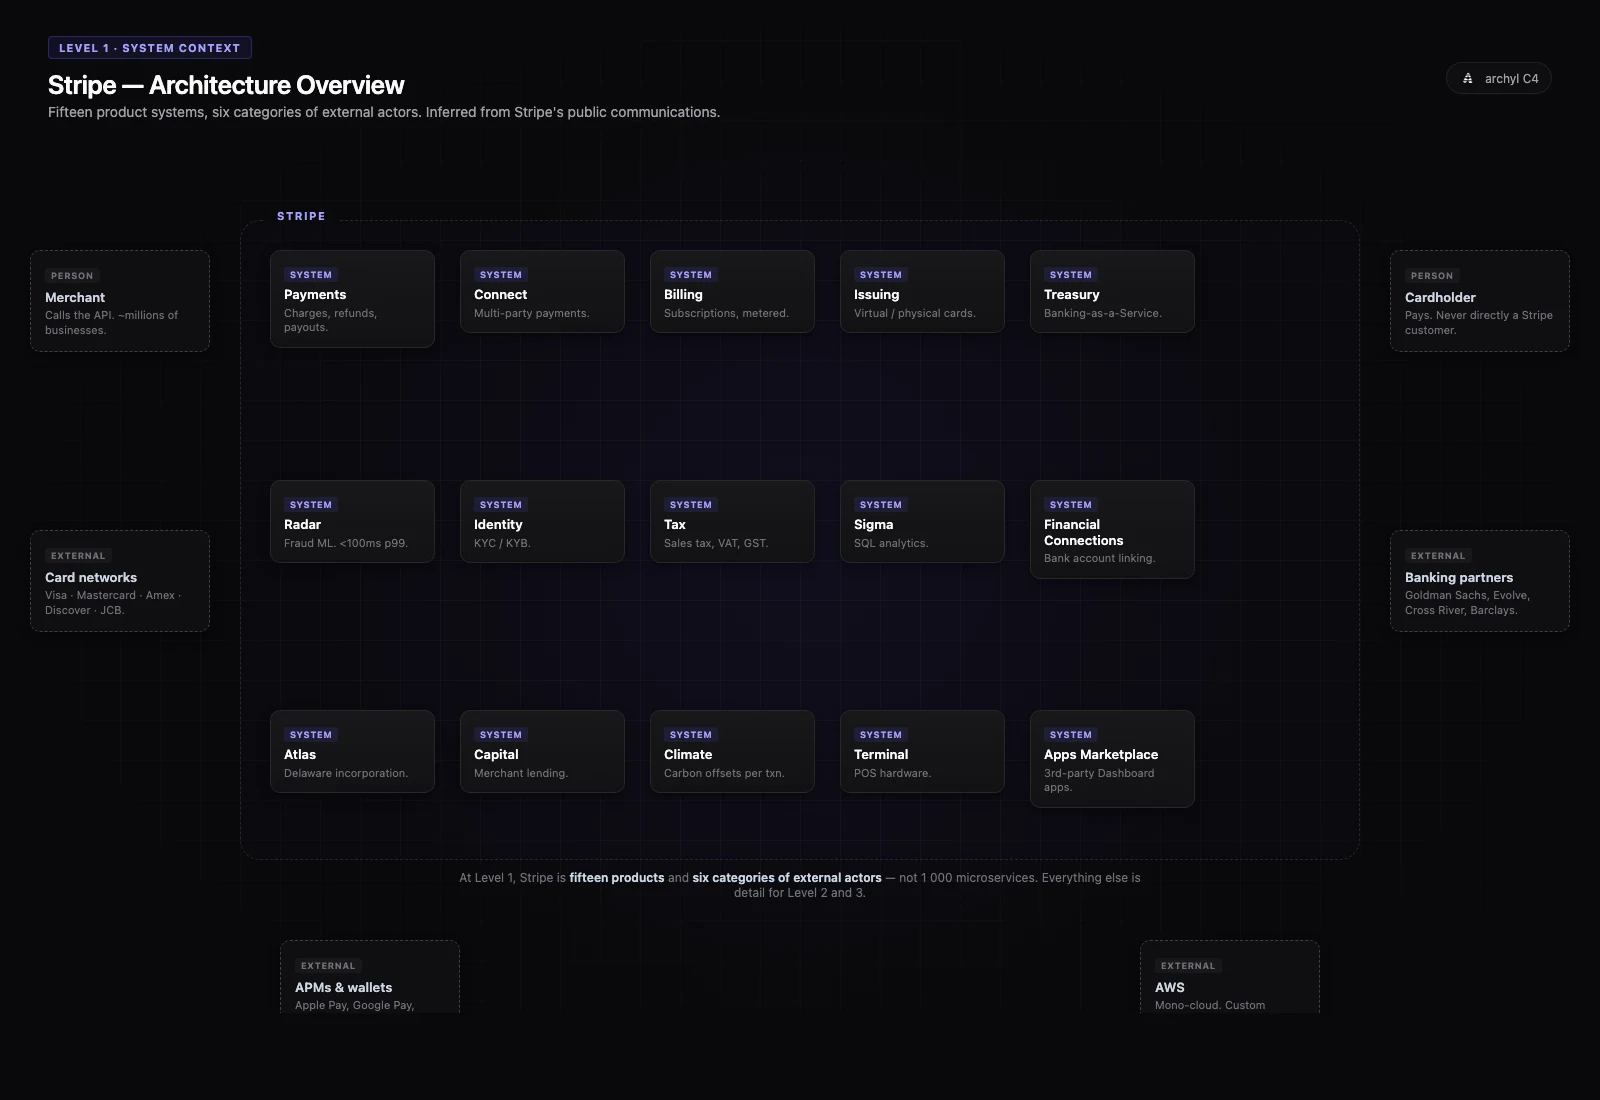
Auf der System-Context-Ebene ist Stripe nicht "eine Payment-API". Es sind fünfzehn distinkte Produkt-Systeme, die ein Fundament teilen:
- Payments — der historische Kern: Charges, Payment Intents, Refunds, Payouts
- Connect — Multi-Party-Payments, Marketplaces, Plattformen
- Billing — Subscriptions, Rechnungen, Metered Billing
- Atlas — Delaware-C-Corp/LLC-Inkorporation
- Capital — Merchant-Lending
- Issuing — Erstellung virtueller und physischer Karten
- Treasury — Banking-as-a-Service (Goldman-Sachs-Partnerschaft)
- Identity — KYC/KYB-Verifizierung
- Tax — Sales Tax, MwSt., GST
- Climate — Carbon-Offsets pro Transaktion
- Radar — Fraud-Erkennung ML (sub-100ms Scoring)
- Sigma — SQL-Analytics auf Stripe-Daten
- Terminal — POS-Hardware
- Financial Connections — Bankkonto-Linking (ihr Plaid)
- Apps Marketplace — Drittanbieter-Apps im Dashboard
Drumherum: Merchants, Cardholder, die vier Card-Networks (Visa, Mastercard, Amex, Discover) plus regionale (JCB, UnionPay), 100+ alternative Payment-Methoden (Apple Pay, Klarna, ACH, SEPA, iDEAL...), Acquiring- und Issuing-Banken, Bank-Partner (Goldman Sachs, Evolve, Cross River), Steuerbehörden, Identity-Provider, und AWS als zugrundeliegende Mono-Cloud.
Fünfzehn Systeme, acht Kategorien externer Akteure. Alles andere ist Detail.
Das ist das Geschenk von Ebene 1: Im System Context musst du nicht wissen, dass Payments zwanzig Microservices sind. Du musst wissen, dass es existiert, dass es mit Card-Networks spricht, dass Connect mit Treasury koordiniert, und dass AWS alles unterstützt. Das Diagramm ist ein Gesprächs-Starter, kein Inventar.
ADR-001 · Idempotency-Keys von Tag 1 in der API
Status · Accepted (2011, 2026 immer noch aktiv)
Kontext · Netzwerke sind unzuverlässig. Ein Merchant, der einen fehlgeschlagenen POST /charges retried, könnte einen Kunden doppelt belasten. Die Antwort der Industrie 2011 war "der Merchant sollte das handhaben" — distribuierte Systeme-Komplexität auf jeden API-Konsumenten abwälzen.
Entscheidung · Idempotency-Key bei jedem mutierenden API-Aufruf verlangen. Den Key, den Request-Hash und die Response speichern. Bei Retry die gespeicherte Response wiedergeben, wenn der Key passt. Als First-Class-Teil der API ausliefern, nicht als Opt-in.
Konsequenzen · Stripes Idempotenz-Modell wurde zum De-facto-Industriestandard. Der IETF-Draft Idempotency-Key ist direkt davon inspiriert. Jeder Stripe-API-Nutzer profitiert, ob bewusst oder nicht, von einem Vertrag, der POST /charges in eine sicher retryable Operation verwandelt. Wir zoomen in Ebene 3, wie es funktioniert.
Das ist die einzige architektonische Entscheidung, die Stripes API-Oberfläche am stärksten formt. Ohne sie müsste das C4-Modell Retry-Logik an jeder mutierenden Boundary exponieren — und damit distribuierte Systeme-Komplexität an jeden Konsumenten leaken.
In Archyl verdient sich ein ADR so seinen Platz: Er erklärt, warum die Boundary so aussieht, wie sie aussieht.
Ebene 2 — Container: Zoom in Payments core
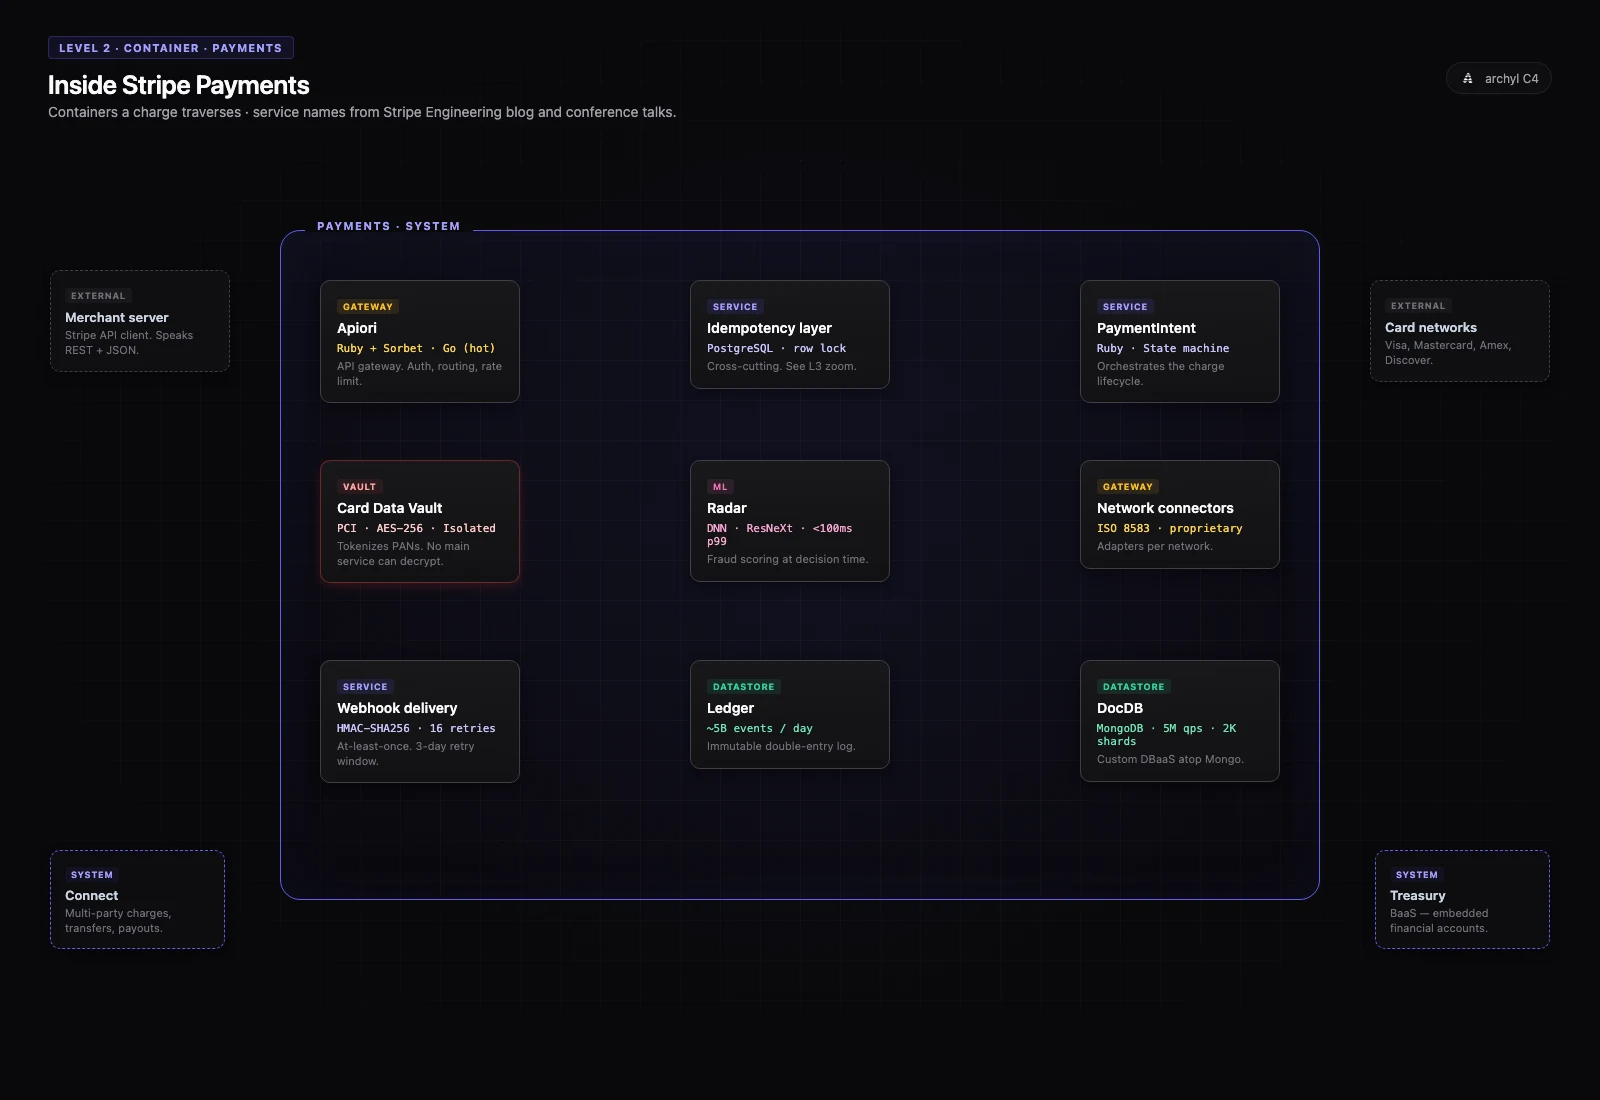
Der stripe.PaymentIntents.create() des Merchants landet am Rand von Payments. Lass uns die Box öffnen.
In Payments offenbaren öffentliche Quellen mindestens diese Container:
- Apiori — das API-Gateway. Ursprünglich Ruby + Rails, mit Hot-Path-Code progressiv in Go umgeschrieben für Sub-150-µs-Latenzen auf der Auth- und Routing-Layer.
- Idempotency layer — die Cross-Cutting Concern, die vor jedem mutierenden Endpoint sitzt. Backed durch PostgreSQL mit Row-Level-Locking.
- PaymentIntent service — orchestriert die State Machine:
requires_payment_method→requires_confirmation→requires_action(3DS-Challenge) →processing→succeeded(oderrequires_capture). - Card Data Vault — physisch isolierte PCI-Umgebung, AES-256 at rest, kein Hauptservice kann eine PAN entschlüsseln. Alle Card-Daten fließen durch Tokenization.
- Radar — Fraud-Scoring in unter 100 ms p99. Pures DNN seit 2022, ResNeXt-inspirierte Architektur.
- Network connectors — Adapter für Visa, Mastercard, Amex usw. Sprechen ISO 8583 und proprietäre Protokolle auf der Leitung.
- Webhook delivery service — At-least-once Delivery, 16 Retries über 3 Tage mit Exponential Backoff, HMAC-SHA256-Signing.
- Ledger — unveränderlicher Event-Log, ~5 Milliarden Events pro Tag, ~100 Ledger-Einträge pro Zahlung. Source of Truth für Reconciliation, Audit und Buchhaltung.
- DocDB — Stripes custom Database-as-a-Service, gebaut auf MongoDB. 5 Millionen Queries pro Sekunde, 5 000+ Collections, 2 000+ Shards, Petabytes an Finanzdaten.
Der Tech-Stack auf dieser Ebene: Ruby mit Sorbet-Types als dominante Sprache (15M Zeilen), Go auf Hot Paths, PostgreSQL für relationale Concerns (Idempotency, Accounts), DocDB für High-Volume-Document-Workloads, Apache Kafka für Events, Apache Pinot für Echtzeit-Analytics, Apache Flink für Stream-Processing.
Ein typischer Charge berührt Apiori → Idempotency layer → PaymentIntent service → (Vault für Tokens) → (Radar für Risk parallel) → Network connector → Ledger → Webhook fanout. Alles davon, mit Retries, end-to-end via Veneur instrumentiert und sicher durch Smokescreen für jeden externen Egress geroutet.
ADR-002 · DocDB — auf MongoDB aufbauen statt umschreiben
Status · Accepted (~2018, fortlaufende Investition)
Kontext · Bis 2018 strapazierte Stripes Datenvolumen auf MongoDB das Off-the-Shelf-Produkt: Schema-Migrationen auf Petabyte-Collections waren gefährlich, Sharding war Operations-Toil, und 99,999%-Uptime-Anforderungen ließen keine Wartungsfenster. Die Industrie hätte gesagt "in einen relationalen Store umschreiben".
Entscheidung · Den Daten-Layer nicht auf einen anderen Engine migrieren. Stattdessen einen custom Database-as-a-Service auf MongoDB bauen: einen Database Proxy, einen Chunk Metadata Service, eine Data Movement Platform, die das Dual-Write/Backfill/Dual-Read/Cleanup-Pattern als managed Primitive ausführt, und einen CDC-Service für ausgehende Events.
Konsequenzen · Stripe bekommt das Beste aus MongoDBs flexiblem Document-Modell plus die operativen Garantien einer Managed-Plattform: 5 M QPS, 99,999% Steady-State-Uptime, Zero-Downtime-Migrationen als Routine-Operation. Die "Mongo → DynamoDB"-Migration, die Internet-Gerüchte gelegentlich behaupten? Hat nie stattgefunden. Sie haben stattdessen verdoppelt.
Dieses ADR ist ein großartiges Beispiel für path-dependent Architecture: Die richtige Antwort 2018 war zu erweitern, nicht zu ersetzen.
Ebene 3 — Component: in der Idempotency layer
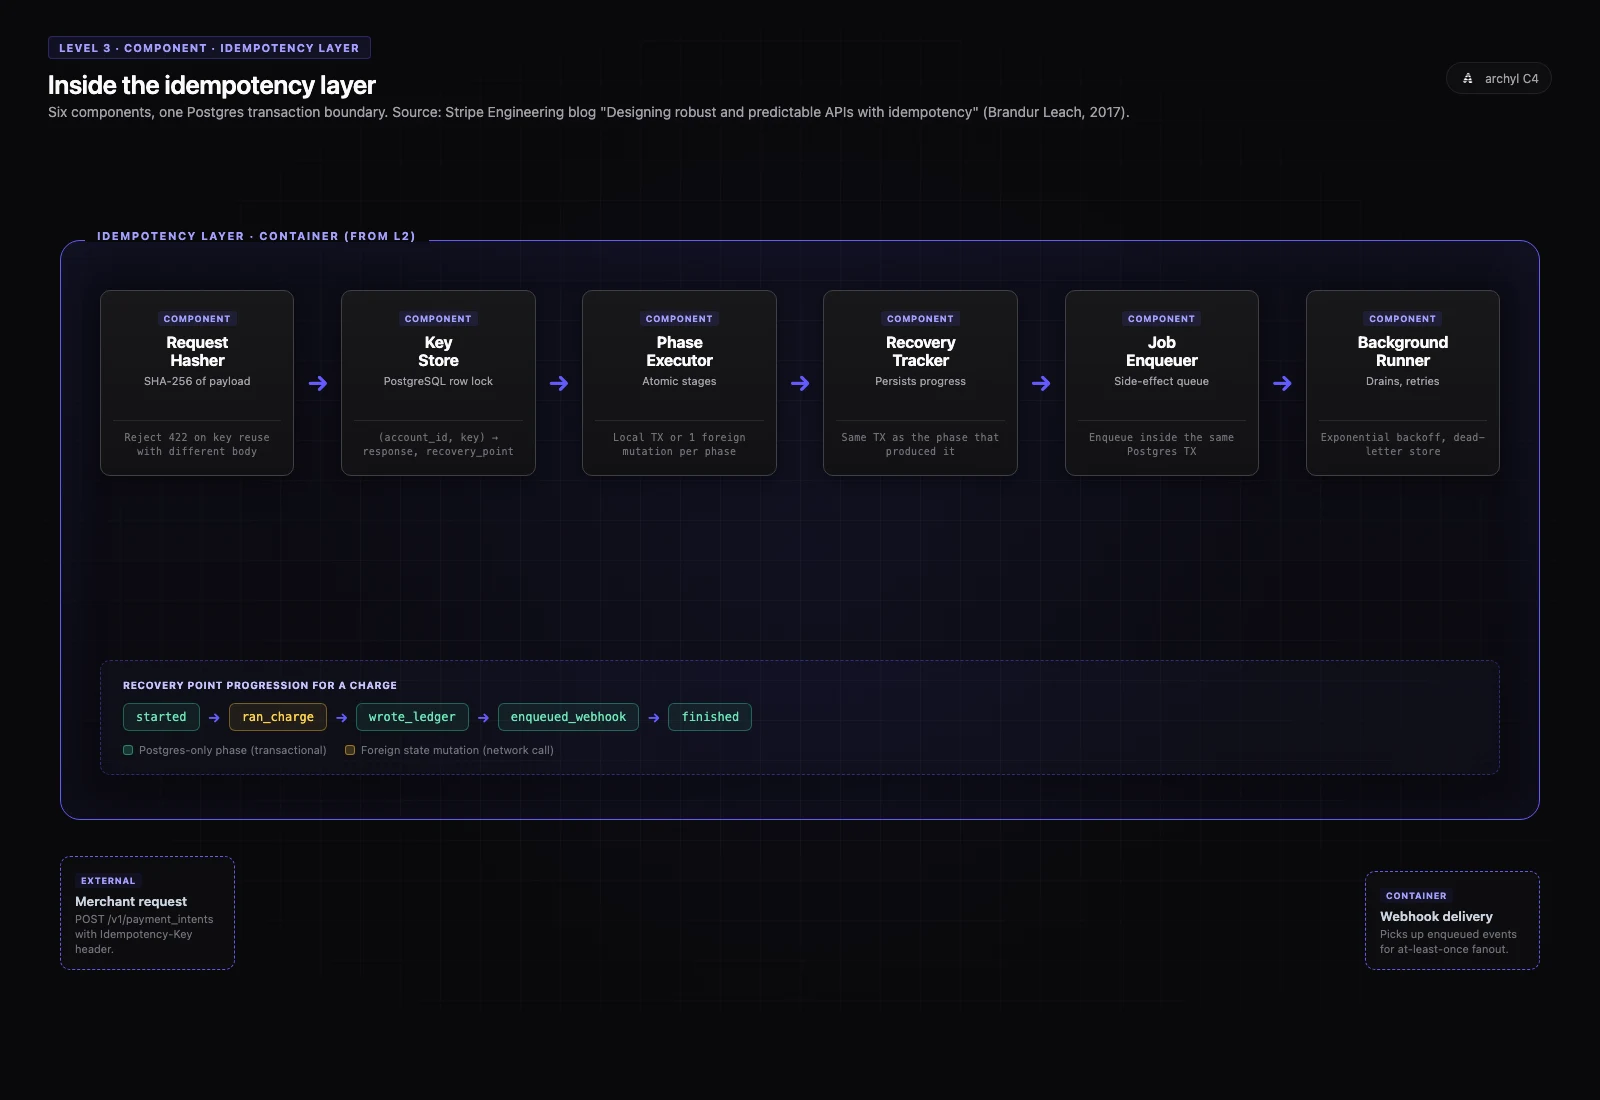
Von allen Komponenten in Stripes Stack ist die Idempotency layer die am öffentlichsten dokumentierte — Brandur Leachs Post von 2017 ist eine kanonische Referenz für Distributed-Systems-Engineers.
Ein einzelner POST /charges mit einem Idempotency-Key durchquert diese Komponenten in der Layer:
- Request hasher — berechnet einen deterministischen Hash des Request-Payloads. Wenn derselbe Idempotency-Key mit einem anderen Payload ankommt, gibt die API 422 zurück (der Client hat einen Programmierfehler gemacht).
- Idempotency key store — eine PostgreSQL-Tabelle, geschlüsselt auf
(account_id, idempotency_key). Enthältrequest_hash,response_code,response_body,recovery_point,last_run_at,locked_at. Dielocked_at-Spalte implementiert Row-Level-Locking für gleichzeitige Retries. - Phase executor — teilt die Operation in atomare Phasen, die durch Foreign State Mutations getrennt sind. Jede Phase ist entweder rein lokal (Postgres-only, transaktional mit der Idempotency-Row) oder ein einziger externer Side-Effect (Vault-Tokenize, Network-Charge, Webhook-Versand).
- Recovery point tracker — persistiert die aktuelle Phase:
started→ran_charge→wrote_ledger→enqueued_webhook→finished. Bei Retry nimmt der Executor am Recovery-Point wieder auf. - Job enqueuer — für asynchrone Side-Effects (E-Mails, Webhooks) reiht einen langlebigen Job in der gleichen Postgres-Transaktion wie das Recovery-Point-Update ein. Atomar konstruktionsbedingt.
- Background runner — entleert die Job-Queue mit eigener Retry-Semantik, Exponential Backoff und Dead-Letter-Store.
Das Pattern ist brutal einfach, sobald man es sieht: Jede lokale Mutation lebt in derselben Postgres-Transaktion wie das Idempotency-Row-Update; jede externe Mutation lebt zwischen zwei Recovery-Points. Diese Form eliminiert eine ganze Klasse von Double-Write-Bugs, die Distributed Systems plagen, die ohne diese Primitive gebaut wurden.
So sieht Component-Level C4 aus: nicht "hier ist Code", sondern "hier ist die Kette von business-bedeutsamen Primitiven, jede owned, jede ersetzbar, jede messbar".
ADR-003 · Sorbet — in einen Type-Checker investieren, Ruby nicht umschreiben
Status · Accepted (~2017, 2019 open-sourced, immer noch Default)
Kontext · Bis 2017 war Stripes Ruby + Rails Monolith über 10 Millionen Zeilen gewachsen. Der dominante Industrie-Rat für eine Fintech dieser Größe war in eine typisierte Sprache umschreiben — Java, Go oder Scala. Geschätzte Kosten: Jahre und Hunderte von Engineers. Rubys DX war derweil Stripes Wettbewerbsvorteil beim schnellen Shippen.
Entscheidung · Nicht umschreiben. Einen Gradual-Type-Checker für Ruby bauen. 18 Monate und ein kleines Team nehmen, um ein multithreaded, IDE-grade Type-System zu shippen, das auf Millionen Zeilen skaliert. Open-source.
Konsequenzen · Sorbet type-checked nun 15 Millionen Zeilen Stripe-Ruby mit Sub-Sekunden-Inkremental-Latenz. Stripe hat die Rewrite-Tax nie bezahlt. Sie haben die Erfinde-einen-Type-Checker-Tax bezahlt — einmal. Sorbet ist zu einem bedeutsamen Open-Source-Projekt geworden, genutzt von Coinbase, Shopify, GitHub und anderen.
In einem Archyl-Modell reisen ADRs wie diese mit der Architektur. Wenn du 2026 in den Apiori-Container klickst und "Ruby + Sorbet" siehst, siehst du auch die Entscheidung von 2017, die erklärt, warum es nicht Java ist.
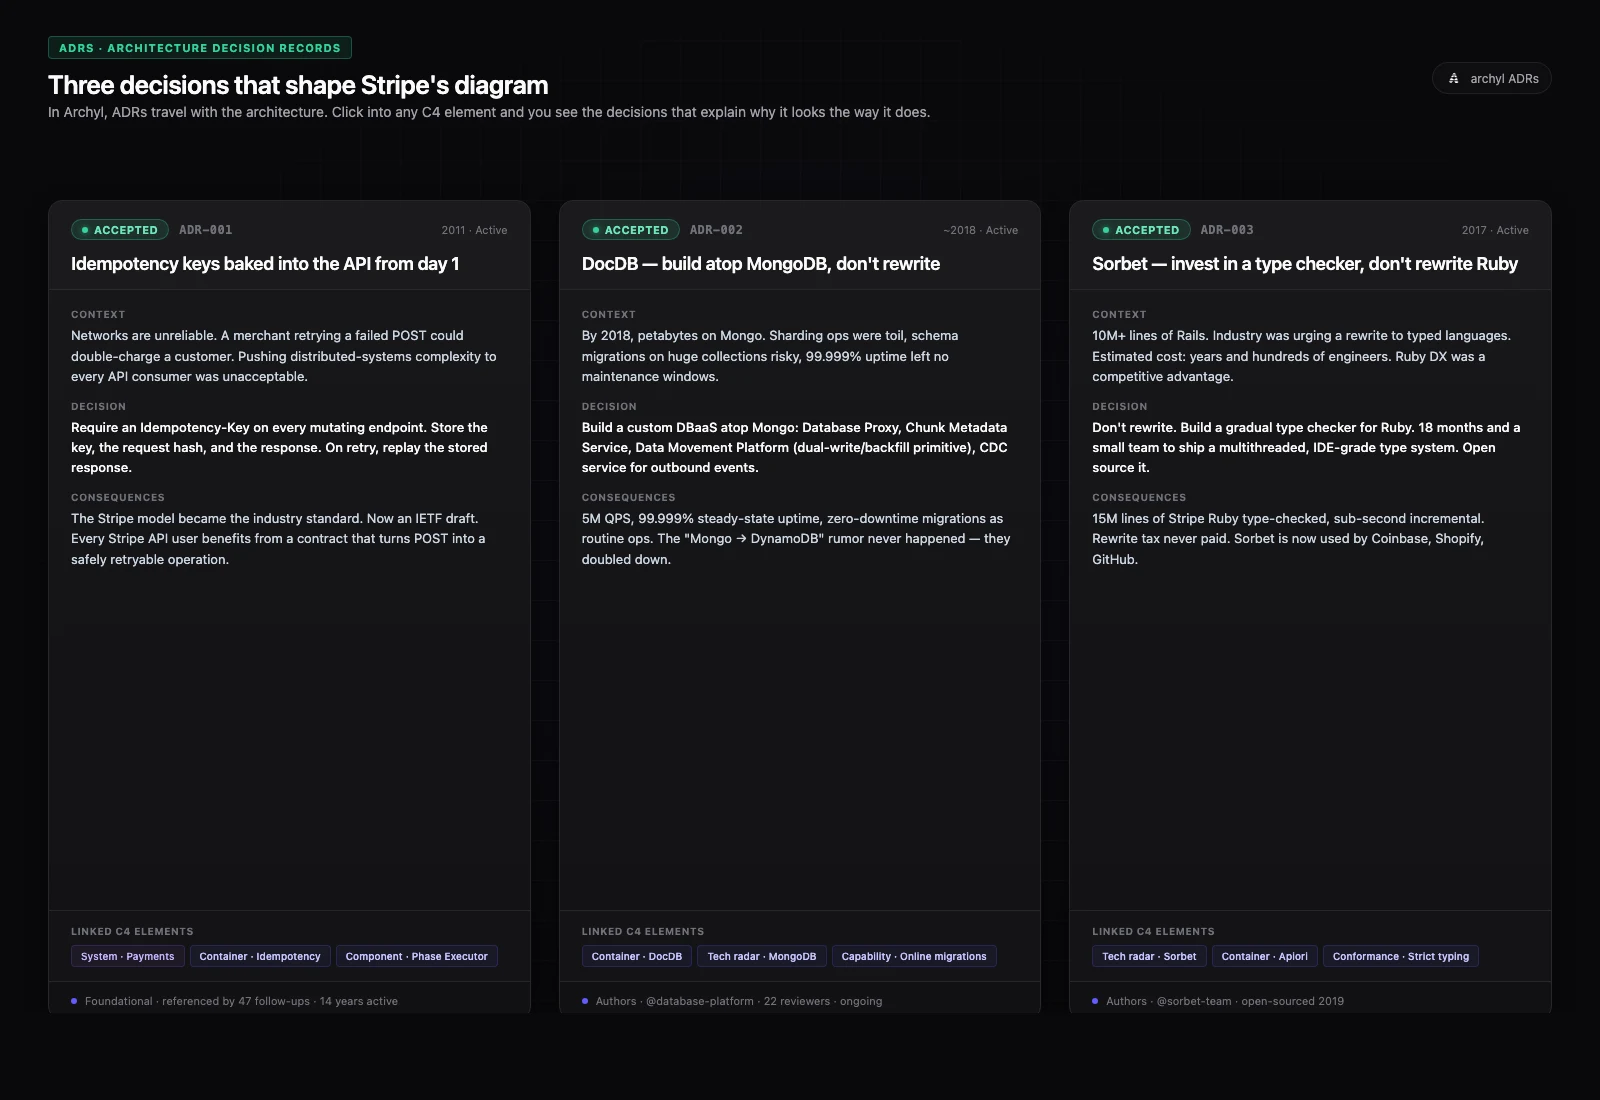
Drei Entscheidungen. Drei Cards in Archyl, jede mit den C4-Elementen verknüpft, die sie formt — Idempotency-Keys mit jedem mutierenden Endpoint, DocDB mit dem Daten-Layer, Sorbet mit jedem Ruby-Container. Das Diagramm ist die Gegenwart; die ADRs sind das Warum.
Ownership: ein Modell in Verantwortlichkeit verwandeln
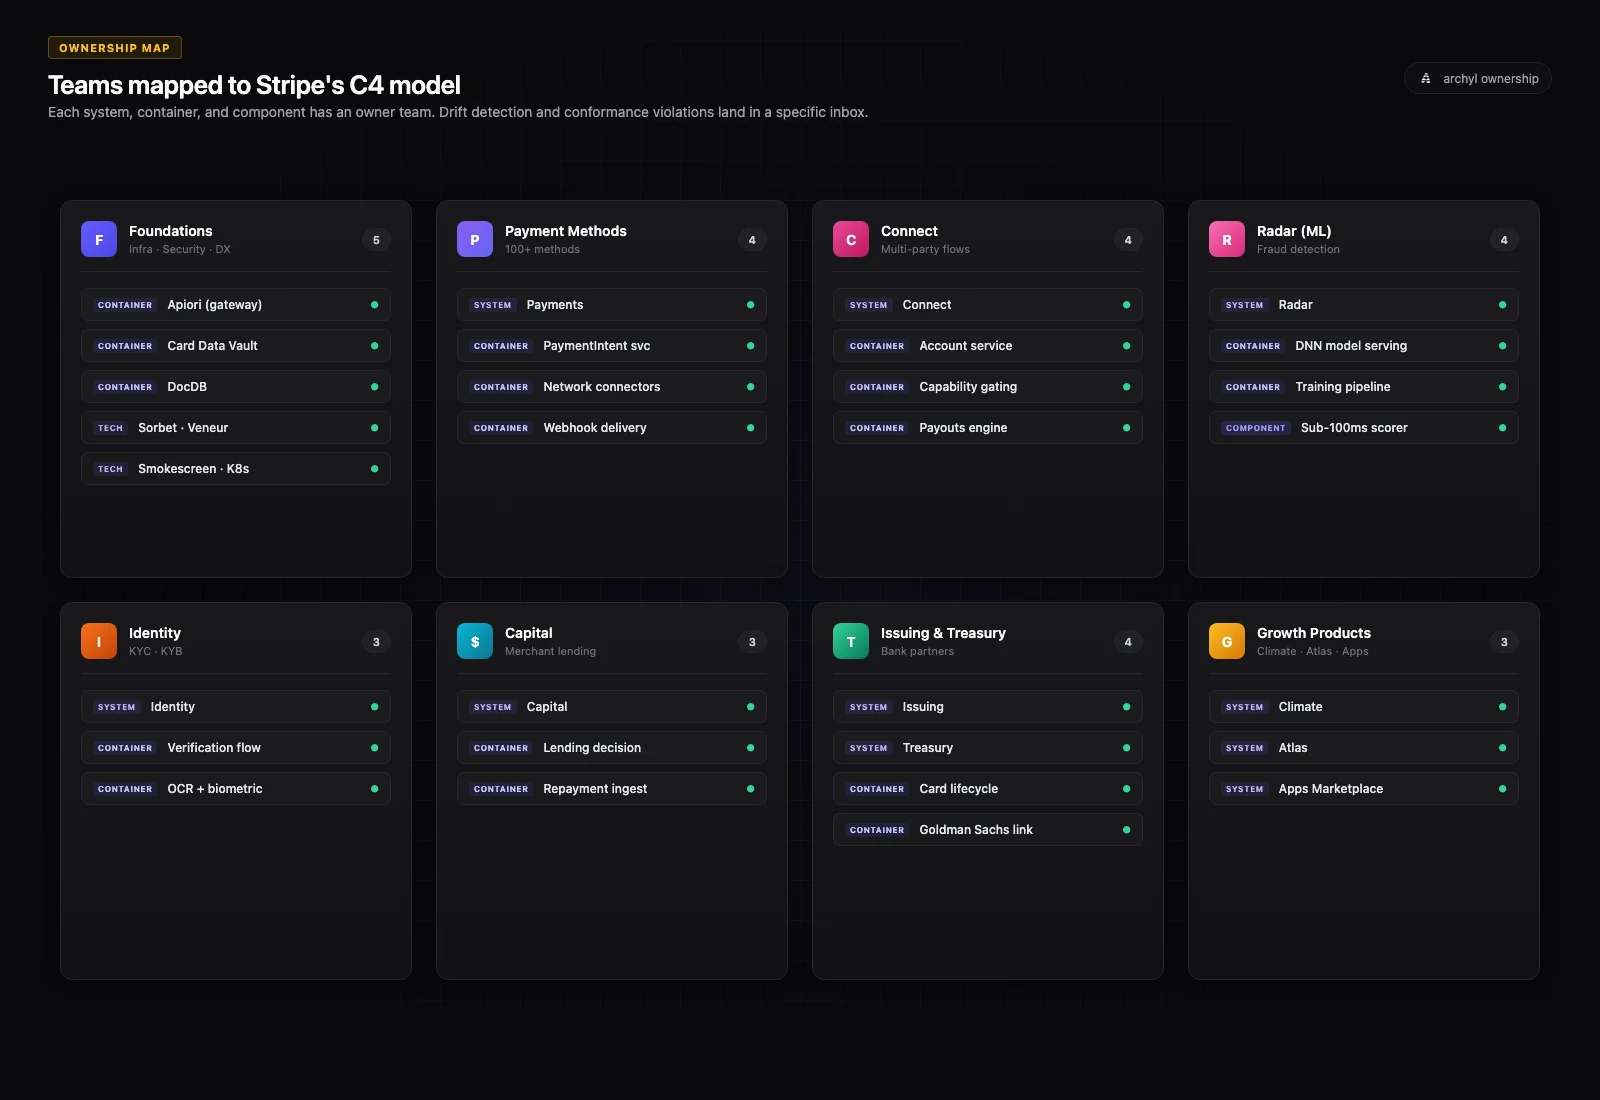
Ein C4-Modell ist ein statisches Artefakt, bis du Teams ihm zuordnest.
Stripe kommuniziert öffentlich über seine Engineering-Struktur: eine starke Foundations-Gruppe (Infrastructure, Security, Data Platform, Developer Experience), Produkt-Teams ausgerichtet auf jedes Hauptsystem (Payment Methods, Connect, Capital, Identity, Issuing, Treasury, Climate, Radar) und cross-cutting Gruppen für ML und Observability.
Setze sie auf das C4-Modell:
- Foundations besitzt Apiori, Sorbet, Veneur, Smokescreen, die Kubernetes-Plattform, DocDB, Card Data Vault — das Substrat, auf dem jedes Produkt baut
- Payment Methods besitzt die Network connectors, die PaymentIntent-State-Machine, die Per-Methode-Services (Karten, ACH, SEPA, Wallets)
- Connect besitzt den Account Service, Capability Gating, Multi-Party-Funds-Flows, Payouts
- Capital besitzt die Lending-Decision-Pipeline und die Integration mit der Stripe-Payments-Historie des Merchants
- Identity besitzt die KYC/KYB-Workflows und das Compliance Gating für Connect-Onboarding
- Radar (ML-Team) besitzt das Fraud-DNN, das Model Serving, die Training Pipelines
- Issuing & Treasury besitzen die Bank-Partner-Integrationen und das Card-Lifecycle
- Climate besitzt die Integration mit dem Carbon-Offsetting-Marketplace
Diese Zuordnung ist keine Dekoration. Sie ist das Substrat für alles, was danach kommt.
Sobald ein System, Container oder Komponente einen Team-Eigentümer hat, wird Drift-Detection verantwortlich: Wenn ein neuer Service in Commits auftaucht und nicht im Diagramm ist, wird ein spezifisches Team gefragt. Wenn eine Konformitätsregel verletzt wird (ein nicht-Foundations-Service, der versucht, direkt vom Card Data Vault zu lesen, etwa), gibt es einen Namen in einer Inbox.
In Archyl ist die Ownership Map der Moment, in dem aus einem Doku-Tool ein Governance-Tool wird.
Drift, Konformität und der wöchentliche Digest
Ein Modell dieser Größe wird driften. Neue Produkte landen — Climate 2022, Treasury, Tax-Erweiterungen, Apps Marketplace. Stacks ändern sich — Apiori-Pfade migrieren zu Go, Pinot ersetzt älteres Analytics, Sorbet-Strictness steigt.
Archyl berechnet einen Drift-Score wöchentlich: die Lücke zwischen dem dokumentierten C4-Modell und dem, was aktuell im Code ist. Konformitätsregeln fügen den Policy-Layer hinzu — "jeder Container braucht ein Eigentümer-Team", "nur Foundations-Services können Card Data Vault lesen", "jede öffentliche API-Änderung muss ein API-Versioning-ADR referenzieren".
Für Stripe ist das Drift-Detection in der Größenordnung von fünfzehn Millionen Zeilen und 27 000 Requests pro Sekunde. Die Regeln sind dieselben wie für zehn Services.
Und der Architektur-Team-Digest, den wir kürzlich ausgeliefert haben, würde in einem Stripe-ähnlichen Setup heißen:
- Foundations' Montag-Digest deckt Apiori, das Vault, DocDB, die K8s-Plattform ab
- Payment Methods' Digest deckt Network connectors, den PaymentIntent service, jede Per-Methode-Integration ab
- Radars Digest deckt das Fraud-DNN, Training Pipelines, Model-Rollouts ab
- Jeder Digest gescoped auf den Perimeter, den sein Team besitzt
Gleiche Oberfläche. Verschiedene Scopes. Das ist die Symmetrie, die C4 + Ownership freischalten.
Du musst keine Billion Dollar verarbeiten
Du bist nicht Stripe. Die meisten Engineering-Organisationen sind es nicht.
Aber die Lektion skaliert auch nach unten. Die Disziplin, Context von Container von Component zu trennen, das ADR zu schreiben, das eine path-dependent Entscheidung erklärt (wir haben auf Mongo aufgebaut, wir haben Ruby type-checked statt umzuschreiben), jeder Box Ownership zuzuordnen — diese Disziplin ist es, die einen Stack von fünfzig Services davon abhält, sich wie fünfzehn Millionen Zeilen anzufühlen.
C4 + ADRs + Ownership + Drift + Konformität ist das, was Archyl dir out of the box gibt. Das Stripe-Beispiel ist nur der größte plausible Stress-Test des Modells im Bereich Finanzsysteme.
Öffne deine eigene Architektur. Skizziere fünfzehn Produkte (oder drei, wenn du drei hast). Wähle das mit den überraschendsten vergangenen Entscheidungen und zoome in seine Container. Schreibe drei ADRs, die einem neuen Mitarbeiter erklären, was ihn ratlos lassen würde. Ordne jedem Container ein Team zu.
Du wirst weiter sein als die meisten Engineering-Organisationen in einem Jahr.
Willst du deine eigene Architektur in C4 modellieren? Starte mit Archyl. Lies auch warum ADRs und C4 besser zusammen funktionieren oder wie Architecture Change Requests Pull-Request-Disziplin in dein C4-Modell bringen. Die vorherige Case Study modellierte Netflix in C4 — Anatomie eines Plays.